皆さん、こんにちは。
SB C&S 技術担当の河村です。
昨年の速報からあっという間に1年が経ちました。
今年もやります!
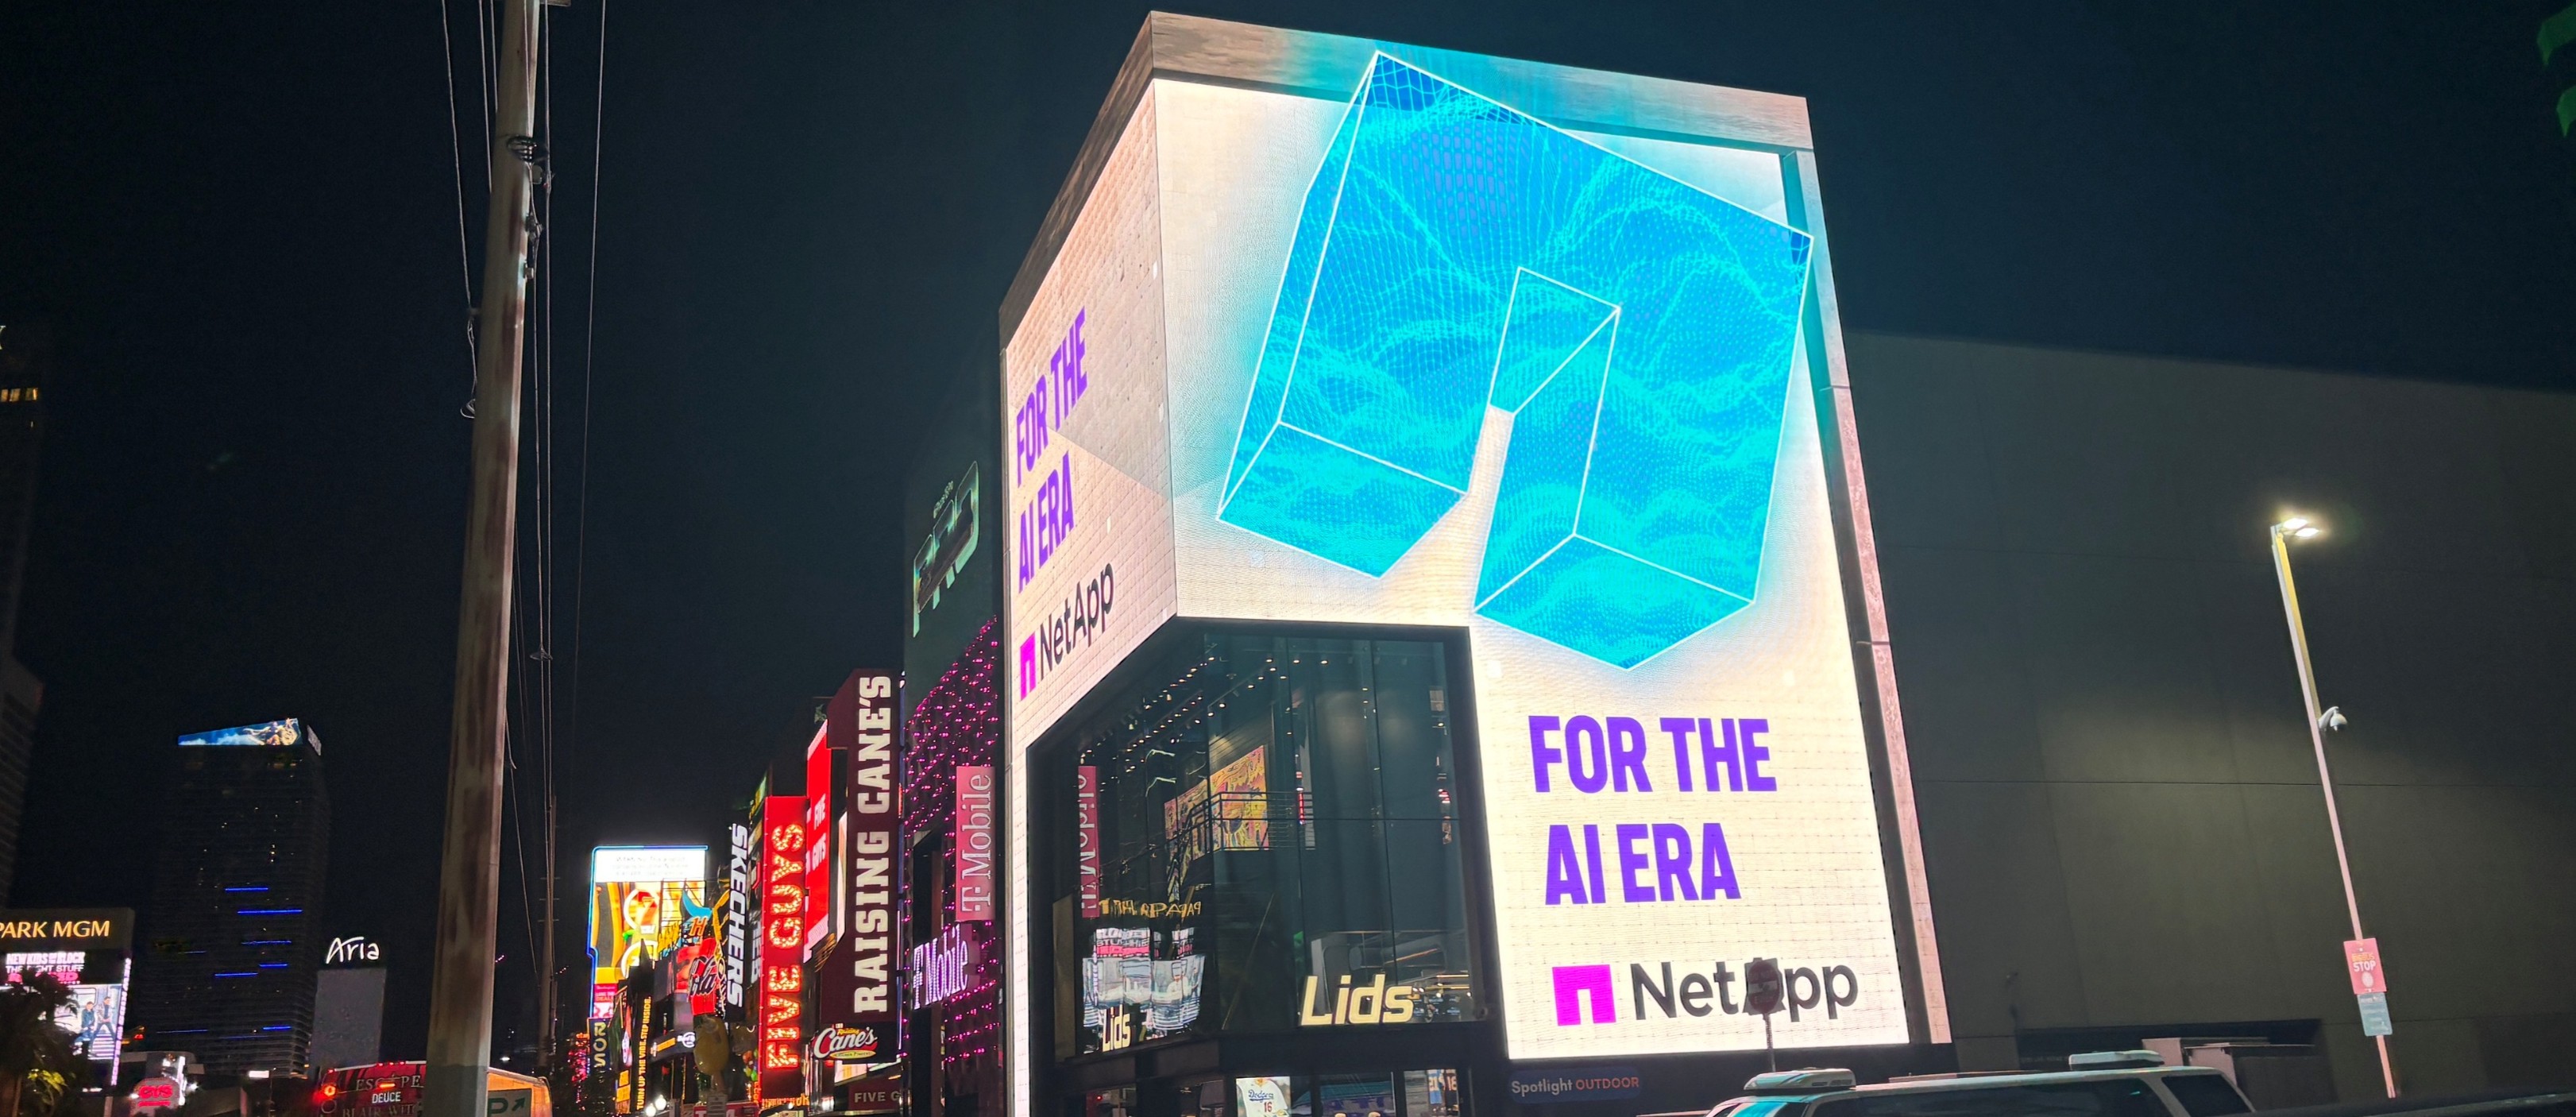
SB C&Sがお届けする世界一速いNetApp INSIGHTの超速報レポートです!!!
2023年からスタートしたラスベガス現地レポートも、今回で4年目となりました。
今年も現地の空気感とともに、NetAppから発表された最新情報を、できる限り丁寧かつ分かりやすく整理してお届けしたいと思います!
NetApp社にて毎年行われる大規模カンファレンスイベント「NetApp INSIGHT」
今年は9/29~10/1の3日間にわたり、ラスベガスのMGM Grand Las Vegasで開催されています。
今年はAIファクトリー向けの新しいストレージアーキテクチャをはじめ、例年以上に大きな発表があると聞いていたため、どのような内容になるのか期待しながら会場入りしました。
NetApp INSIGHT 2026の公式サイトはこちらです。
※昨年のNetApp INSIGHT 2025については、こちらの記事で紹介していますので、是非チェックしてください。
| NetApp INSIGHT 2026 開催概要 |
NetApp INSIGHTは、NetAppの最新製品やテクノロジーだけでなく、お客様の導入事例、パートナー企業との連携情報、ハンズオン、認定試験など、NetAppに関するさまざまな情報を一度に体験できるカンファレンスイベントです。
会場はSession AreaとThe Garageに分かれており、Session AreaではKeynote用の大型会場だけでなく、Breakout Session用の個別会場やハンズオン専用ルームなどの施設があります。
The Garage(前回はFestival Grounds)には、NetAppやパートナー企業による製品展示やデモが並び、製品担当者やエキスパートへ直接質問ができます。
また、ブースに立ち寄って各社が実施しているゲームにチャレンジすることで、ノベルティを入手することができ、イベント限定のグッズなどを集めるのも楽しみの1つになっています。
本記事では、イベントの中心となるKeynoteで発表されたNetAppのビジョンと最新情報を中心にご紹介します。
※本イベントでは、正式リリース済みの製品だけでなく、今後の計画や構想段階の内容も紹介されるため、予告なく変更される可能性があることについてご留意ください。
| Keynote Day1 |
NetAppのAIに対するビジョン
Keynote初日は、NetAppのCEOであるGeorge Kurian氏の登壇からスタートします。George Kurian氏は、AIが検証フェーズから本番利用へ移行し、企業のあらゆるワークロードへ組み込まれていく中で、GPUやAIモデルだけでなく、データ基盤そのものを見直す必要があるというメッセージを発信しました。
AIの成功を左右する2つの課題
George Kurian氏は、多くの企業がAIを本番環境へ移行できていない理由として、大きく2つの課題を挙げました。
- インフラの課題
大規模なGPUクラスターへ、学習や推論に必要なデータを途切れることなく供給すること - データの課題
企業内に分散したデータを発見し、意味を理解し、適切なガバナンスのもとでAIから利用できるようにすること
AIというと、高性能なGPUや大規模言語モデルに注目が集まりがちです。
しかし、どれだけ高価なGPUを大量に用意しても、学習や推論に必要なデータを継続的に供給できなければ、GPUはデータ待ちの状態となり、本来の性能を発揮できません。
George Kurian氏からは、AIを取り巻く変化を示す具体的な数値も紹介されました。
- 大規模言語モデルの規模は、わずか4年間で5,000倍に拡大
- 93%の組織が、少なくとも1つのデータ課題によってAI活用を妨げられていると回答
- 企業データのうち、ERPやCRMなどの構造化システムに存在するデータは一般的に15%未満
- 残る約85%は、設計資料、研究データ、運用ファイル、映像、シミュレーション結果、メール、チャット、会議データなどの非構造化データ
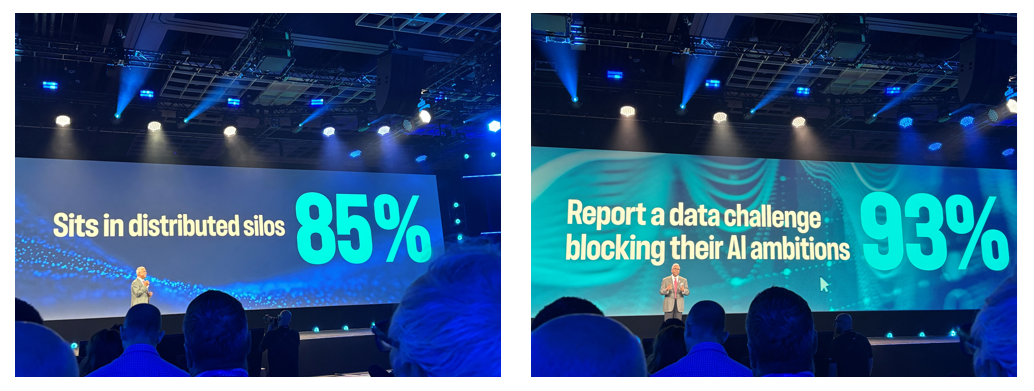
企業がAIで本当に活用したいデータの多くは、オンプレミス、クラウド、ファイルサーバー、オブジェクトストレージ、メールやコラボレーションツールなど、さまざまな場所へ分散しています。
その結果、利用できるはずのデータが見つからない「ダークデータ」、環境ごとに異なる運用や保護、増え続けるサイバー攻撃、国や地域ごとのデータ主権といった課題が発生すると警鐘を鳴らしました。
AIエージェントに必要な「Memory」と「Context」
George Kurian氏は、今後広がっていくAIエージェントについて、人間が判断する際と同じように「Memory」と「Context」が必要だと説明しました。
- Memory:企業がこれまで蓄積してきたデータ
- Context:そのデータが何を意味し、どのような背景や関係性を持つのかを示す情報
- Knowledge:MemoryとContextを組み合わせ、継続的に学習することで生まれる知識
NetAppは、長年保存・保護してきた企業データを「デジタル上のMemory」と位置付け、メタデータやナレッジグラフによってContextを加えることで、AIが安全かつ適切に利用できるKnowledgeへ変換しようとしています。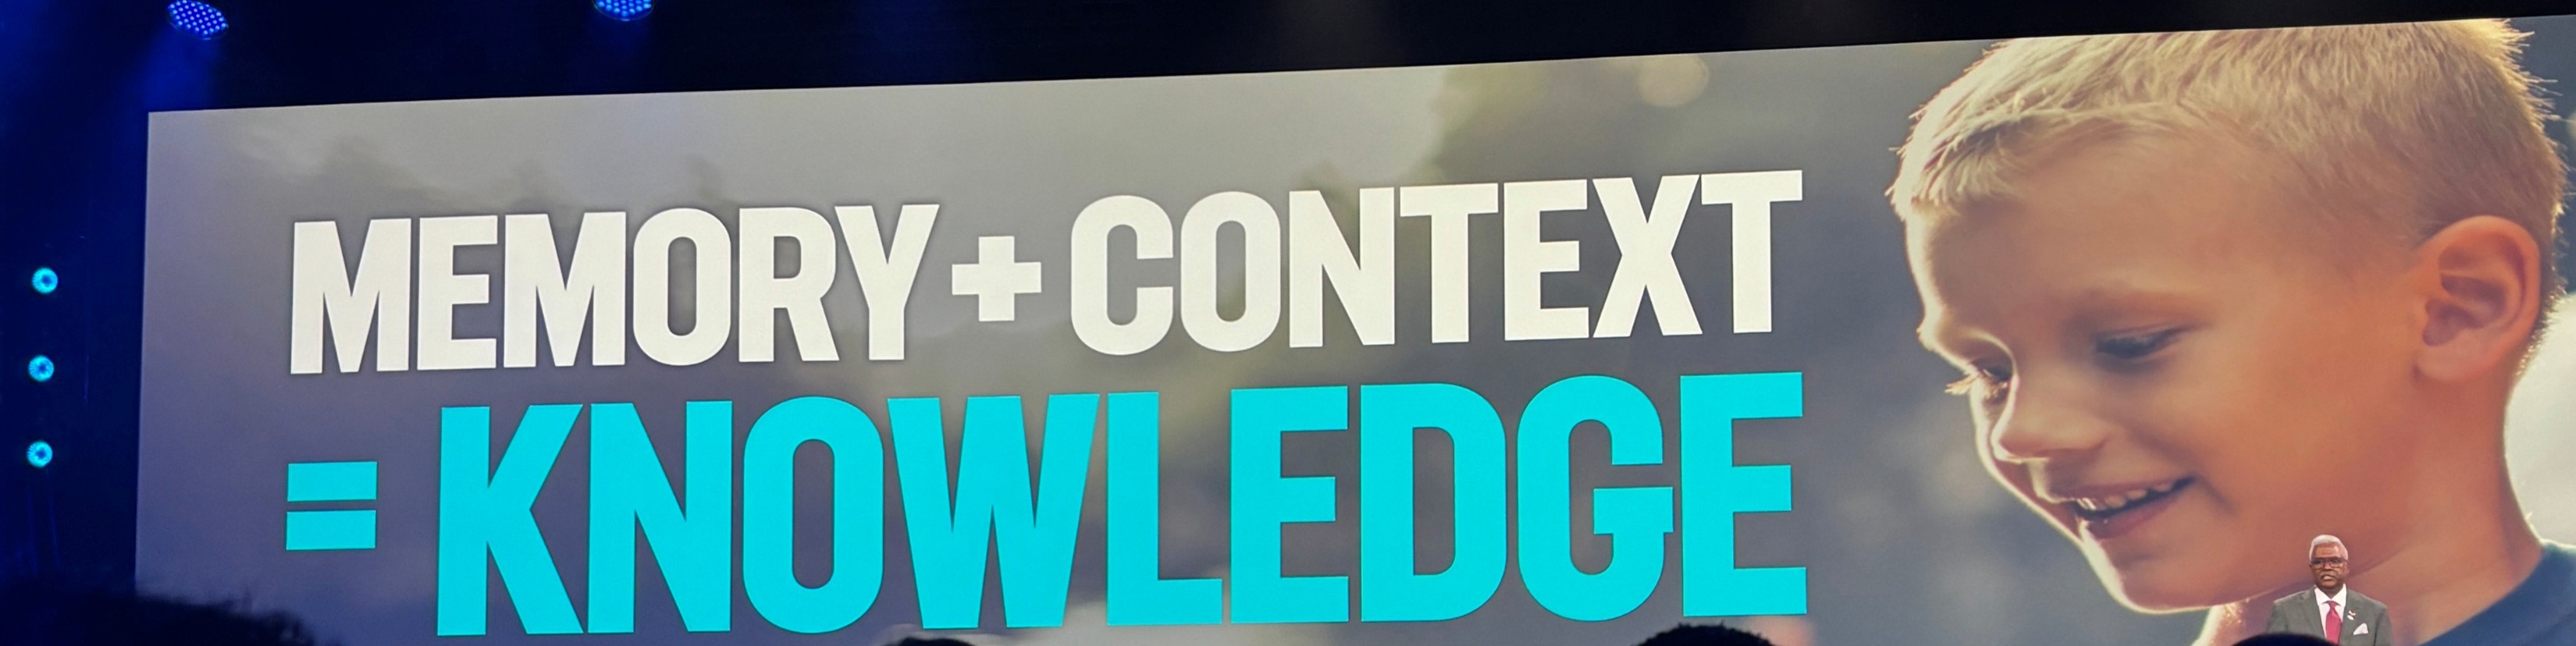
そして、これを実現するNetApp Platformの4つの役割として、以下が示されました。
- AI Ready Data:データをAIから利用できる状態にする
- Unified Storage:環境やプロトコルを問わず、さまざまなワークロードを扱う
- Proactive Protection:データを継続的かつ自律的に保護する
- Complete Control:分散したデータ基盤を1つの管理プレーンから制御する
2024年のINSIGHTでAIに関するビジョンが示された時から一貫していますが、NetAppは単にAI向けの高速ストレージを提供するのではなく、企業がすでに保有しているデータを移動・複製せず、その場所で安全に活性化し、AIから利用できる状態へ変えることを目指しているのだと強く感じました。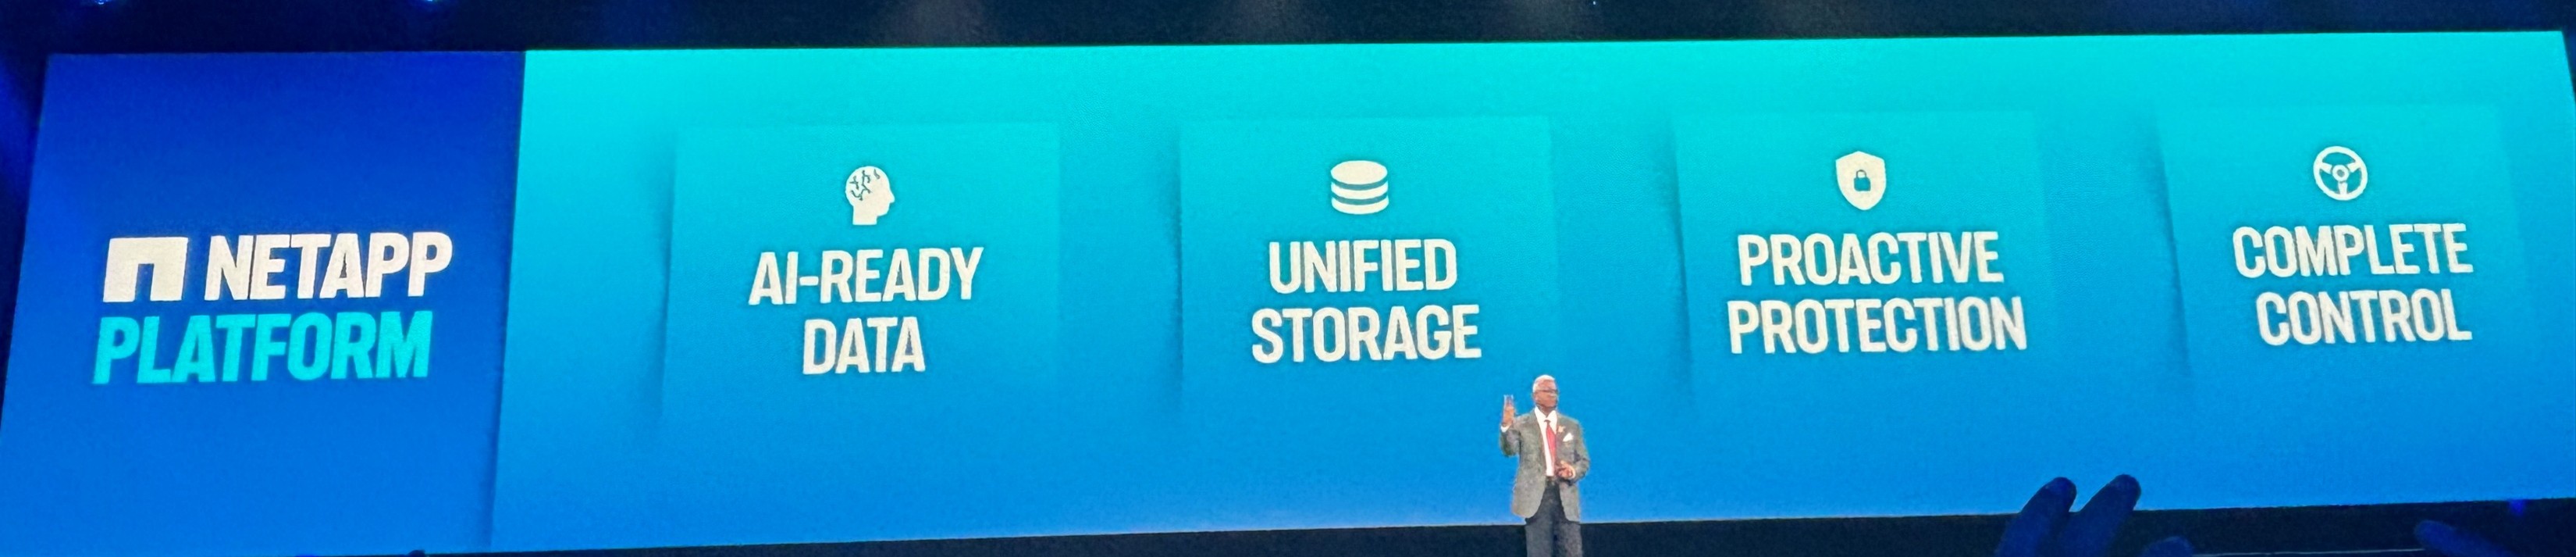
ここからは、このビジョンを実現する具体的な製品アップデートをご紹介します。
AIDEは、あらゆるデータを対象とするソフトウェア基盤へ
ここでスピーカーがEVP and CPOのSyam Nair氏に変わり、各製品のアップデートに関する発表が始まります。
今回の重要な発表となる1つ目は、昨年発表されたNetApp AI Data Engine(以下、AIDE)についてのアップデートでした。
AIDEは、企業内のデータを「探索」「維持」「統制」「変換」し、データをAIから利用できる状態にするためにNetAppが開発を行っているAI専用のデータ管理ソフトウェアです。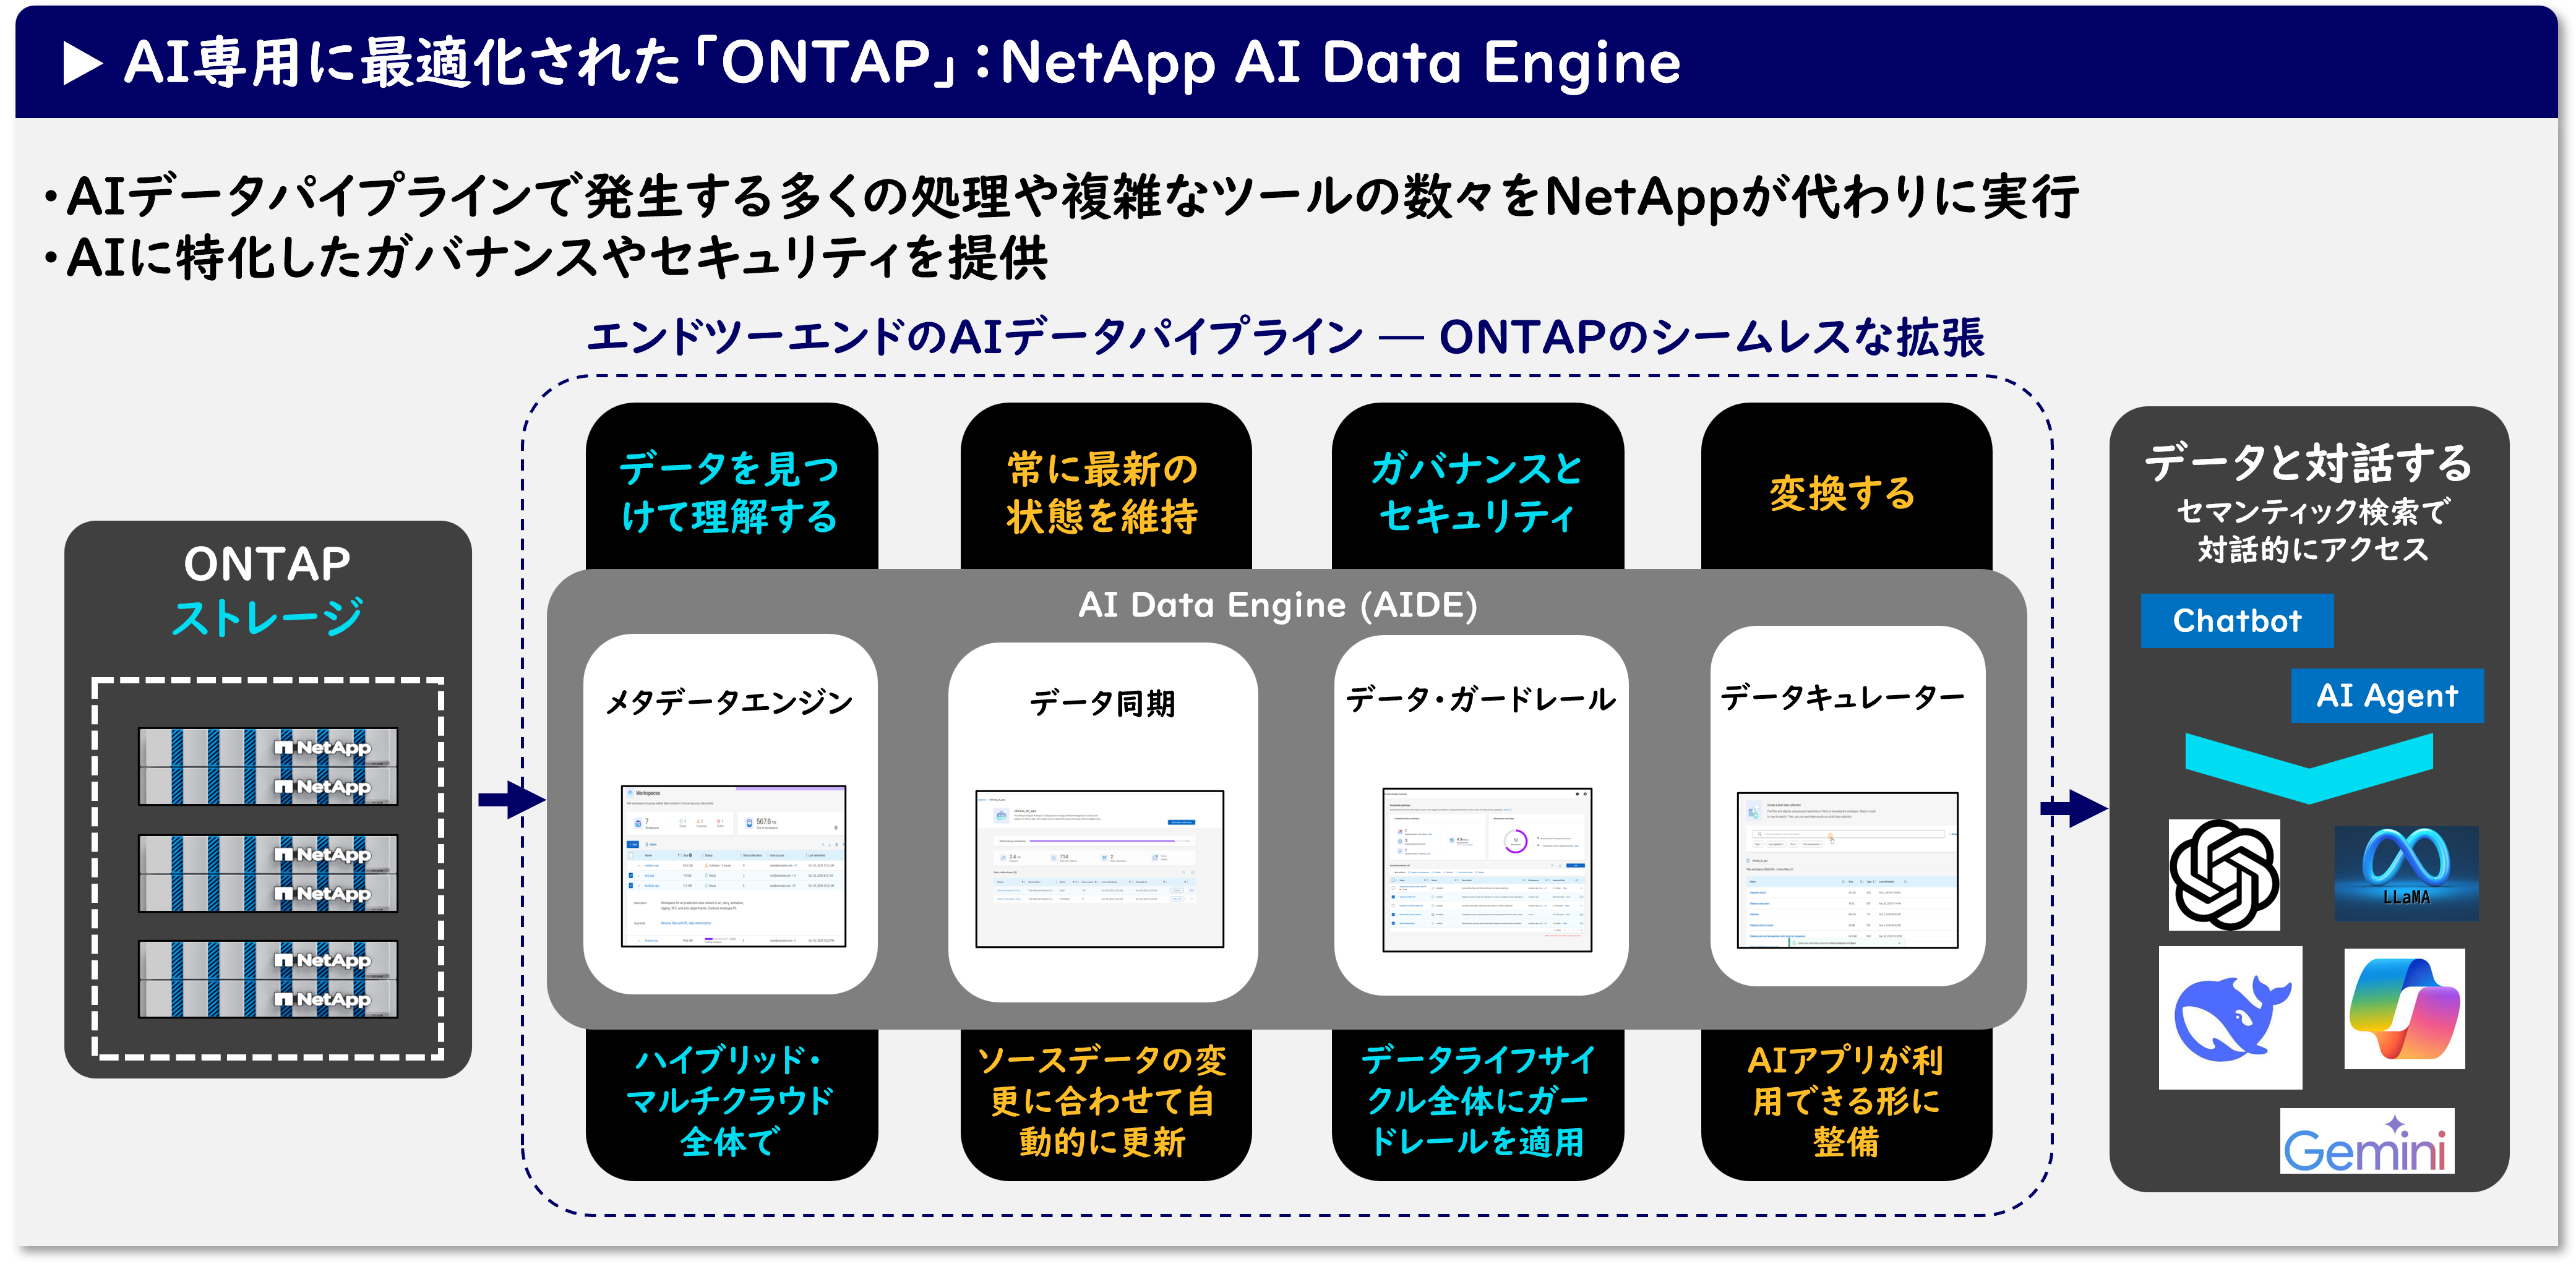
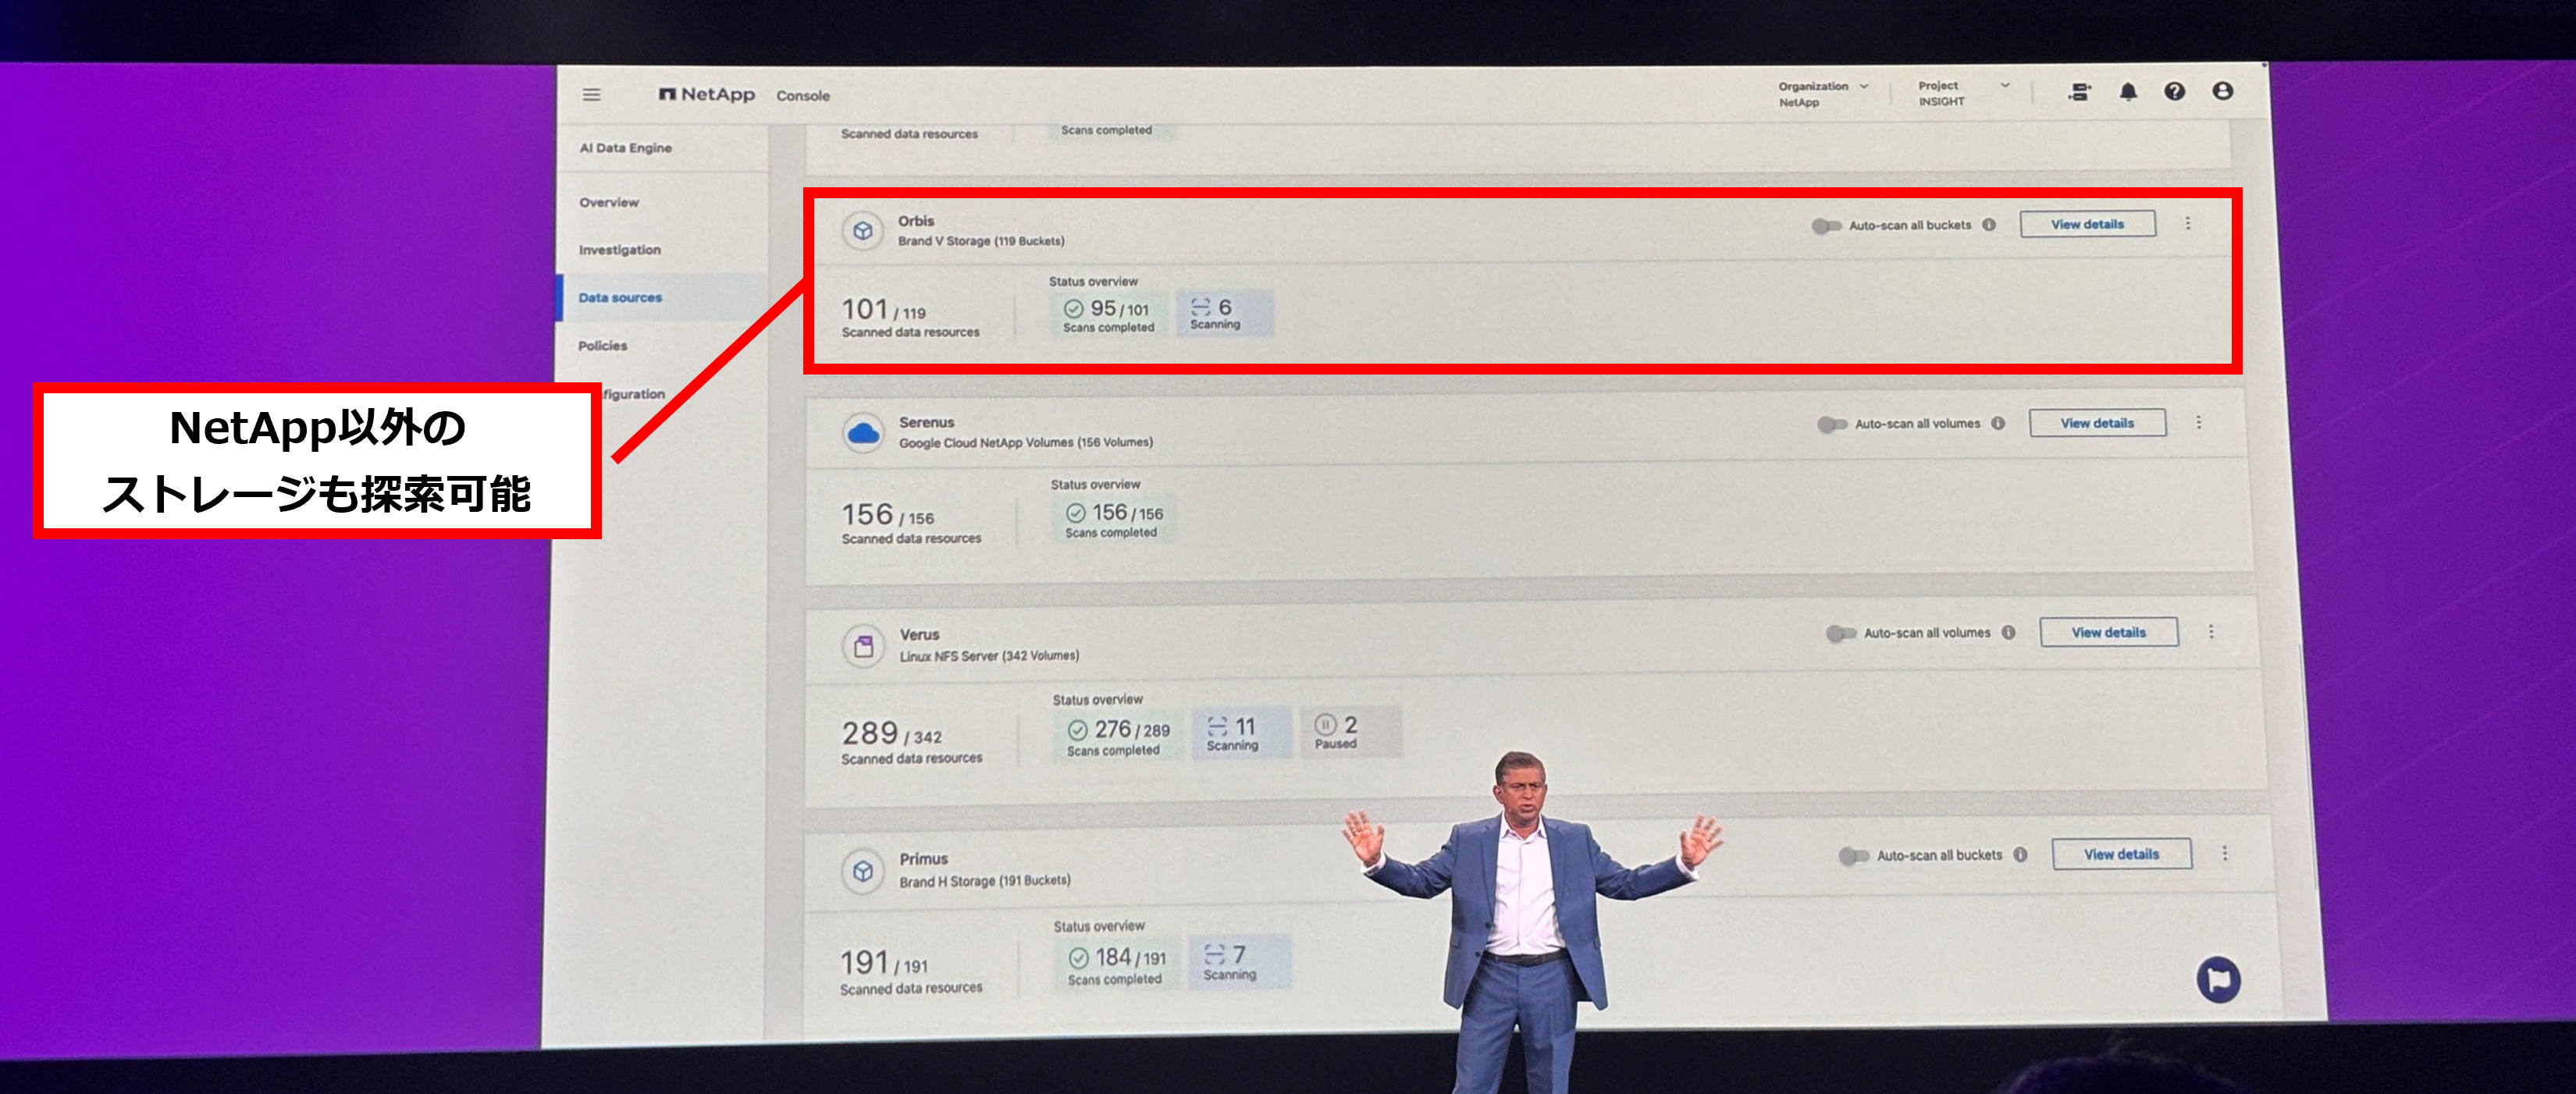
これまでAIDEは、AFXシリーズの専用ノード「DX50」へインストールされると公表されていましたが、今回のアップデートによって、AIDEは完全なソフトウェア定義型へと進化し、NetAppストレージに限らず、他社ストレージなどの異種データソースに保存されたデータ(SMB、NFS、S3)も対象にできるようになりました。
これにより、複数の異なるストレージが混在する環境でも、個別に分断された状態ではなく、様々なデータを1つのカタログとして整理/扱うことができます。
AIDEが目指す「ゼロコピーのデータ活性化」は、データを動かすのではなく、AIをデータが存在する場所へ近づける考え方です。
この方向性は、NetAppが長年提唱してきたデータファブリックとも非常に相性が良いと感じました。
なお、NetAppの公式サイトによると、現段階ではメタデータ管理に関する機能のみがGAされており、もともと想定されていたガードレールやキュレーターといった機能はプレビュー段階となり、今後のアップデートにより順次追加されていくようです。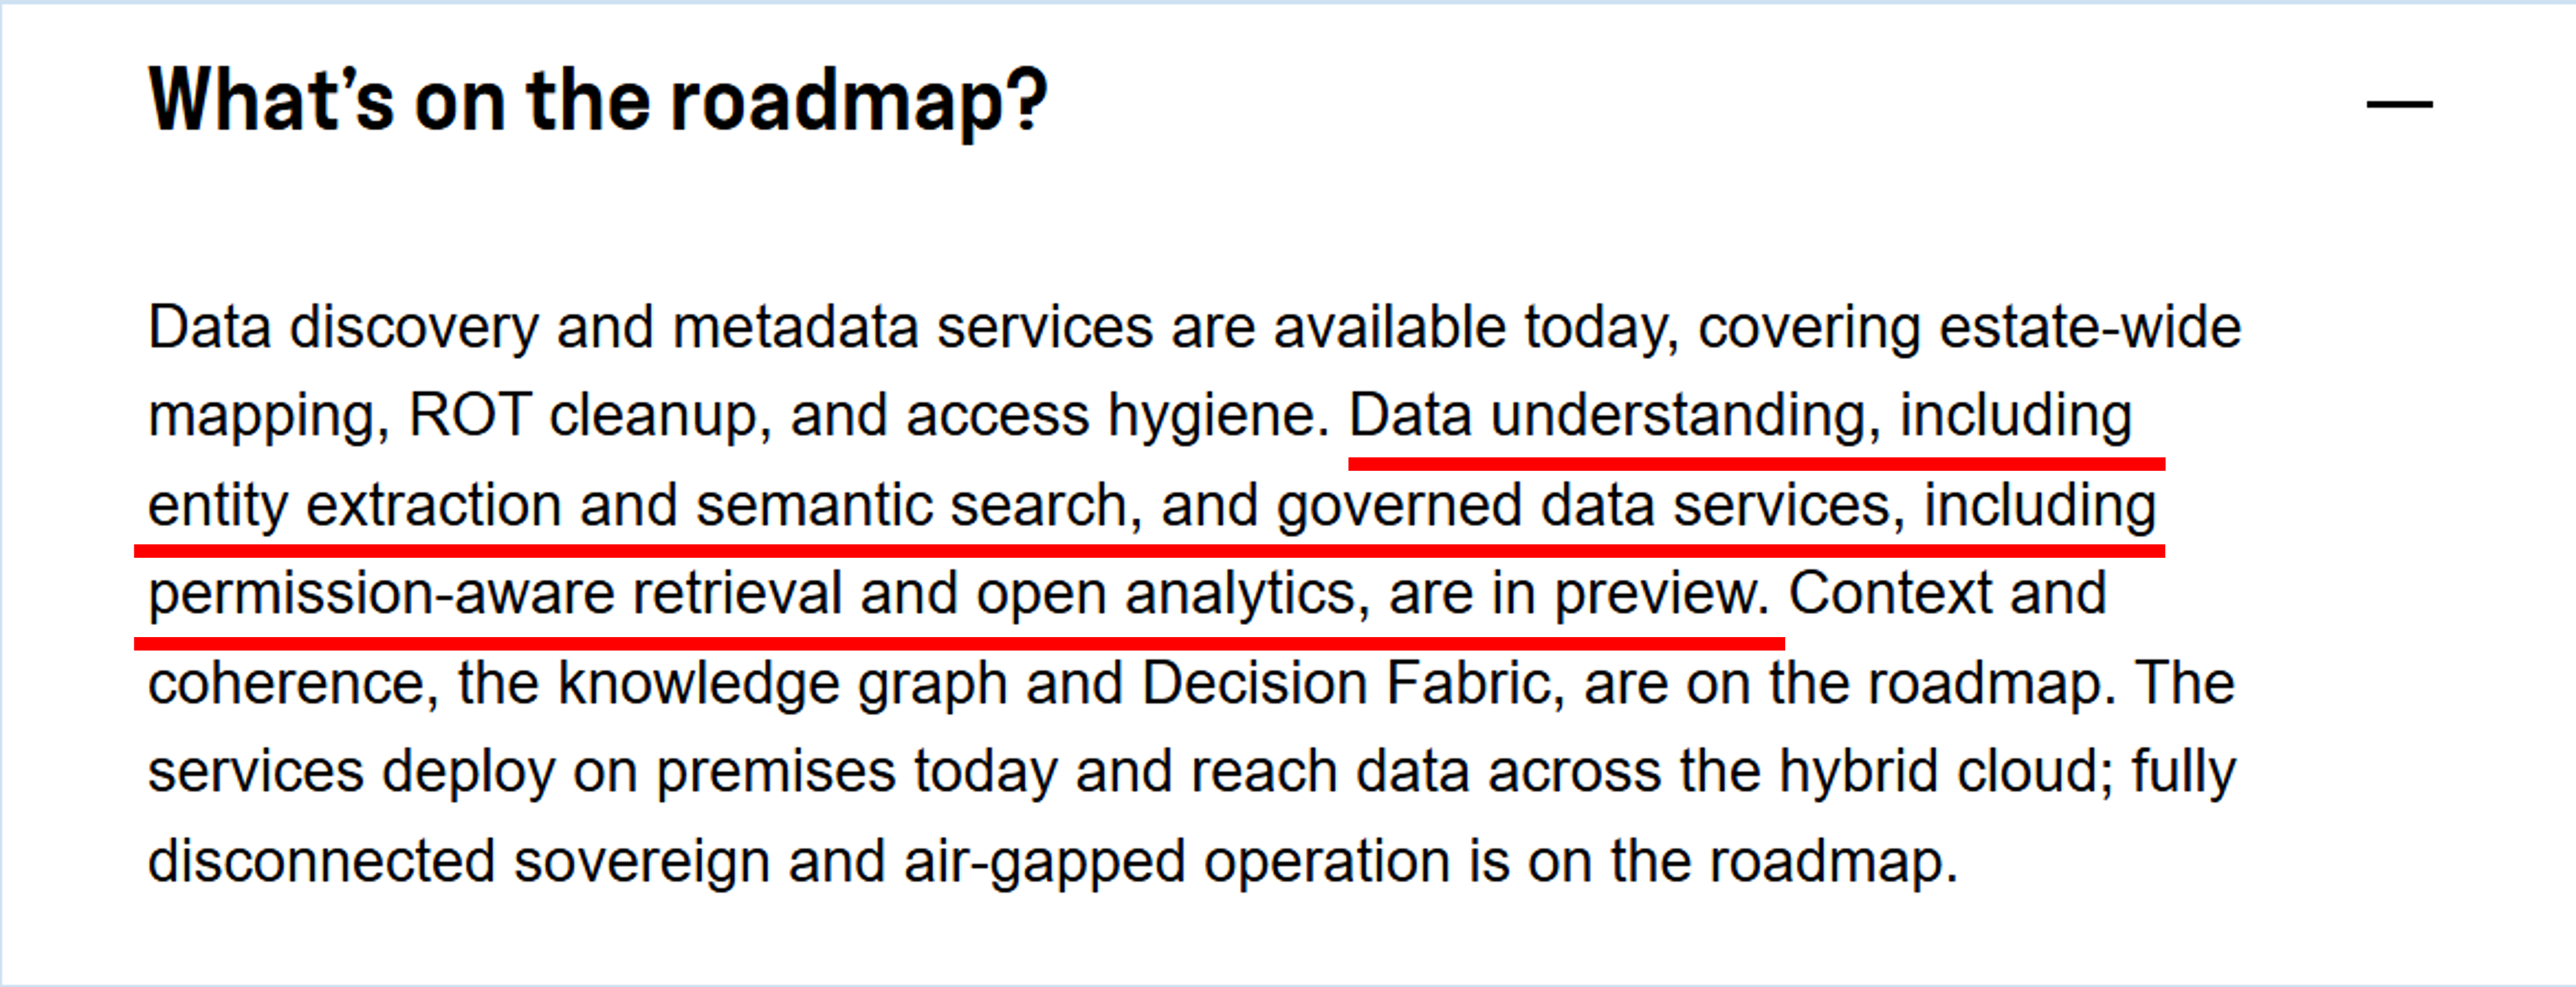
AIDEがソフトウェア定義化されたことにより、新たに「AIDE Lite」「AIDE Enterprise」という2つのデプロイメント形態が用意されそました。
それぞれの形態にSmall、Medium、Largeという3種類のデプロイサイズがあります。
【AIDE LiteとAIDE Enterpriseの棲み分け】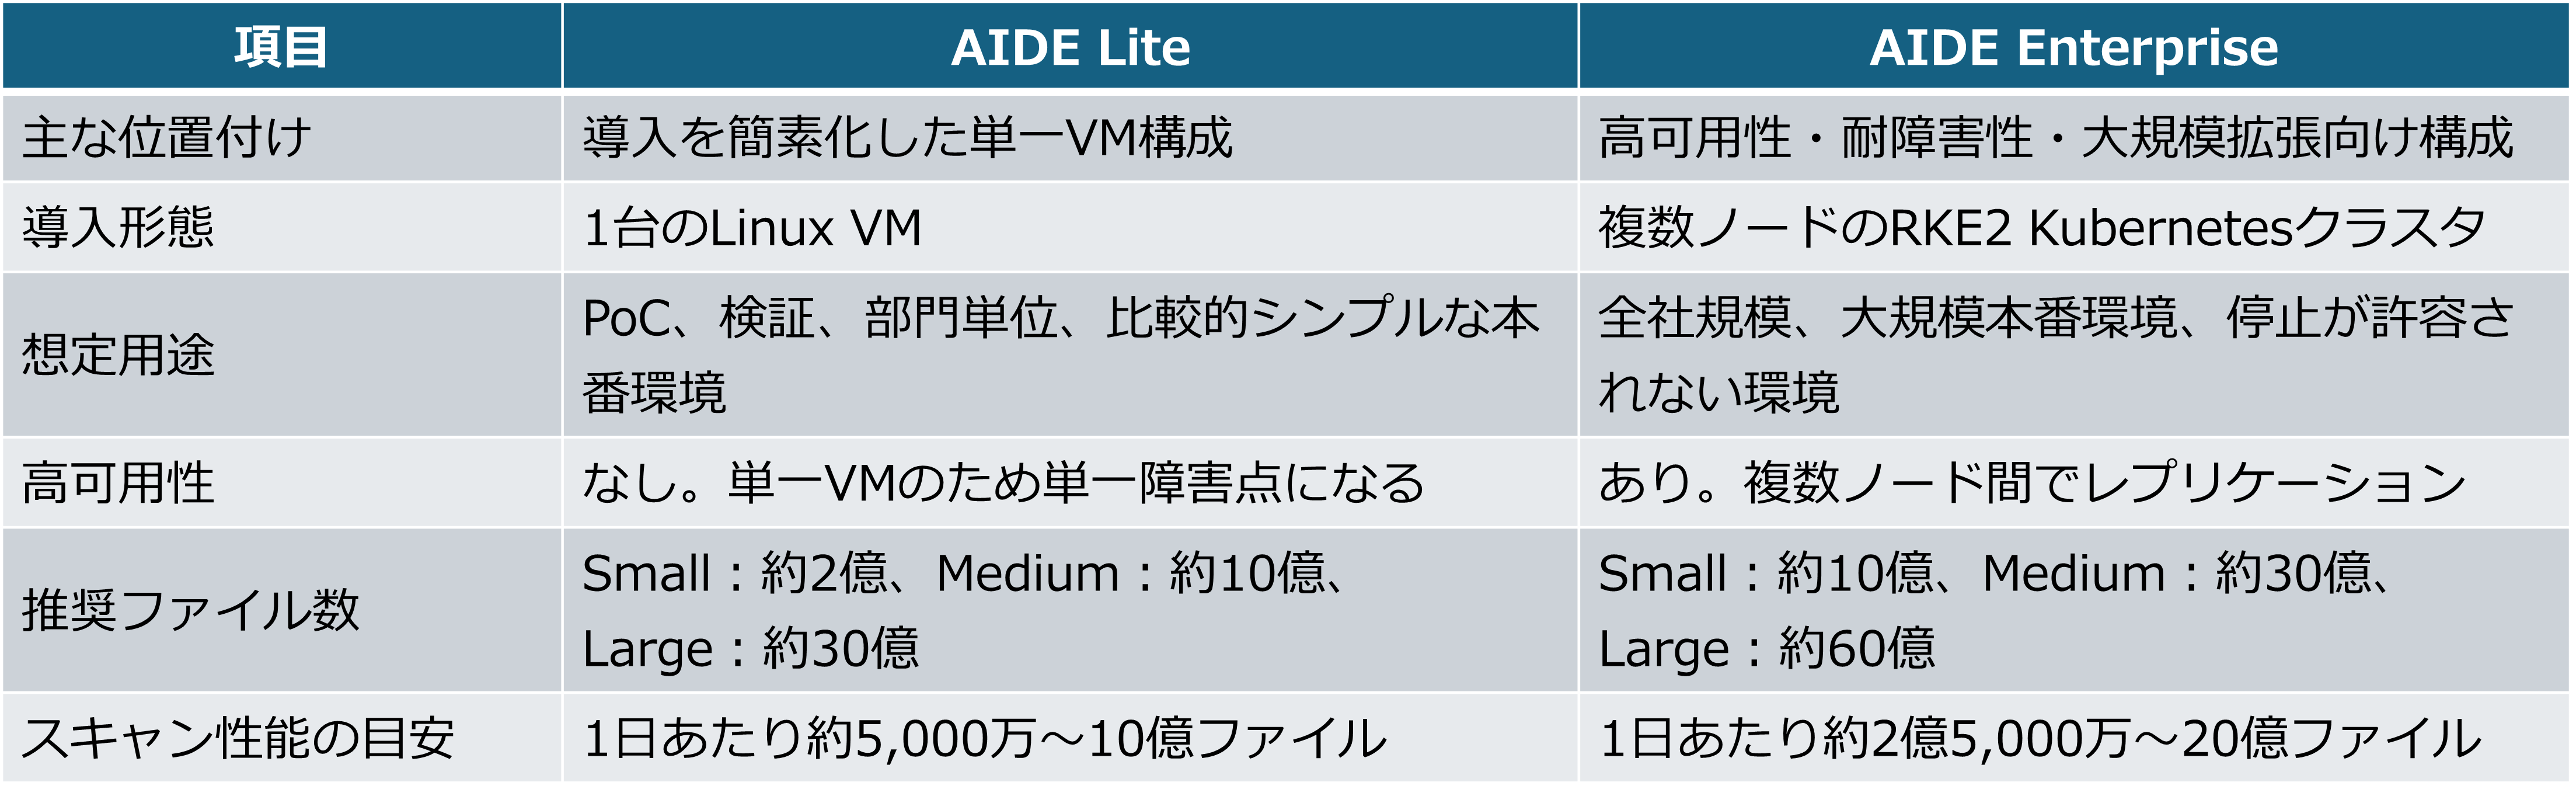
さらに、AIDEはNetApp Console(旧:BlueXP)から参照できるようになっており、様々なデータソースからなる環境での管理性においてもパワーアップしたと言って良いと思います。
【NetApp ConsoleからAIDEを利用するデモ】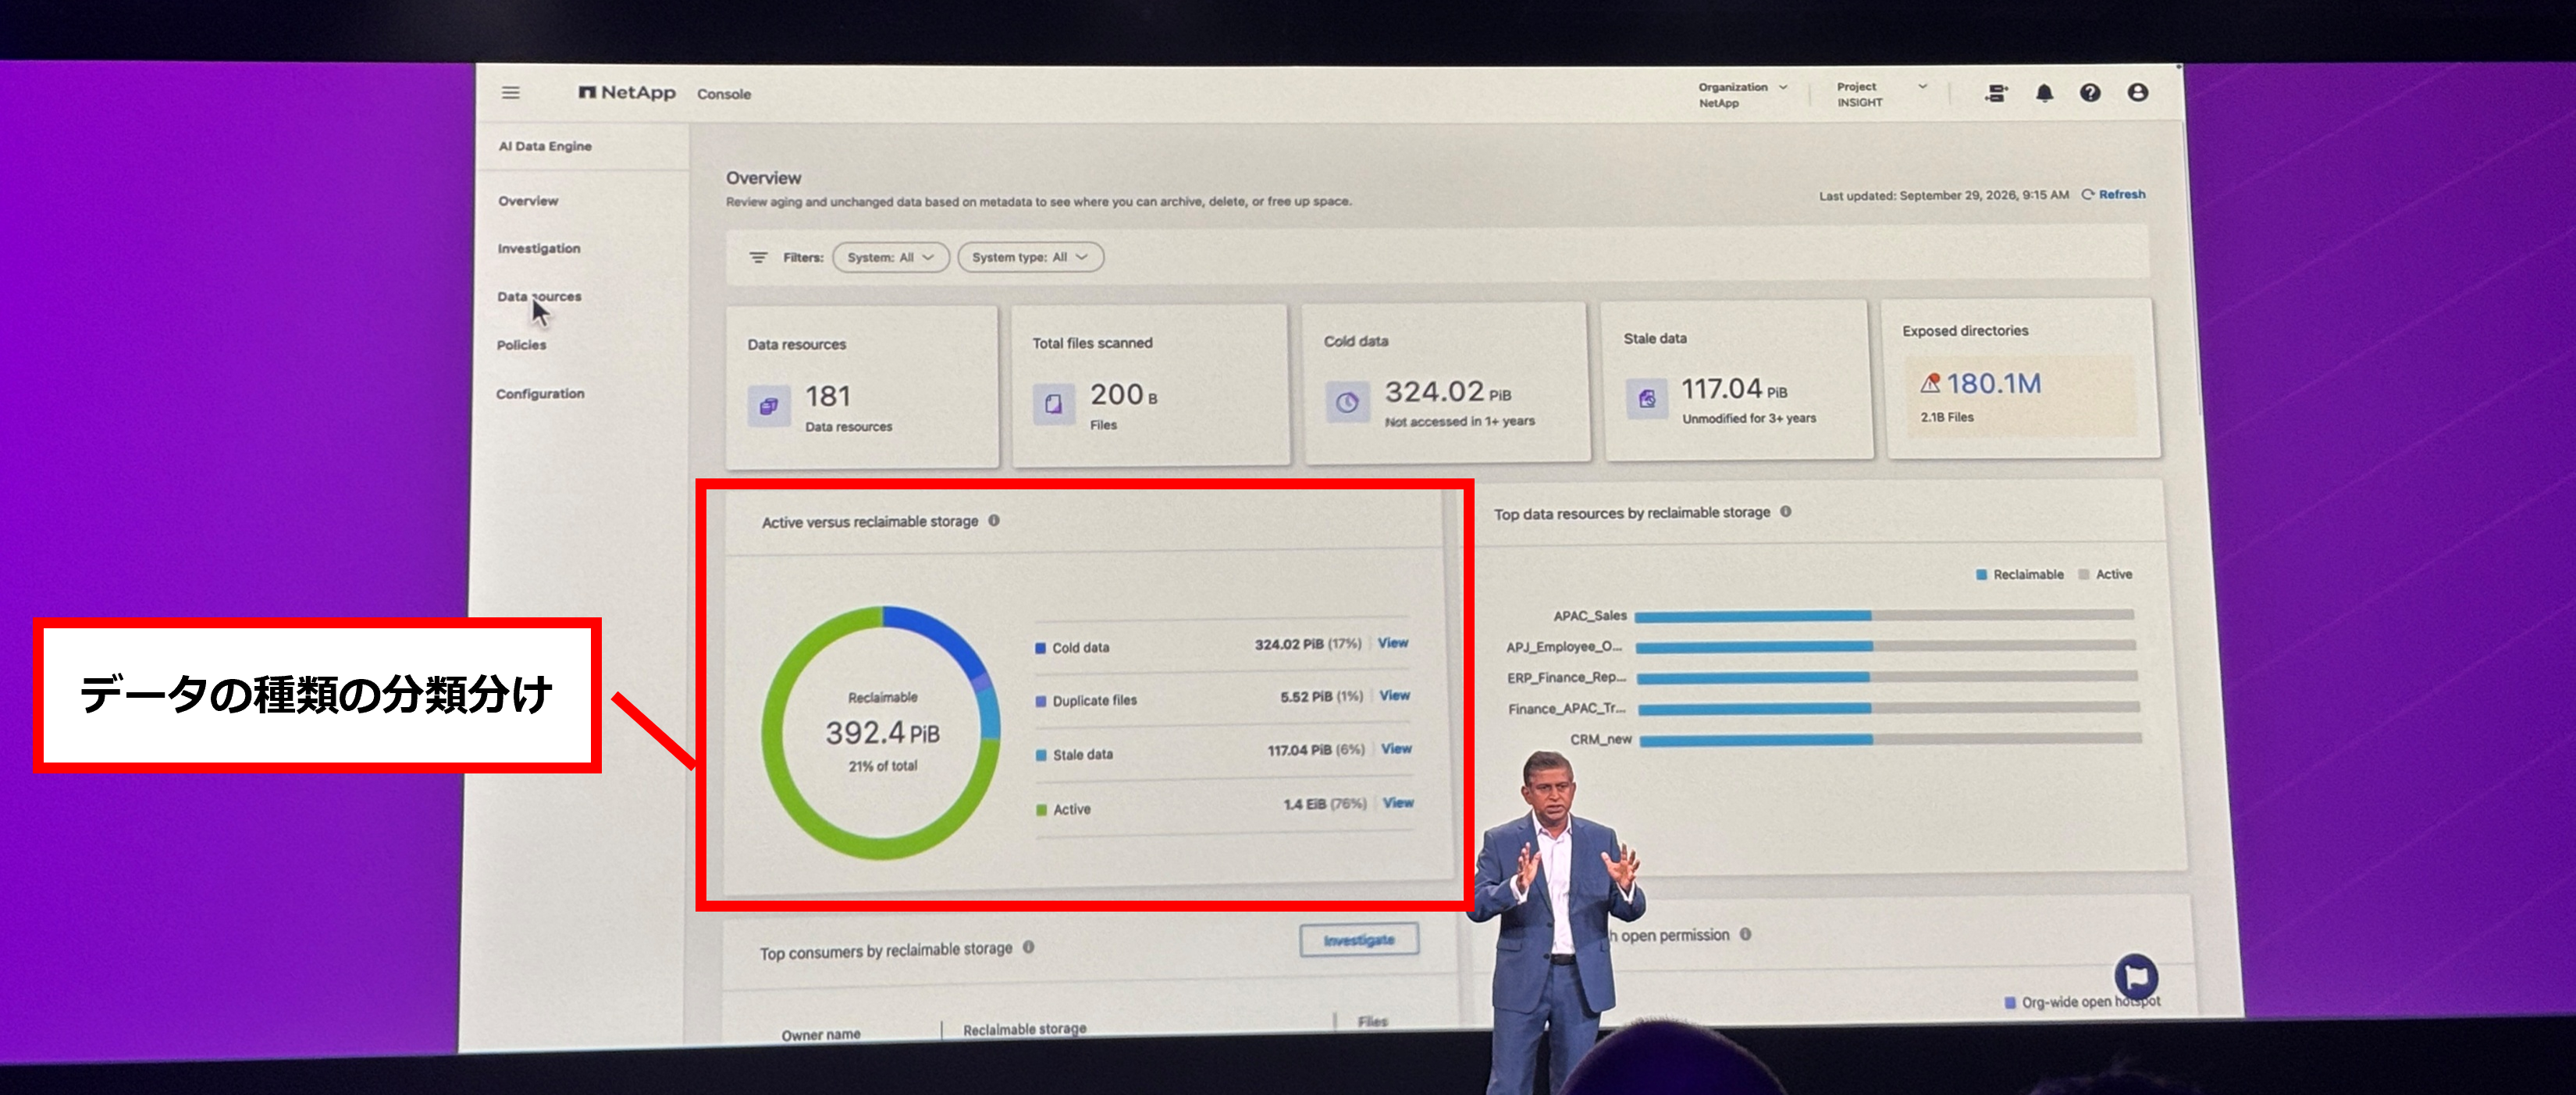
AIDEの公式マニュアルが最新化されているため、詳しい情報についてはこちらもご覧になってみてください。
ストレージによる新たなAIストレージアーキテクチャ「NetApp Novus」
2つ目の大きな発表はAIファクトリー向けの新しいストレージアーキテクチャ「NetApp Novus」です。
Novusが目指すのは、従来のように1つのストレージクラスタを大きくするのではなく、複数のストレージクラスタを1つのNamespaceとして束ね、性能・容量・メタデータをそれぞれ独立して拡張するアーキテクチャです。
KeynoteのDay1で示された主な内容は以下の通りです。
- 10万基を超えるGPUクラスターを想定
- 100TB/sのパフォーマンスを実現する地球上で最速のストレージ
- 世界初のゼタバイト規模のマルチファイルシステム
- Linux標準のNFSクライアントを利用し、独自クライアントや独自カーネルモジュールを不要にする
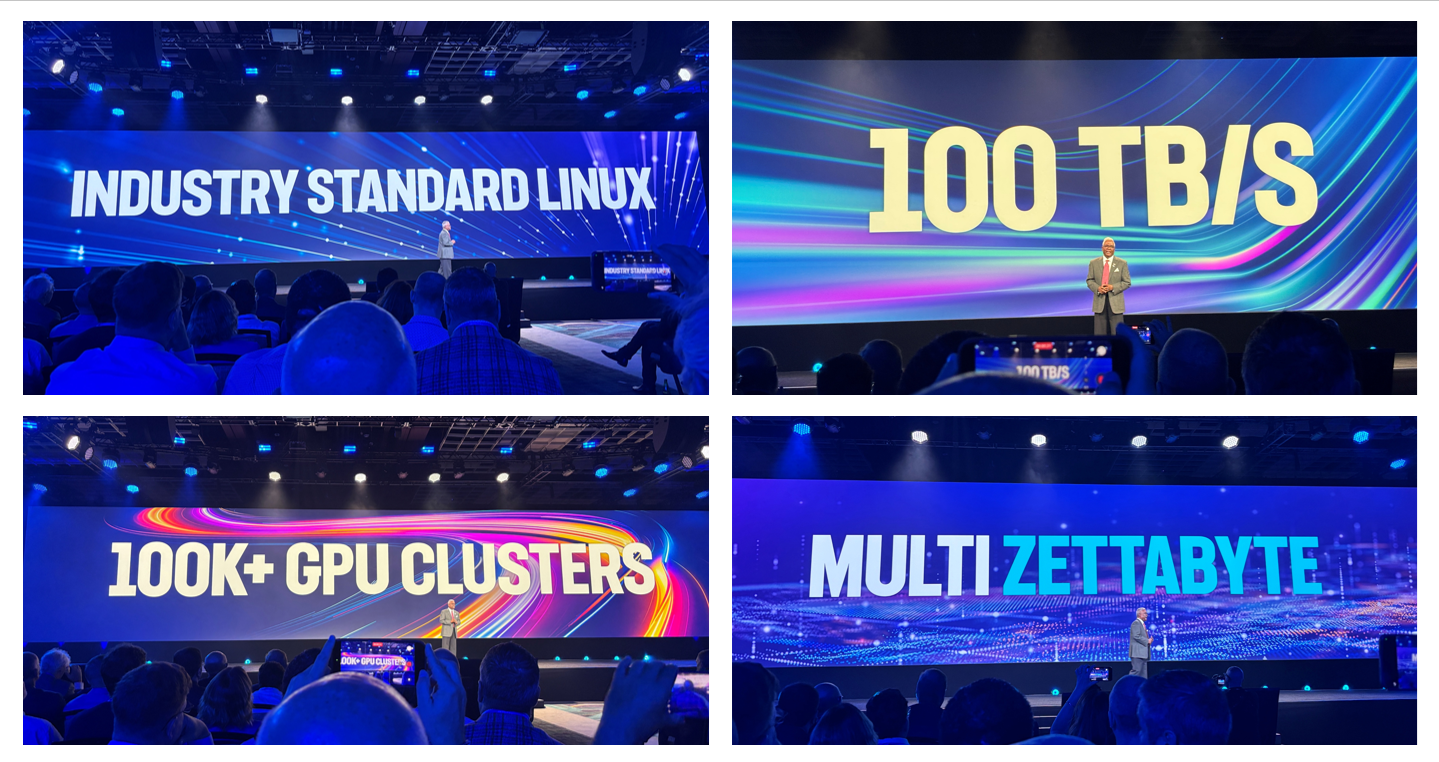
ただし、これらはKeynoteで示された設計目標とNetAppによる表現です。
本記事では、実測条件やサポート上限まで確定した製品仕様としてではなく、Novusが目指す規模と設計思想として紹介します。
【Novusを支える技術】
ここからは、NetAppのCPTOであるArindam Banerjee氏と、Los Alamos National LaboratoryのGary Grider氏が登壇し、Novusがなぜ必要なのか、どのような技術で設計されているのかが紹介されました。
Arindam Banerjee氏は、AIファクトリーではTraining、Inference、Checkpoint、AI Agentなど、性質の異なる処理が同じファイルシステムへ同時にアクセスするため、最初に処理の限界へ達するのは必ずしもデータ転送速度ではなく、メタデータ処理であると言います。
従来のNASは企業向けの共有、保護、ガバナンスに優れ、従来のパラレルファイルシステムは大規模な連続I/Oに優れています。
しかし、AIファクトリーでは、小さなランダムRead、大量のCheckpoint、推論、AI Agentによる同時アクセスが重なるため、従来のどちらか一方の設計だけでは対応が難しいと説明しました。
ーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーー
ここで少し補足:メタデータとは?
AIの環境でいうメタデータとは、ファイル名、保存場所、権限、状態など、目的のデータへたどり着くための情報です。
実データを「本の中身」とすれば、メタデータは「目次や本棚の場所」に当たります。大量のGPUが同時にファイルの場所を問い合わせると、データ転送用の帯域に余裕があっても、メタデータ処理が追いつかずGPUが待機してしまいます。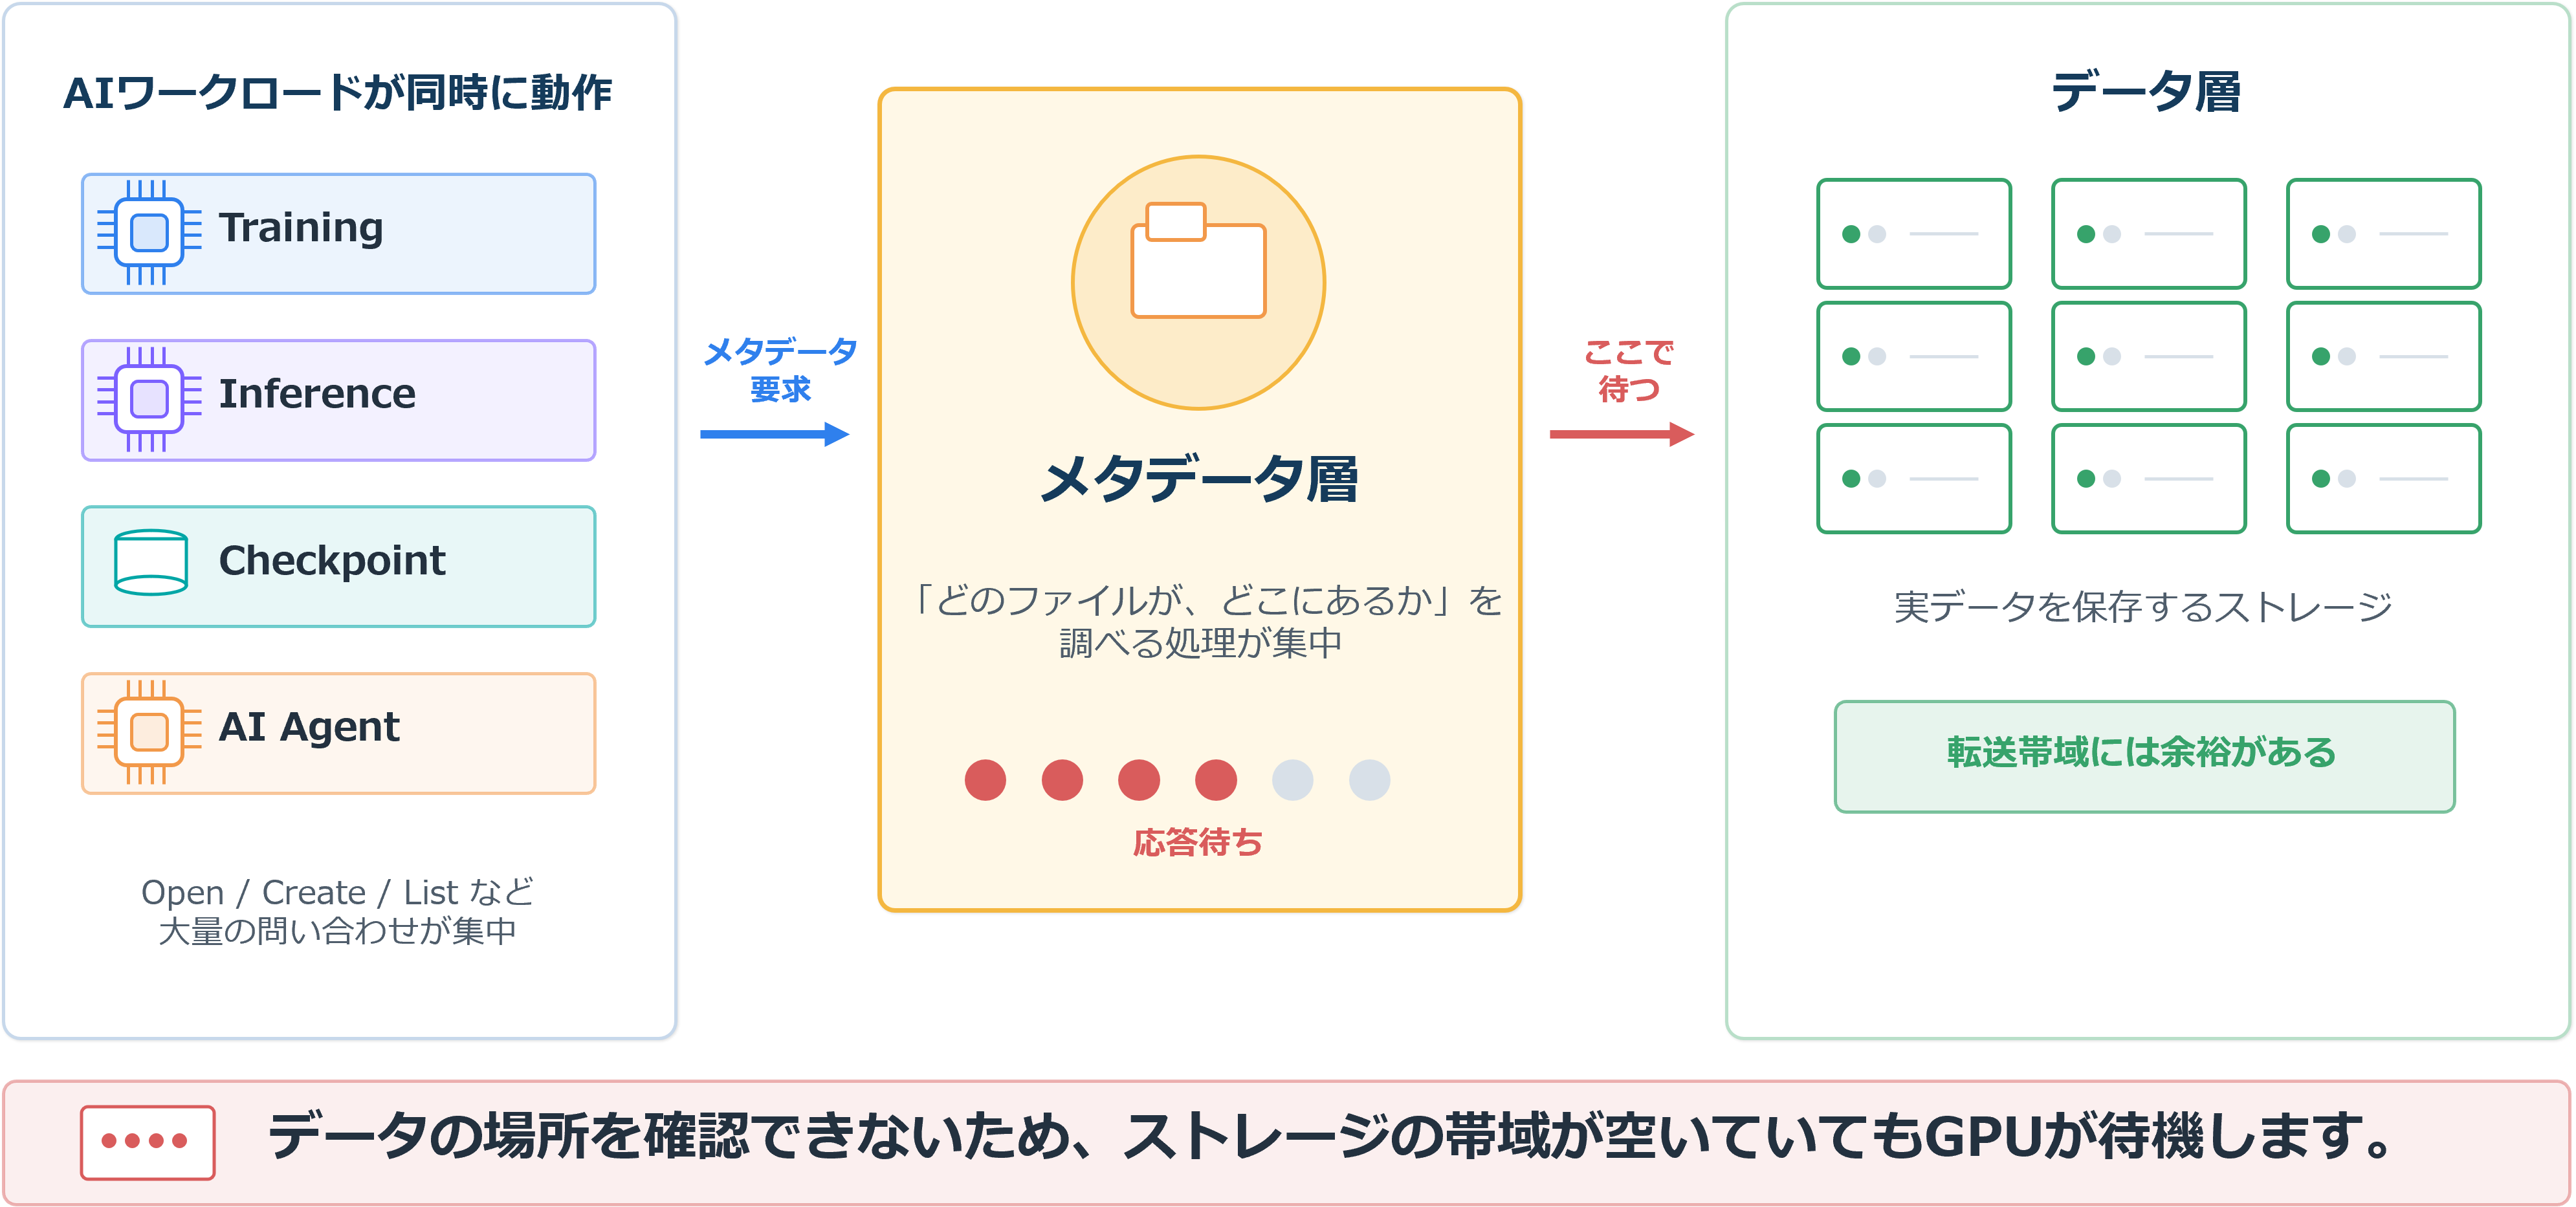
ーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーーー
Gary Grider氏からは、約600万コア、1兆ファイル規模の環境を運用した経験を基に、大規模環境ではメタデータを管理するサーバーの処理が遅れ、タイムアウトやファイルシステム全体の停止につながった経験が語られました。
その解決策として紹介されたのが、オープンソースのpNFS メタデータサーバープロジェクトであるLatticeです。
Latticeでは、メタデータの管理を1つの大きな機能として扱うのではなく、複数の役割へ分割します。
そして、負荷が高まった部分だけを独立して動的に拡張することで、AIファクトリー特有の大量かつ同時並行な処理へ対応します。
この説明を受け、Arindam Banerjee氏はNovusの基本的な設計思想を次のようにまとめました。
- 1つの巨大なストレージクラスタを作るのではなく、複数のONTAPクラスタをフェデレーション(複数クラスタを1つの論理基盤として束ねる)
- 利用者からは、複数のクラスタを1つのファイルシステム、1つのマウントポイント、1つのNamespaceとして見せる
- メタデータと実データを別々の層として扱い、それぞれを独立して拡張する
- pNFSのFlex Files機能を利用し、GPUサーバーから複数のONTAPクラスタへ並列アクセスする
- データサーバーにはONTAPを利用し、性能だけでなくデータ整合性、可用性、セキュリティ、マルチテナント、QoSも維持する
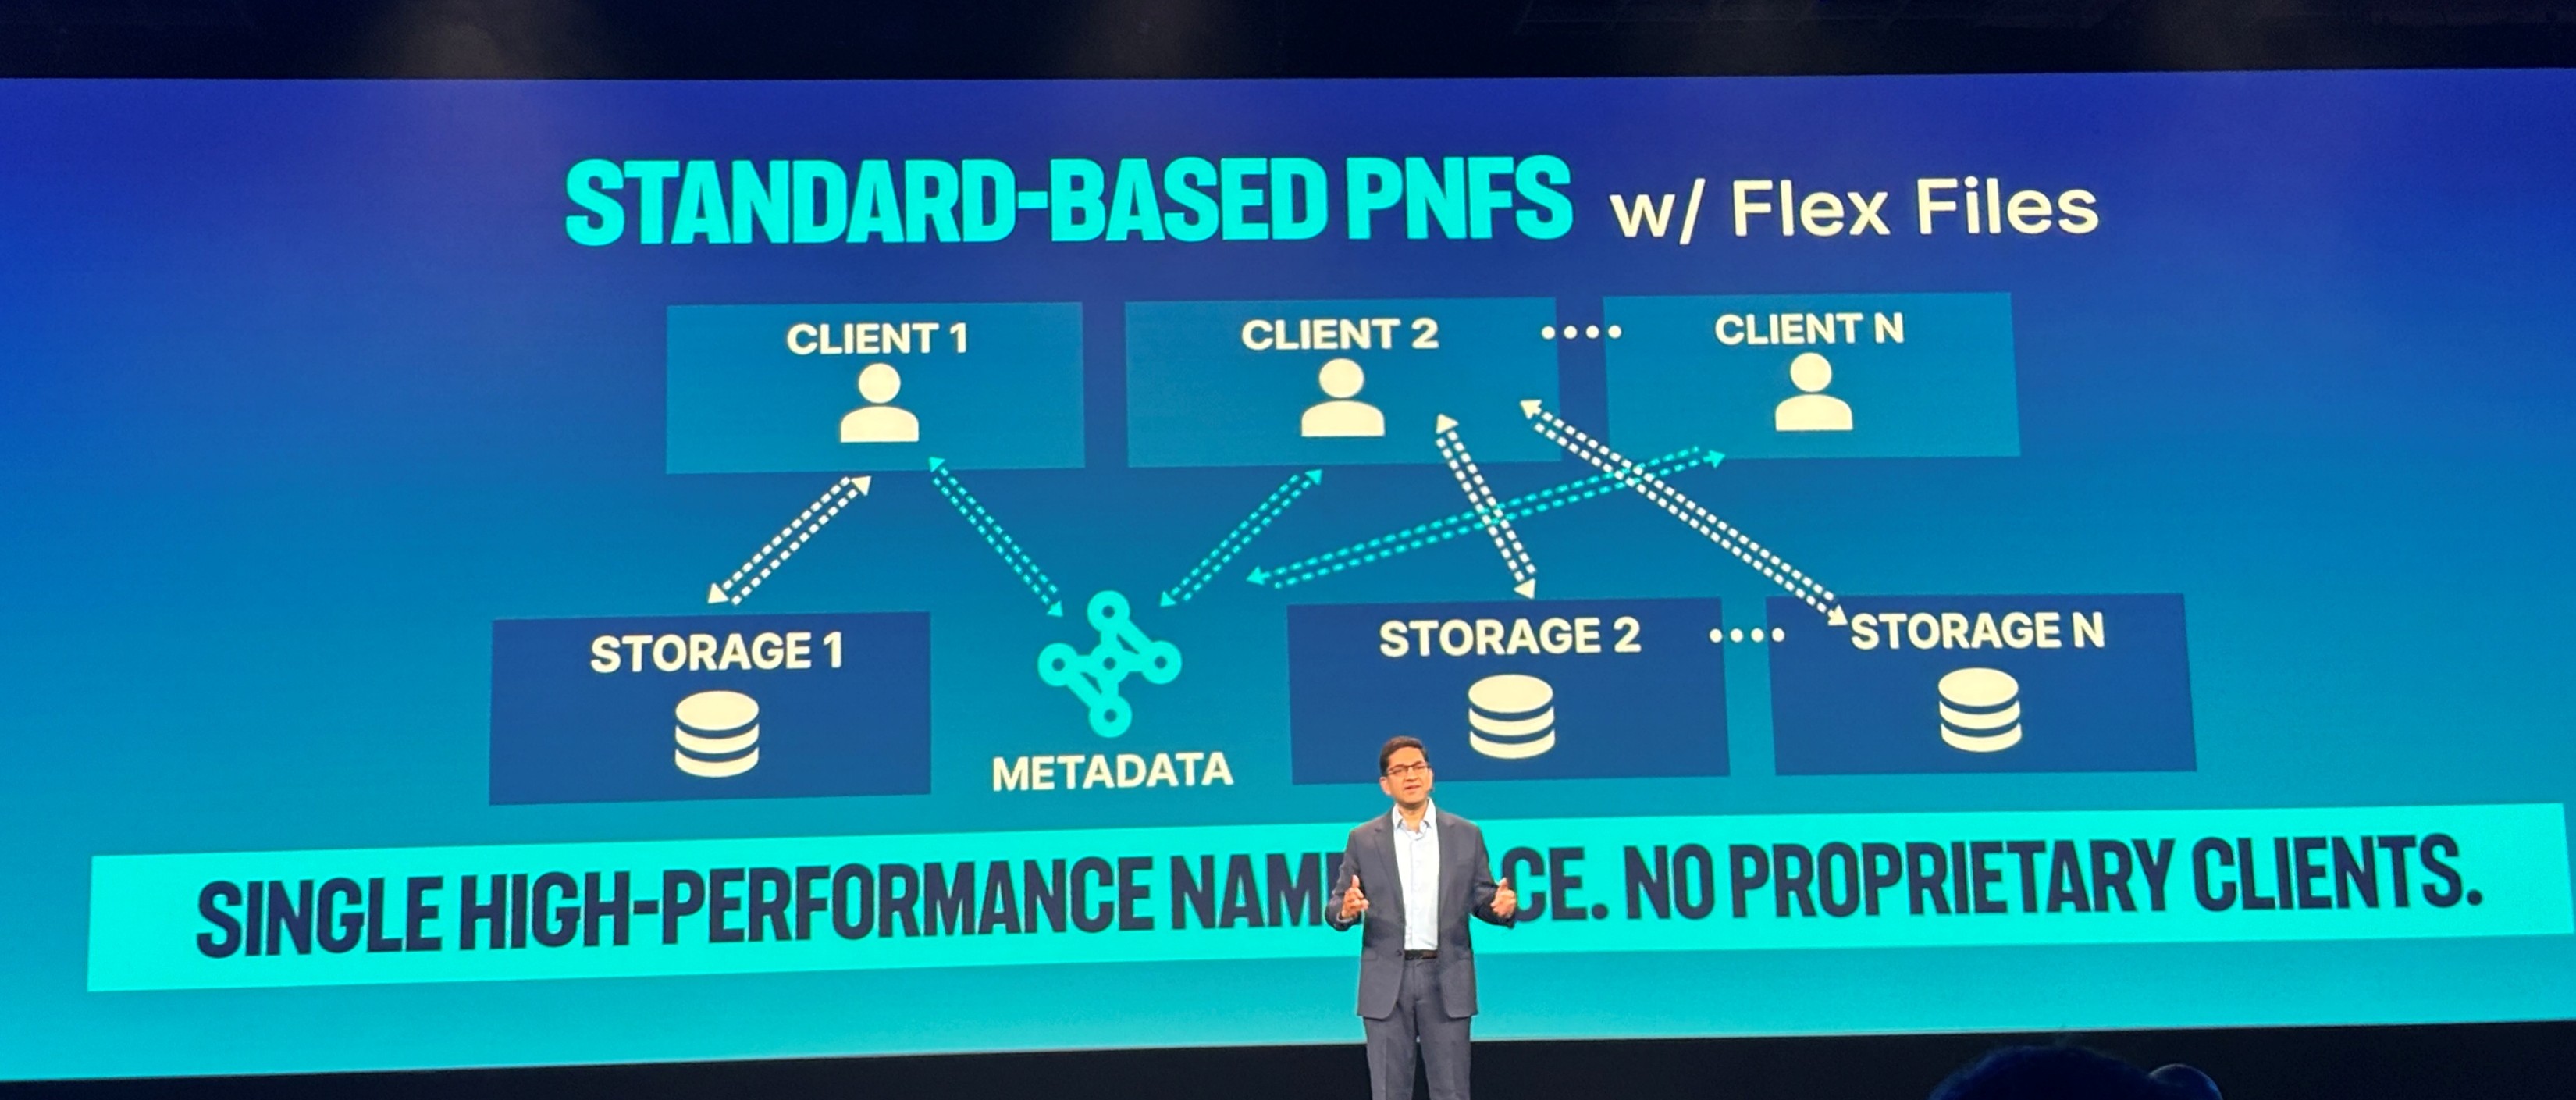
また、NovusがNetApp独自のクライアントソフトやカーネルモジュールを必要とせず、Linuxに標準搭載されているpNFSクライアントを利用する点も強調されました。
そのため、GPUサーバーのOSやドライバー、CUDA、セキュリティパッチを更新する際に、NetApp独自ソフトウェアの対応を待つ必要が少なくなり、利用者側の計画に合わせて更新しやすくなります。
Keynote Day1で紹介された内容を簡潔にまとめると、Novusは次のようなアーキテクチャとなります。
複数のONTAPクラスタを1つのNamespaceへ統合し、メタデータとデータを独立して拡張することで、AIファクトリーに必要な大規模な並列アクセスと、ONTAPの信頼性・保護機能を両立する。
その他の製品アップデート
AI以外の製品についてもいくつかのアップデートが発表されたため、ご紹介します。
NetAppとCommvaultでランサムウェア検知から安全な復旧までを連携
AIからデータを利用できるようにするだけでなく、そのデータを継続的に保護することも重要です。
今回、NetAppとCommvaultを組み合わせたサイバーレジリエンスの連携が、デモを交えて紹介されました。
この連携では、ONTAPのAutonomous Ransomware Protection(ARP)がランサムウェアを検知した際にCommvaultへ連携し、Commvaultのコンソールから脅威の確認、詳細スキャン、Cleanroomでの検証、クリーンなデータからの復旧までを一元的に実行します。
つまり、NetAppがプライマリストレージ上で異常を早期に検知し、Commvaultが安全な復旧ポイントの特定と復旧オーケストレーションを担当することで、「検知した後、どのデータから安全に戻すのか」という復旧までのループを閉じる仕組みです。
【NetAppとCommvaultのサイバーレジリエンス連携デモ】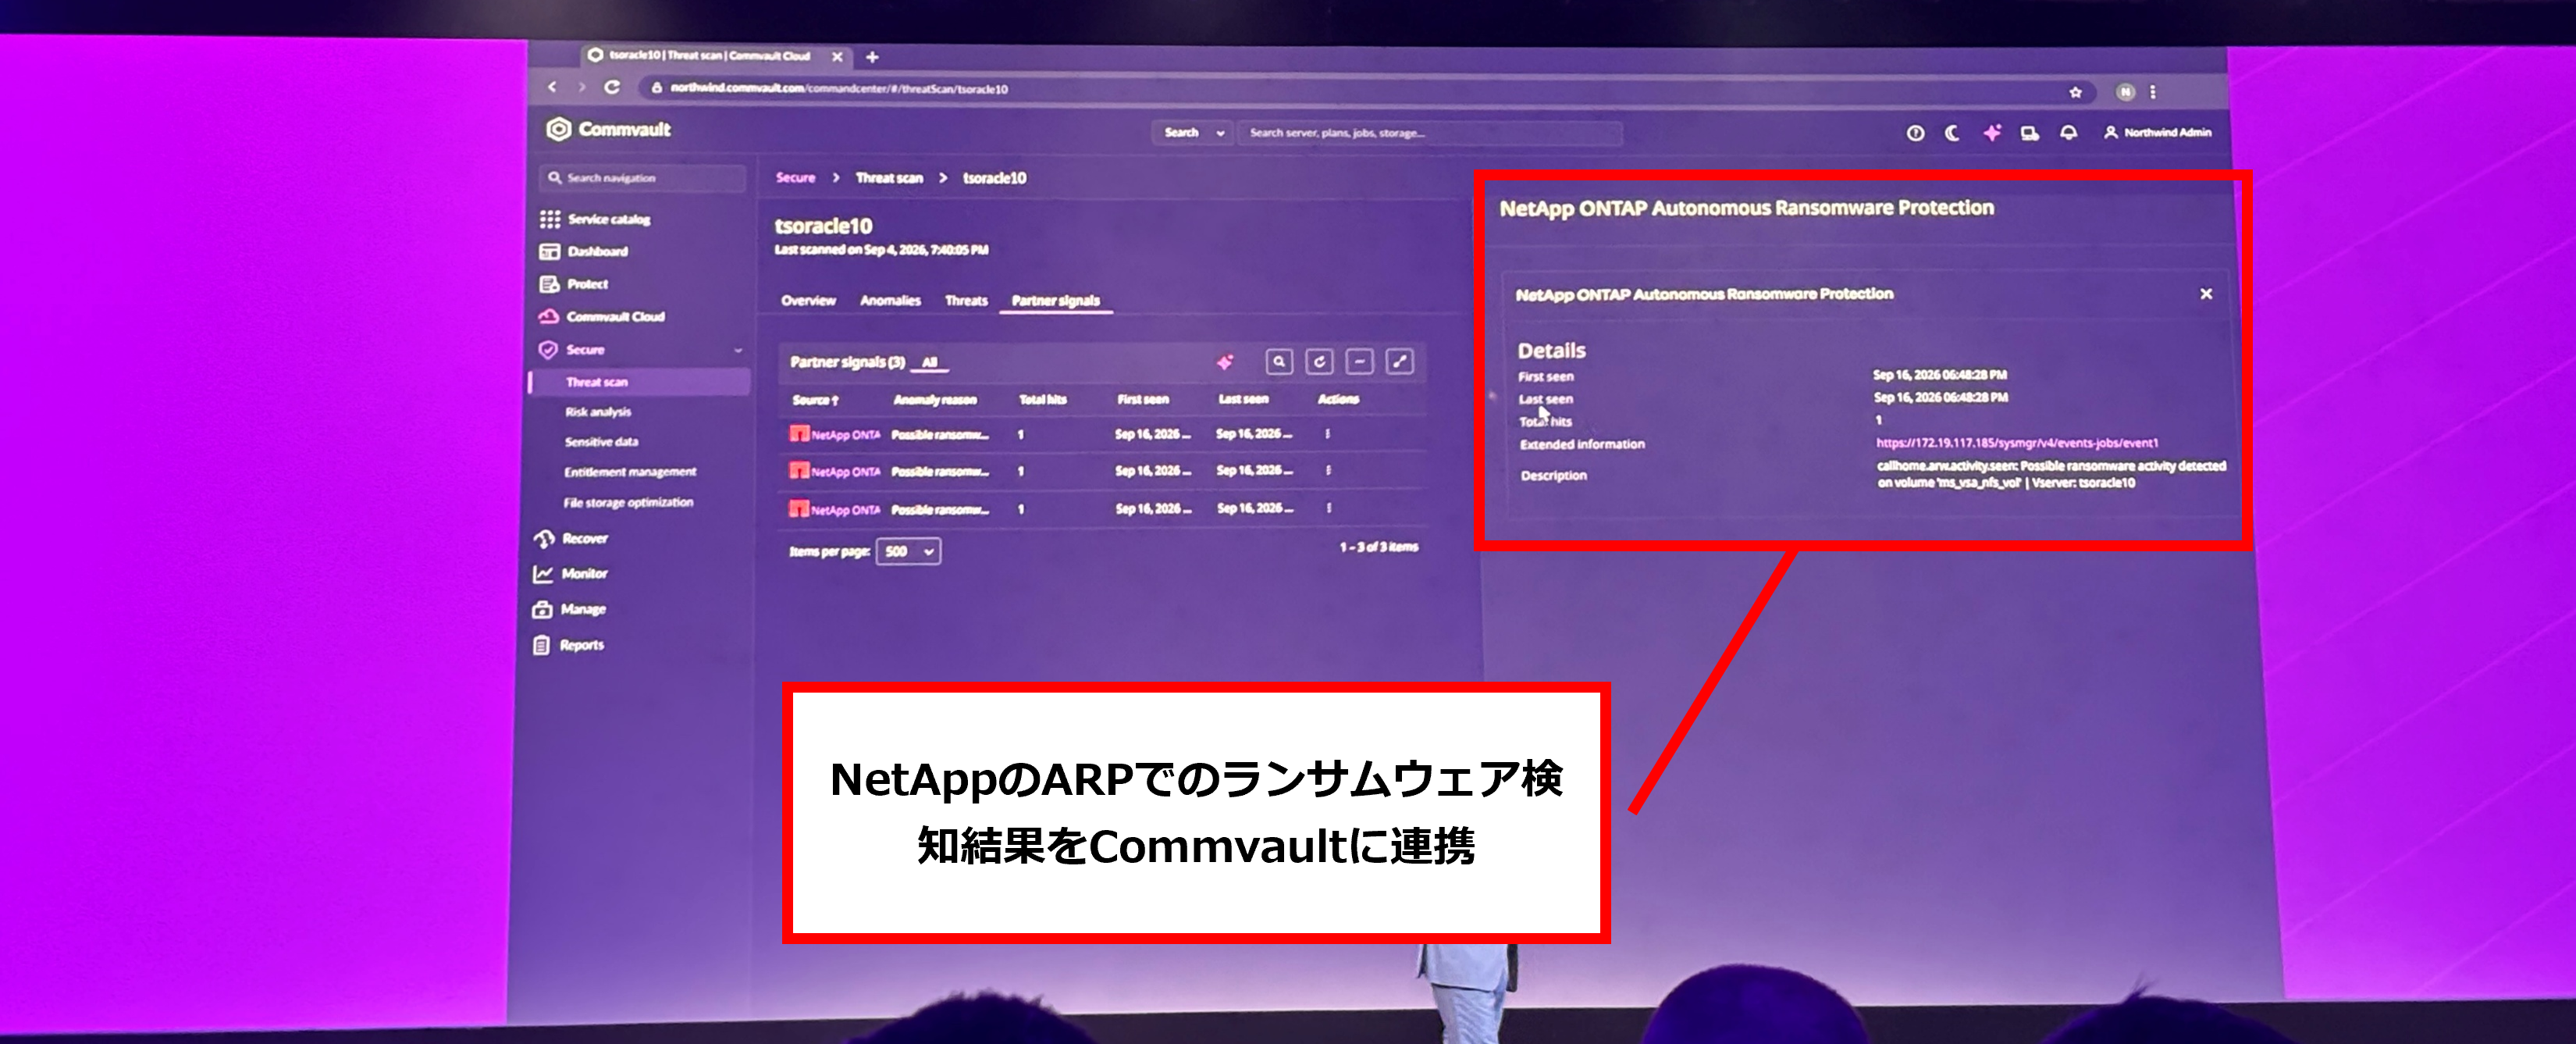
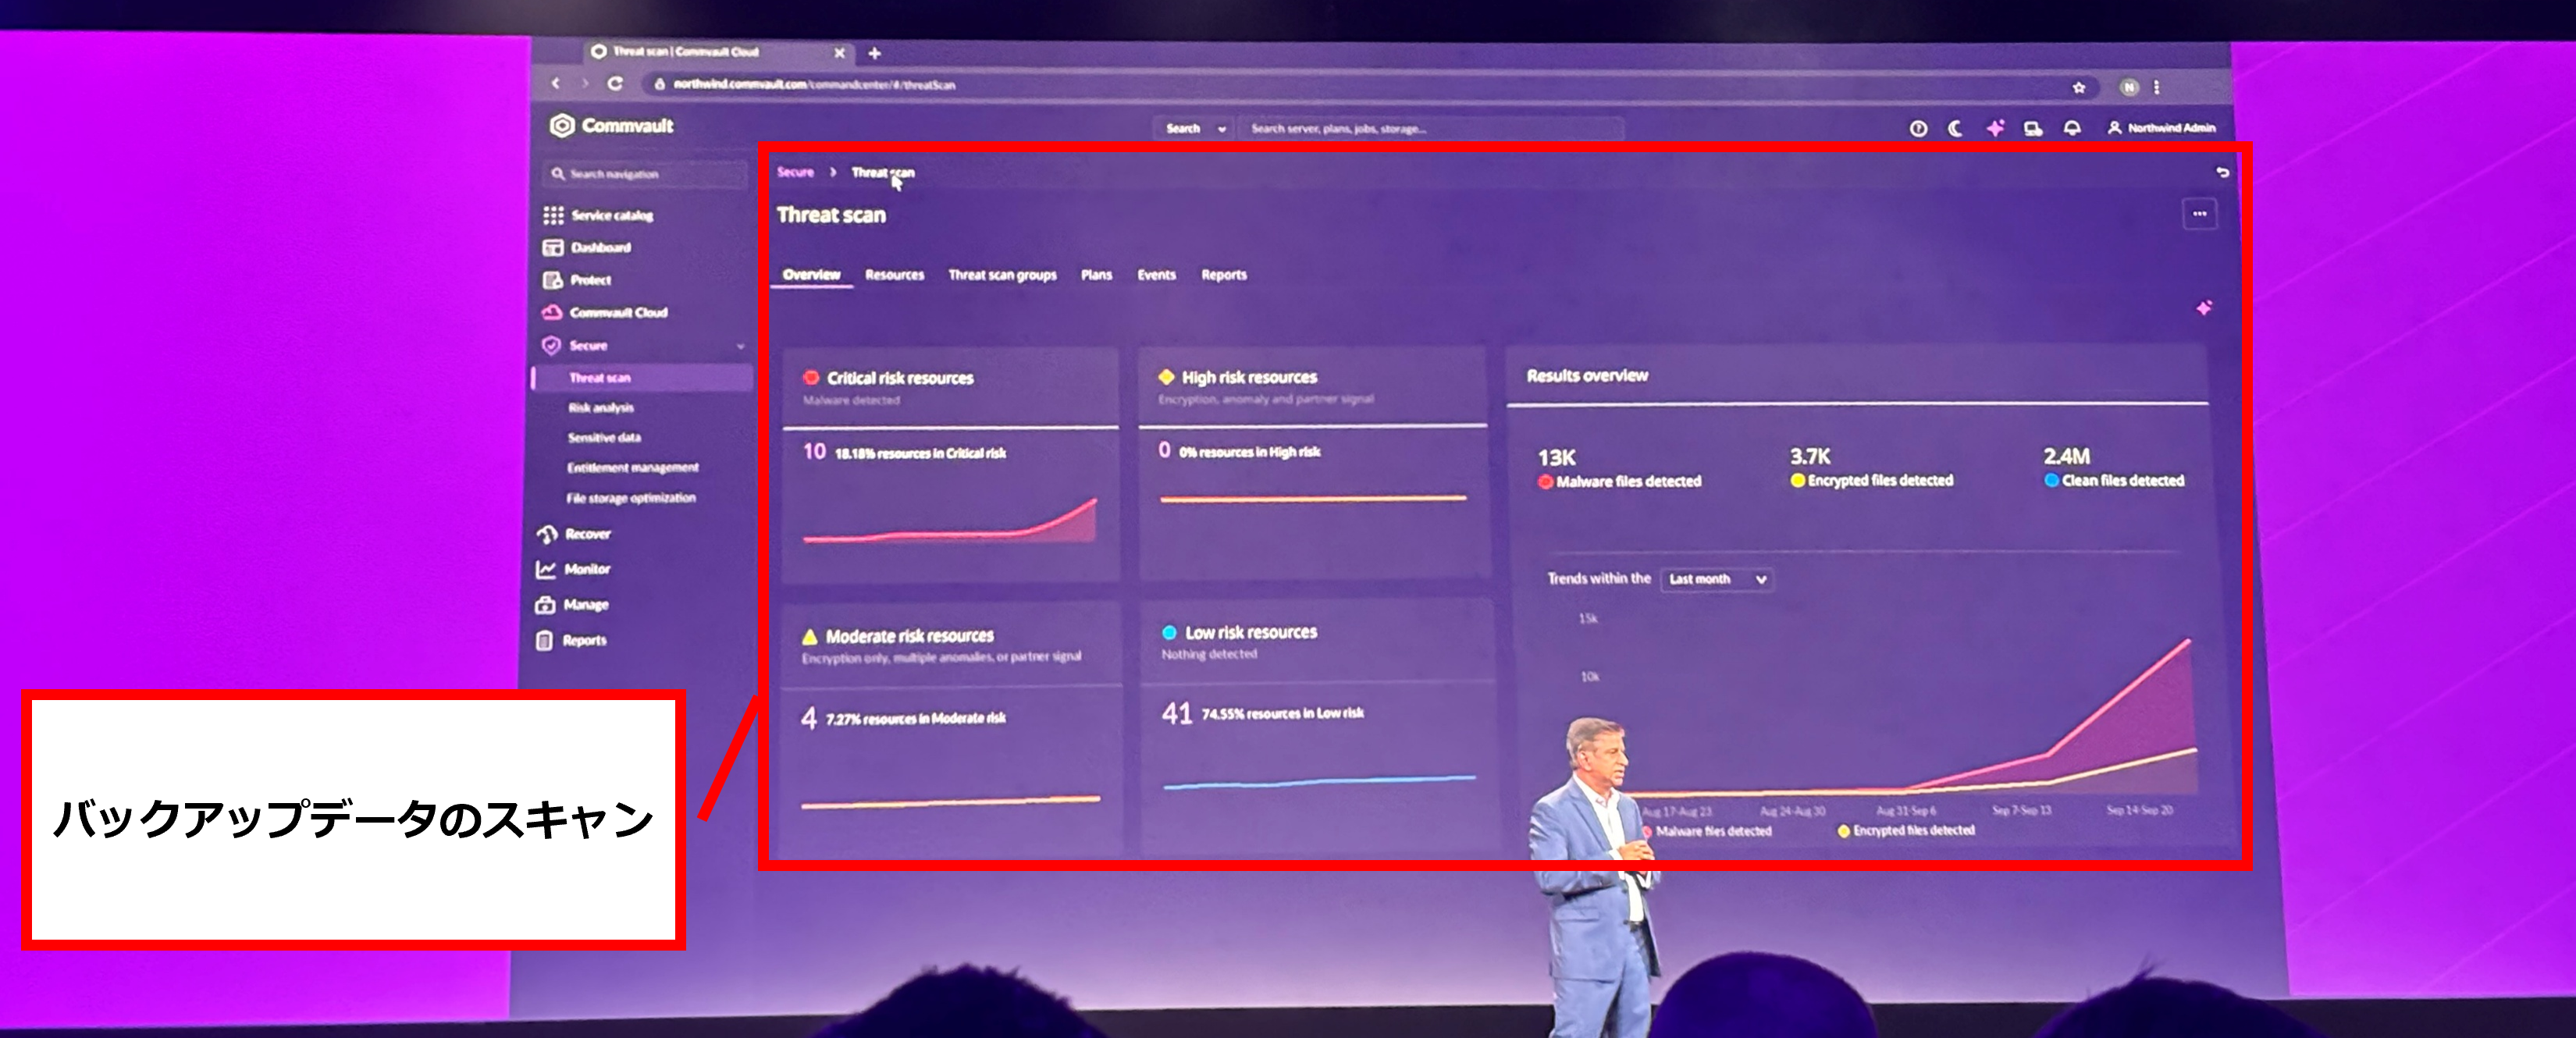
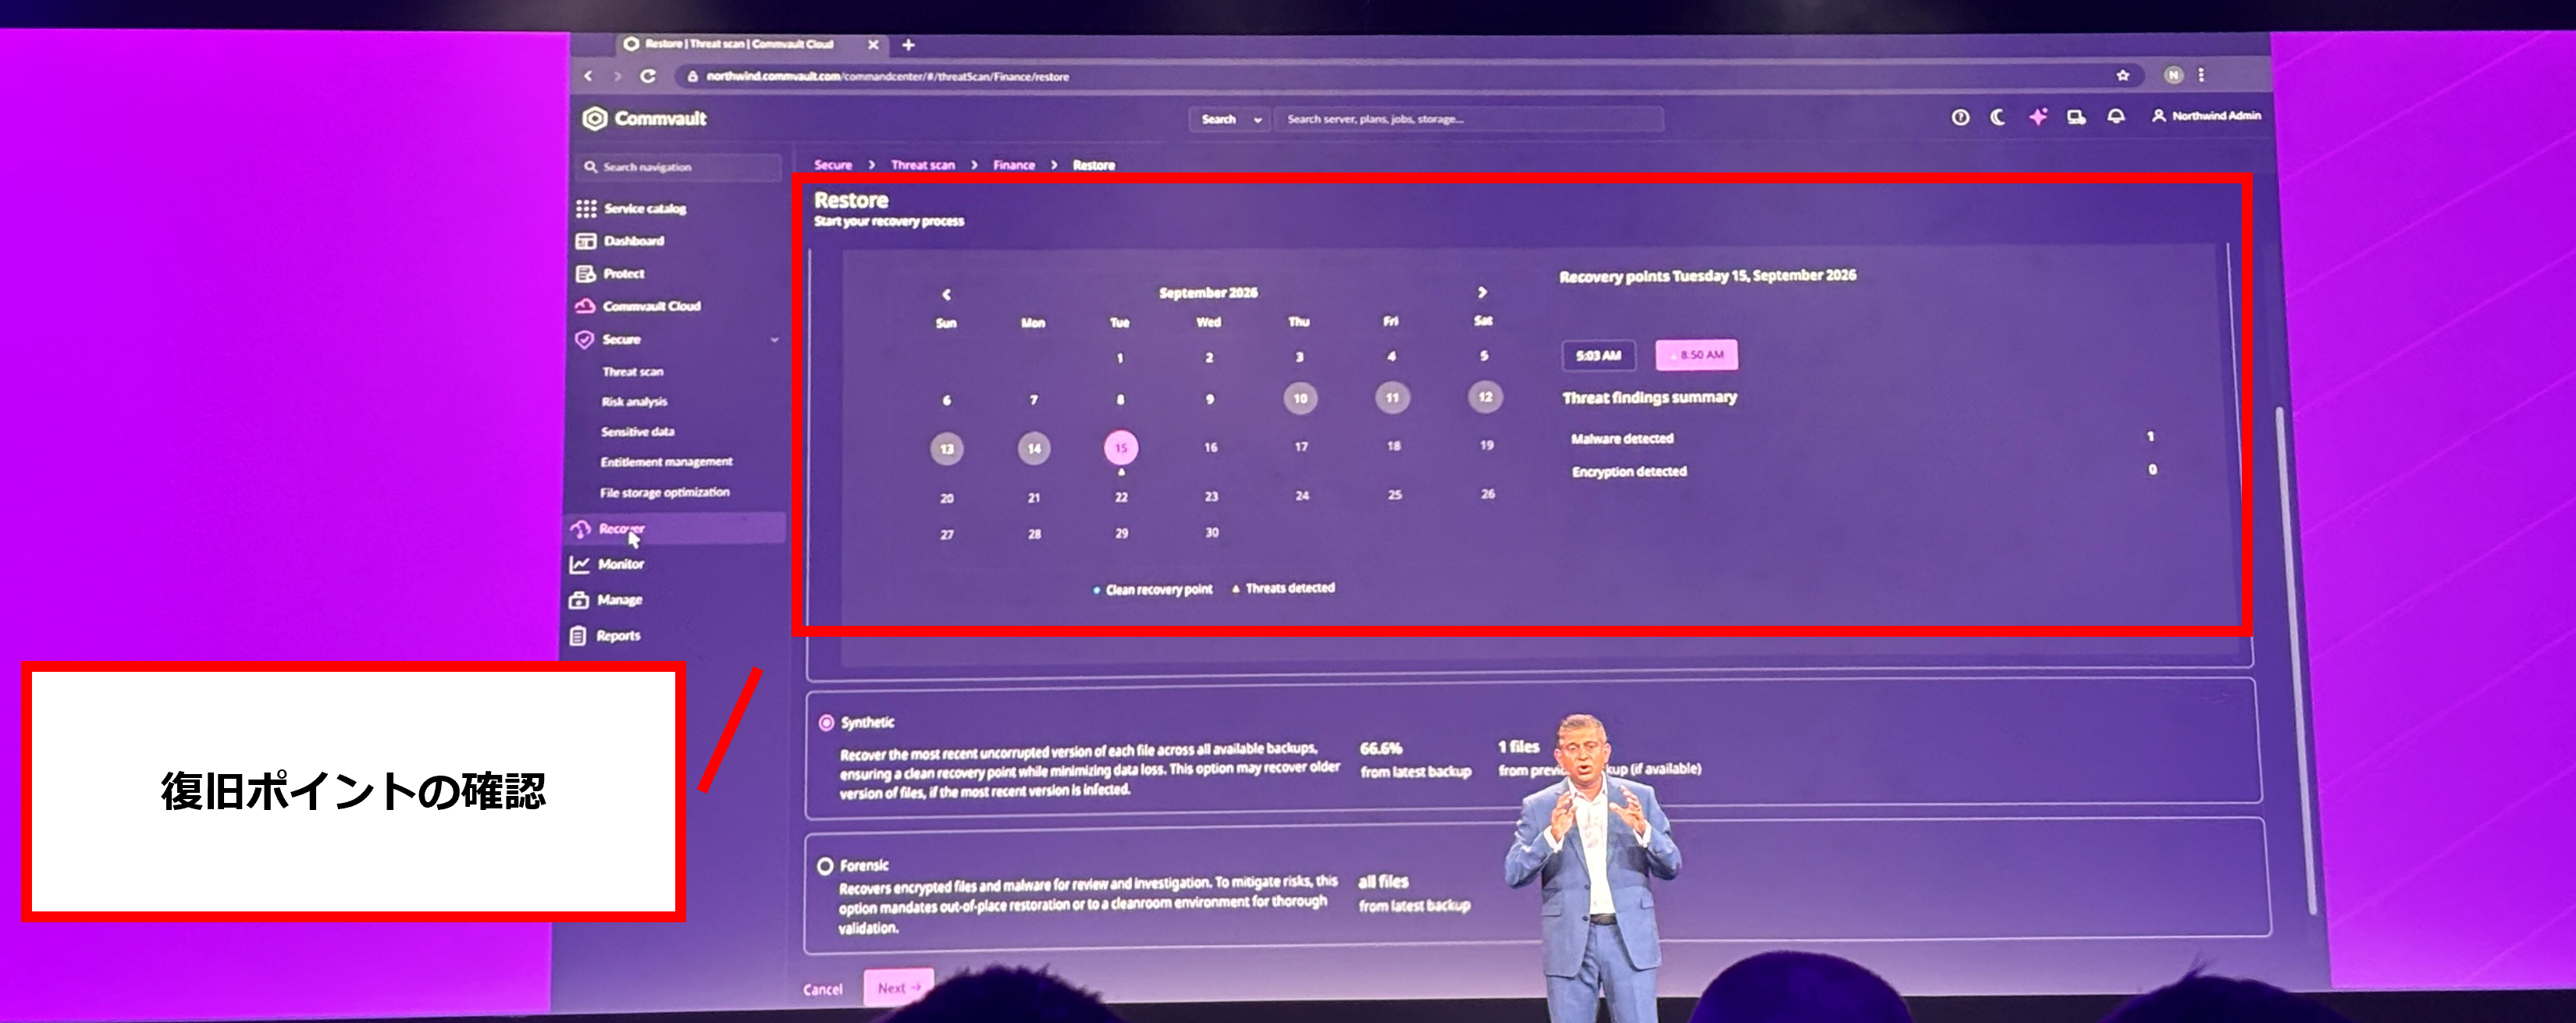
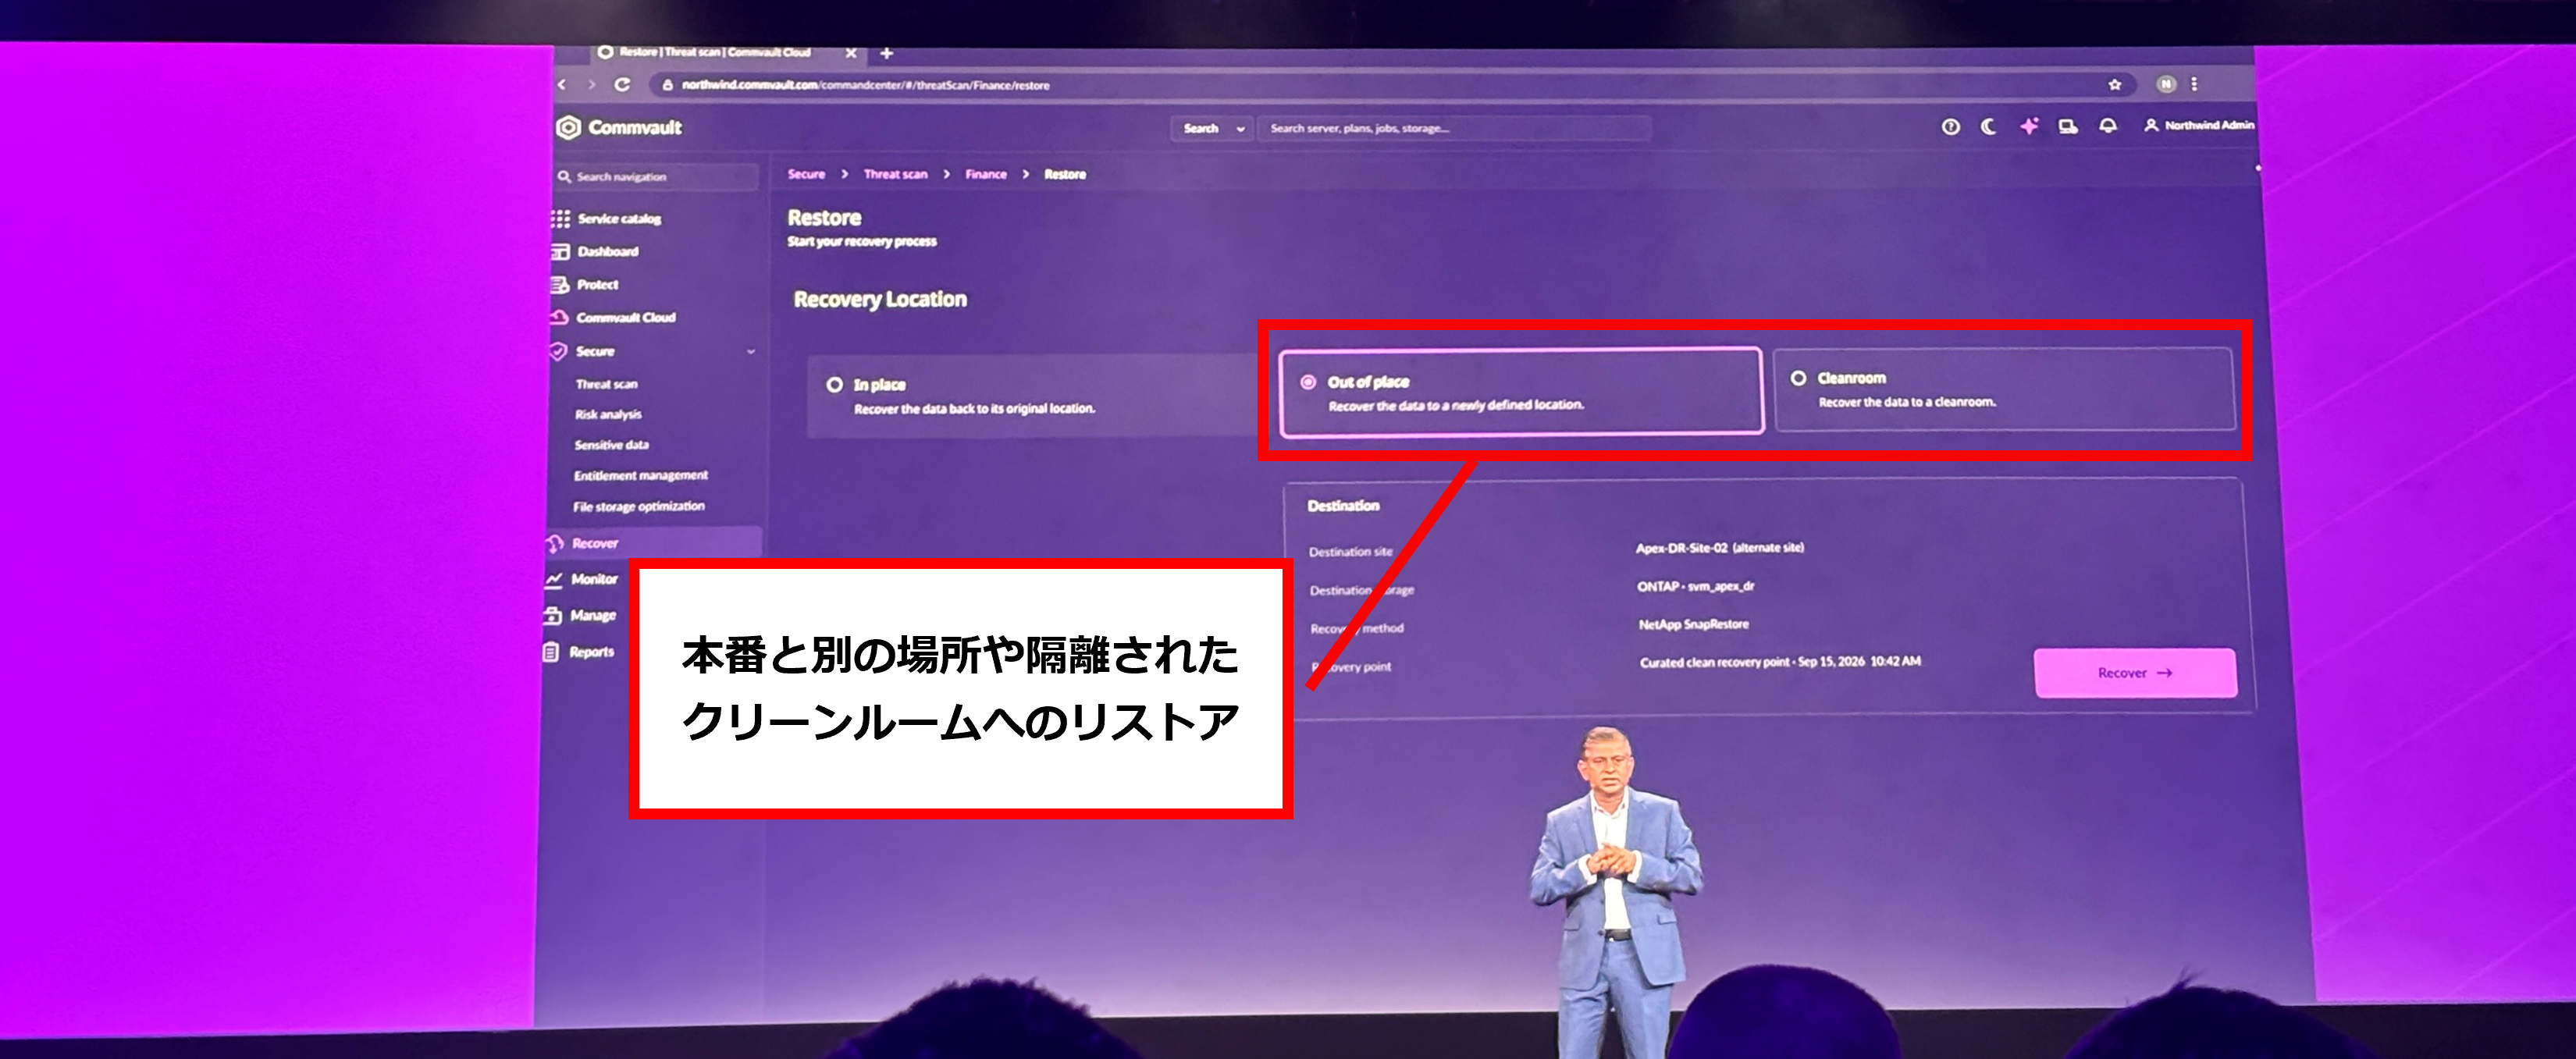
ランサムウェア対策では、攻撃を検知するだけでなく、マルウェアを持ち込まない状態で業務を再開できることが重要です。
今回の連携は、その部分をNetAppとCommvaultの強みを組み合わせて一元化するものだと理解しました。
ARPについて詳細が知りたい方は以下の記事をご覧ください。
「NASも"SAN"もランサムウェアから守れるNetApp ~機能説明編~」
「NASも"SAN"もランサムウェアから守れるNetApp ~ブロックアーキテクチャ編~」
「NASも"SAN"もランサムウェアから守れるNetApp ~検証結果編~」
NetApp Consoleは「見るための画面」から「運用を任せる基盤」へ
続いて、オンプレミス、パブリッククラウド、Keystoneなどに分散したNetApp環境を統合管理する「NetApp Console」のアップデートが発表されました。
環境が複数に分かれていると、管理ツールや担当チームも分かれ、同じポリシーがすべての環境へ適用されているかを確認することが難しくなります。
※ここで言う「環境」は、複数のストレージで構成されるシステムを指します。
NetApp Consoleは、これらを1つのコントロールプレーンから管理することを目指しており、今回の発表では以下の3つが大きなアップデートとして紹介されました。
NetApp Console Fleet Management
複数のONTAPクラスタやクラウド環境を、1つのフリート(グループ)としてまとめて可視化・管理する機能です。
フリート単位で様々な状態を確認することができます。
- 複数クラスタの統合的な可視化
- ヘルス監視
- 予測分析
- 容量・性能の最適化
- インシデントの早期発見
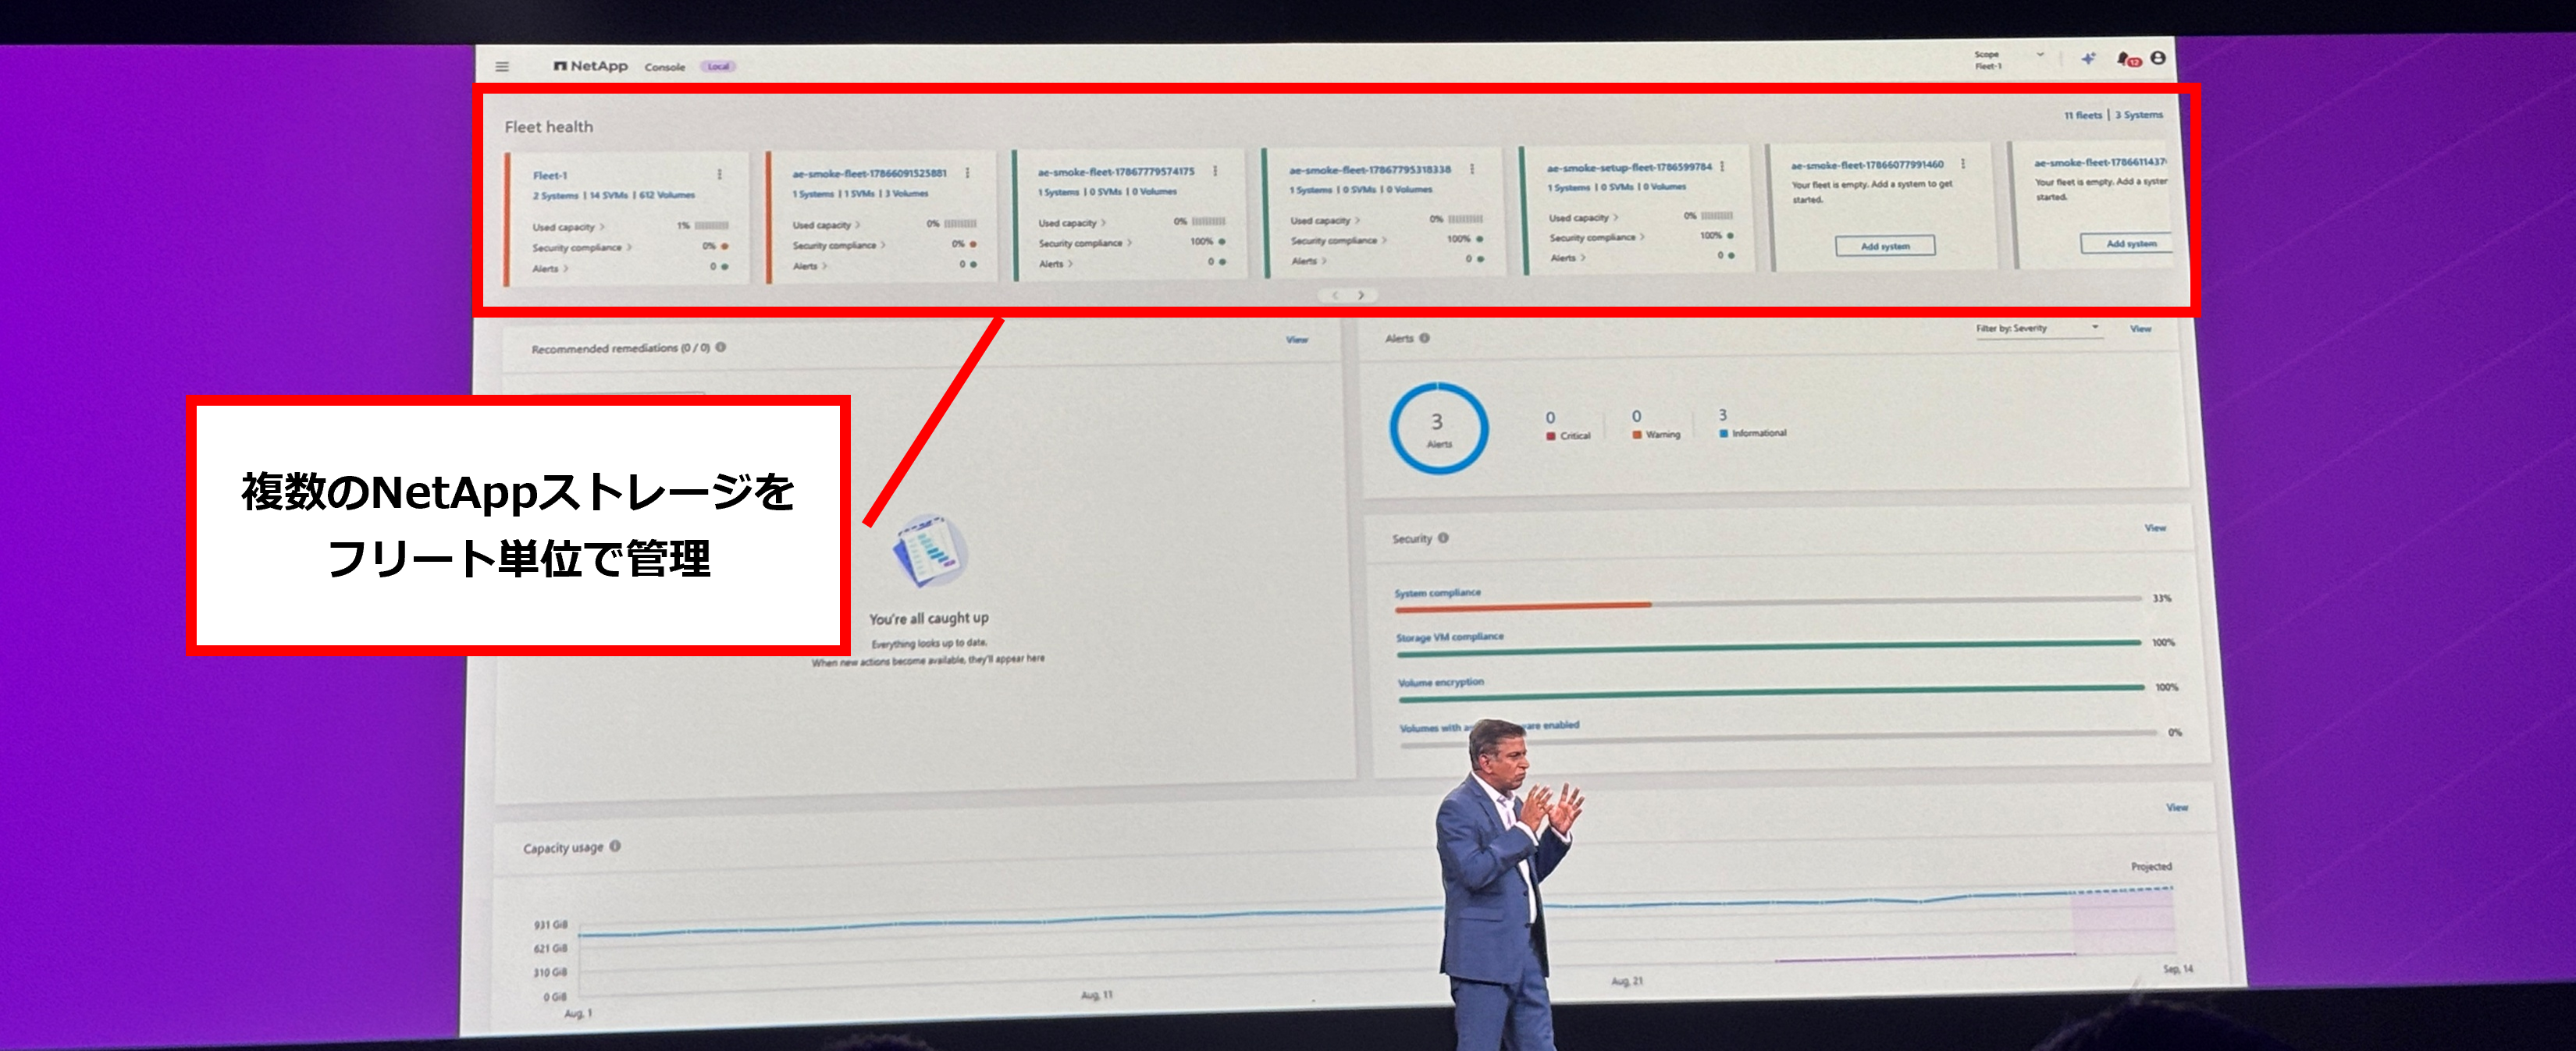
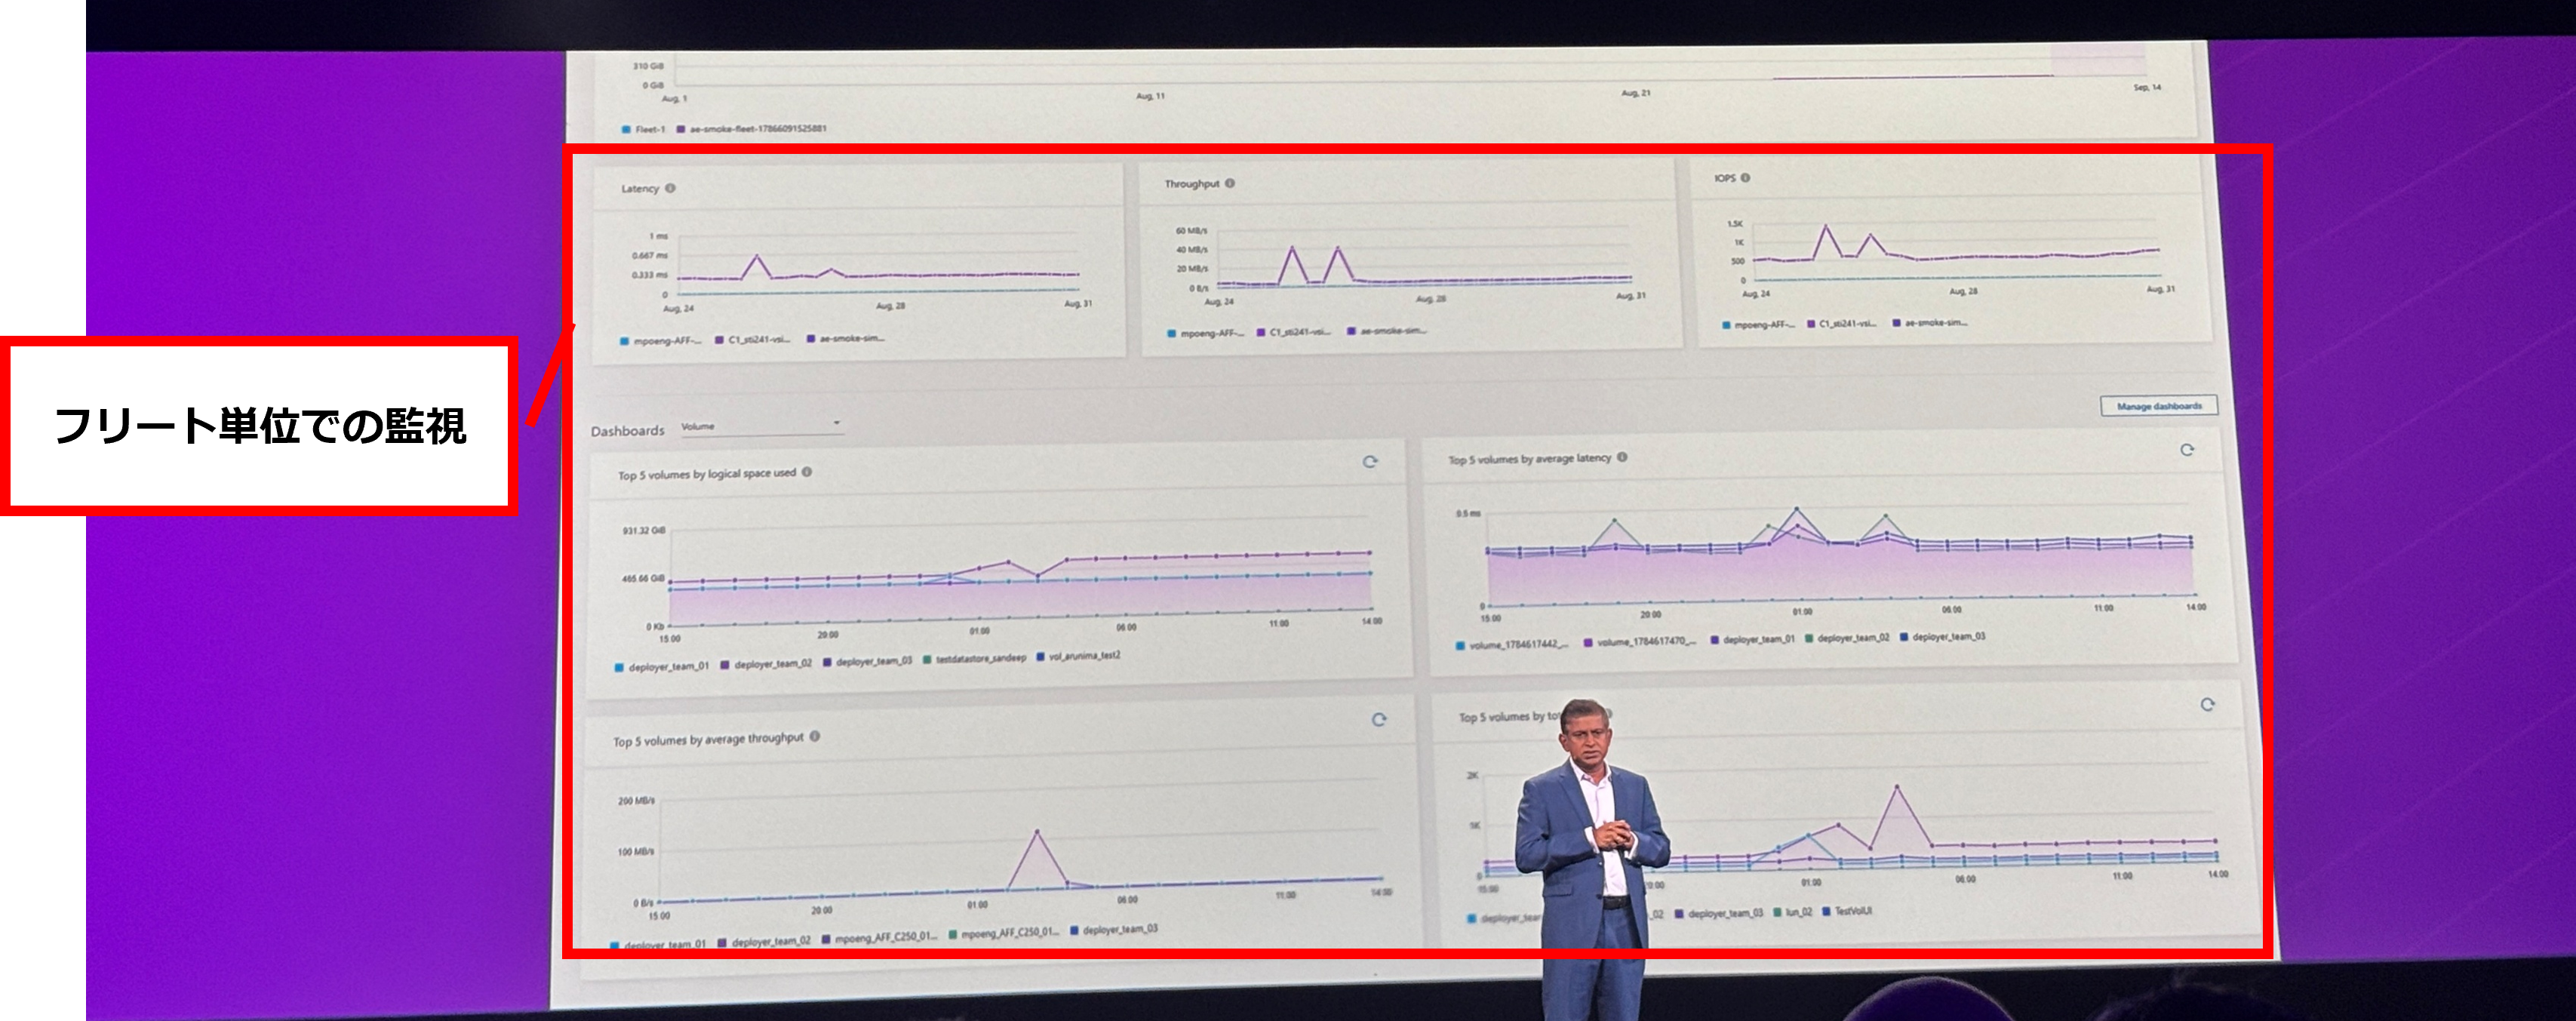
既存のActive IQ Unified Managerを利用しているお客様に対しては、単純な置き換えではなく、統合管理を強化するアップグレードパスとして紹介されました。
NetApp Console Autonomous Operations
これまで管理者がアラートを確認し、原因を調べ、対処方法を決めていた運用を、AIと自動化によって成果ベースで実行する仕組みです。
「容量不足を回避する」「性能劣化を解消する」といった目的に対して、NetApp Consoleが状況を分析し、あらかじめ定義されたガードレールの範囲内で修復を実行します。
※デモが行われなかったため、画像はありません。
もちろん、すべてをAIへ無条件に任せるのではなく、人による監督とポリシーの範囲内で動作することが前提です。
NetApp Console AI ChatOps Interface
NetApp Consoleは、単に画面を見るためのツールではなく、自然言語で会話しながら運用できるインターフェイスへ進化します。
例えば、以下のような指示を自然言語で実行できます。
- ボリュームを作成する
- レプリケーションを設定する
- ワークロードが遅くなった原因を調査する
- 環境全体のレポートを作成する
- 問題を予測し、定義済みのポリシーに従って修復する
また、オープンなLLMゲートウェイを利用し、お客様が選択したLLMと接続できる一方で、実行できる処理はストレージクラス、ポリシー、権限、ガードレールの範囲内に制限されます。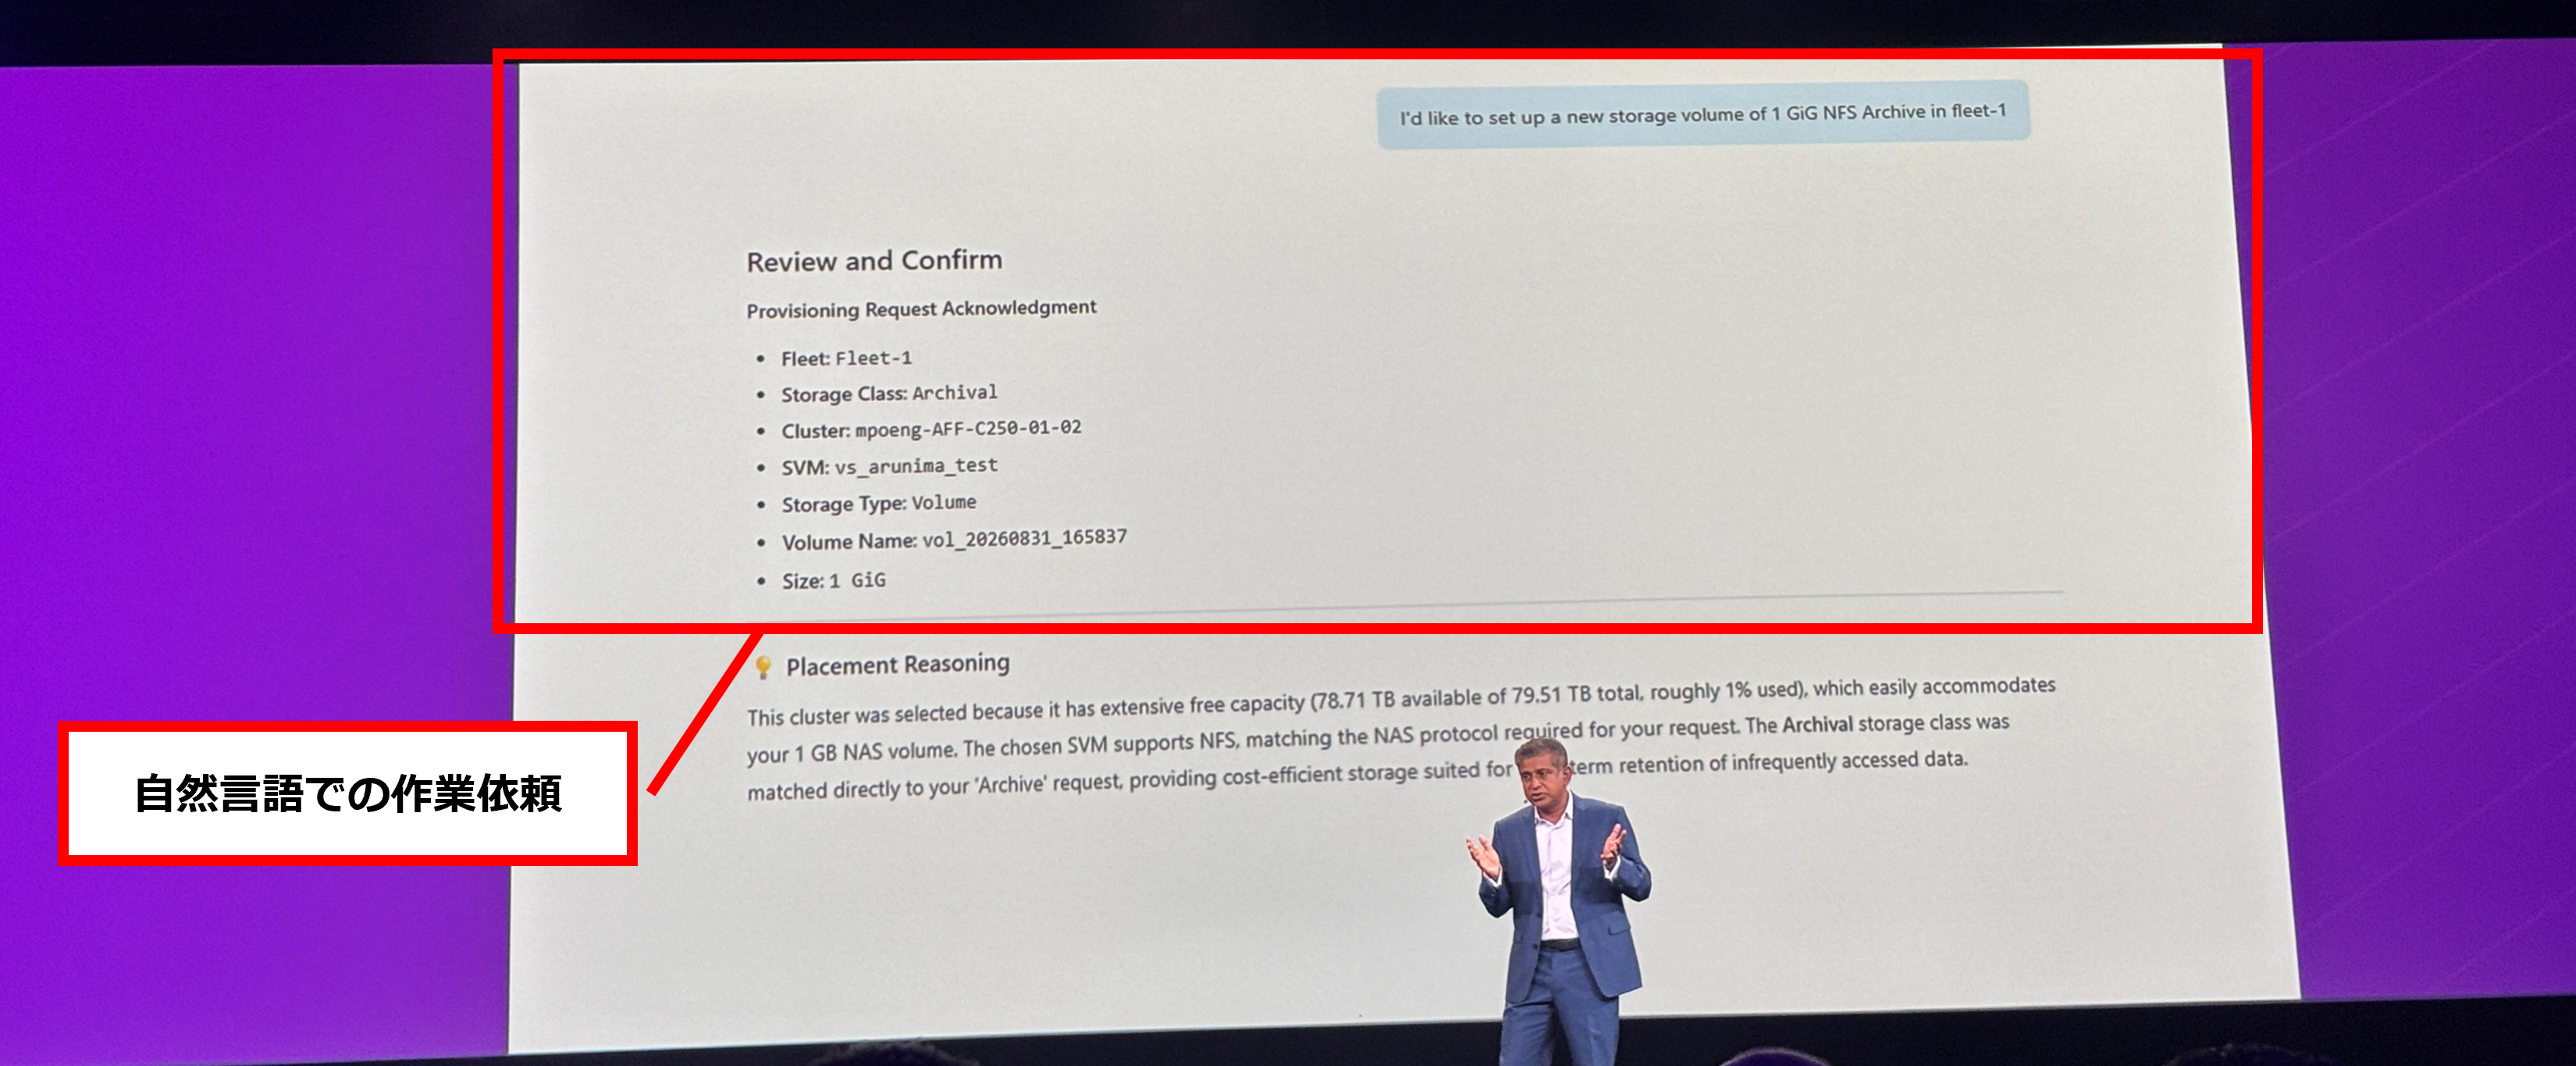
つまりNetApp Consoleは、複数環境の状態を一覧表示する管理画面から、環境全体の運用を支援・自動化するコントロールプレーンへさらなる進化を遂げようとしているといった内容でした。
また、外部ネットワークへ接続できない環境向けに、お客様の環境内で稼働するローカル版も紹介されました。
エアギャップ環境でも、同様の可視化や運用管理機能を利用できる構成です。
NetApp Consoleの公式サイトもアップデートされていますので、こちらもご覧になってみてください。
Keystone Sovereign:データだけでなく、サポートや運用も地域単位へ
最後はNetAppのStorage as a ServiceであるKeystoneに関するアップデートです。
新たに「NetApp Keystone Sovereign」が発表されました。
Keystone Sovereignは、European Economic Area(EEA:欧州経済領域)の規制要件やデータ主権を重視するお客様向けに、Keystoneへ追加できるソブリン対応のオプションです。
Keystone Sovereignでは、主に以下の仕組みが提供されます。
- 関連する顧客データ、ログ、バックアップ、テレメトリをヨーロッパ内に保持
- ヨーロッパを拠点とするサポートおよびエスカレーション
- ヨーロッパ内で管理されるアクセス/運用プロセス
- テレメトリ、監視、データフローの明確な文書化
- データ主権を補強する契約および法的な枠組み
キーノートでは、フランスとドイツで11月初旬から初期展開を開始し、その後対象地域を広げていく予定と説明され、その他地域に関しては明言されませんでした。
現時点ではヨーロッパ向けの発表ですが、サブスクリプション型サービスにおいても、データだけでなくサポートや運用を含めて「どこで、誰が扱うのか」が求められるようになっていることを示すアップデートだと思います。
Oracle、Google Cloud、Microsoftとのパートナーシップ
最後にNetAppとのパートナーシップについて簡単にまとめたいと思います。
複数のパートナー企業からビデオメッセージが寄せられていました。
Oracle
Oracleとのパートナーシップでは、ONTAPのデータ管理機能をOCI(Oracle Cloud Infrastructure)へネイティブに組み込むフルマネージドサービス「OCI NetApp Storage Service」が発表されました。
これにより、オンプレミスで利用しているONTAPの運用方法やAPI、データ保護、マルチプロトコル対応を大きく変えずに、AI、データベース、エンタープライズアプリケーション、EDA/HPCなどのワークロードをOCIへ拡張できるようになります。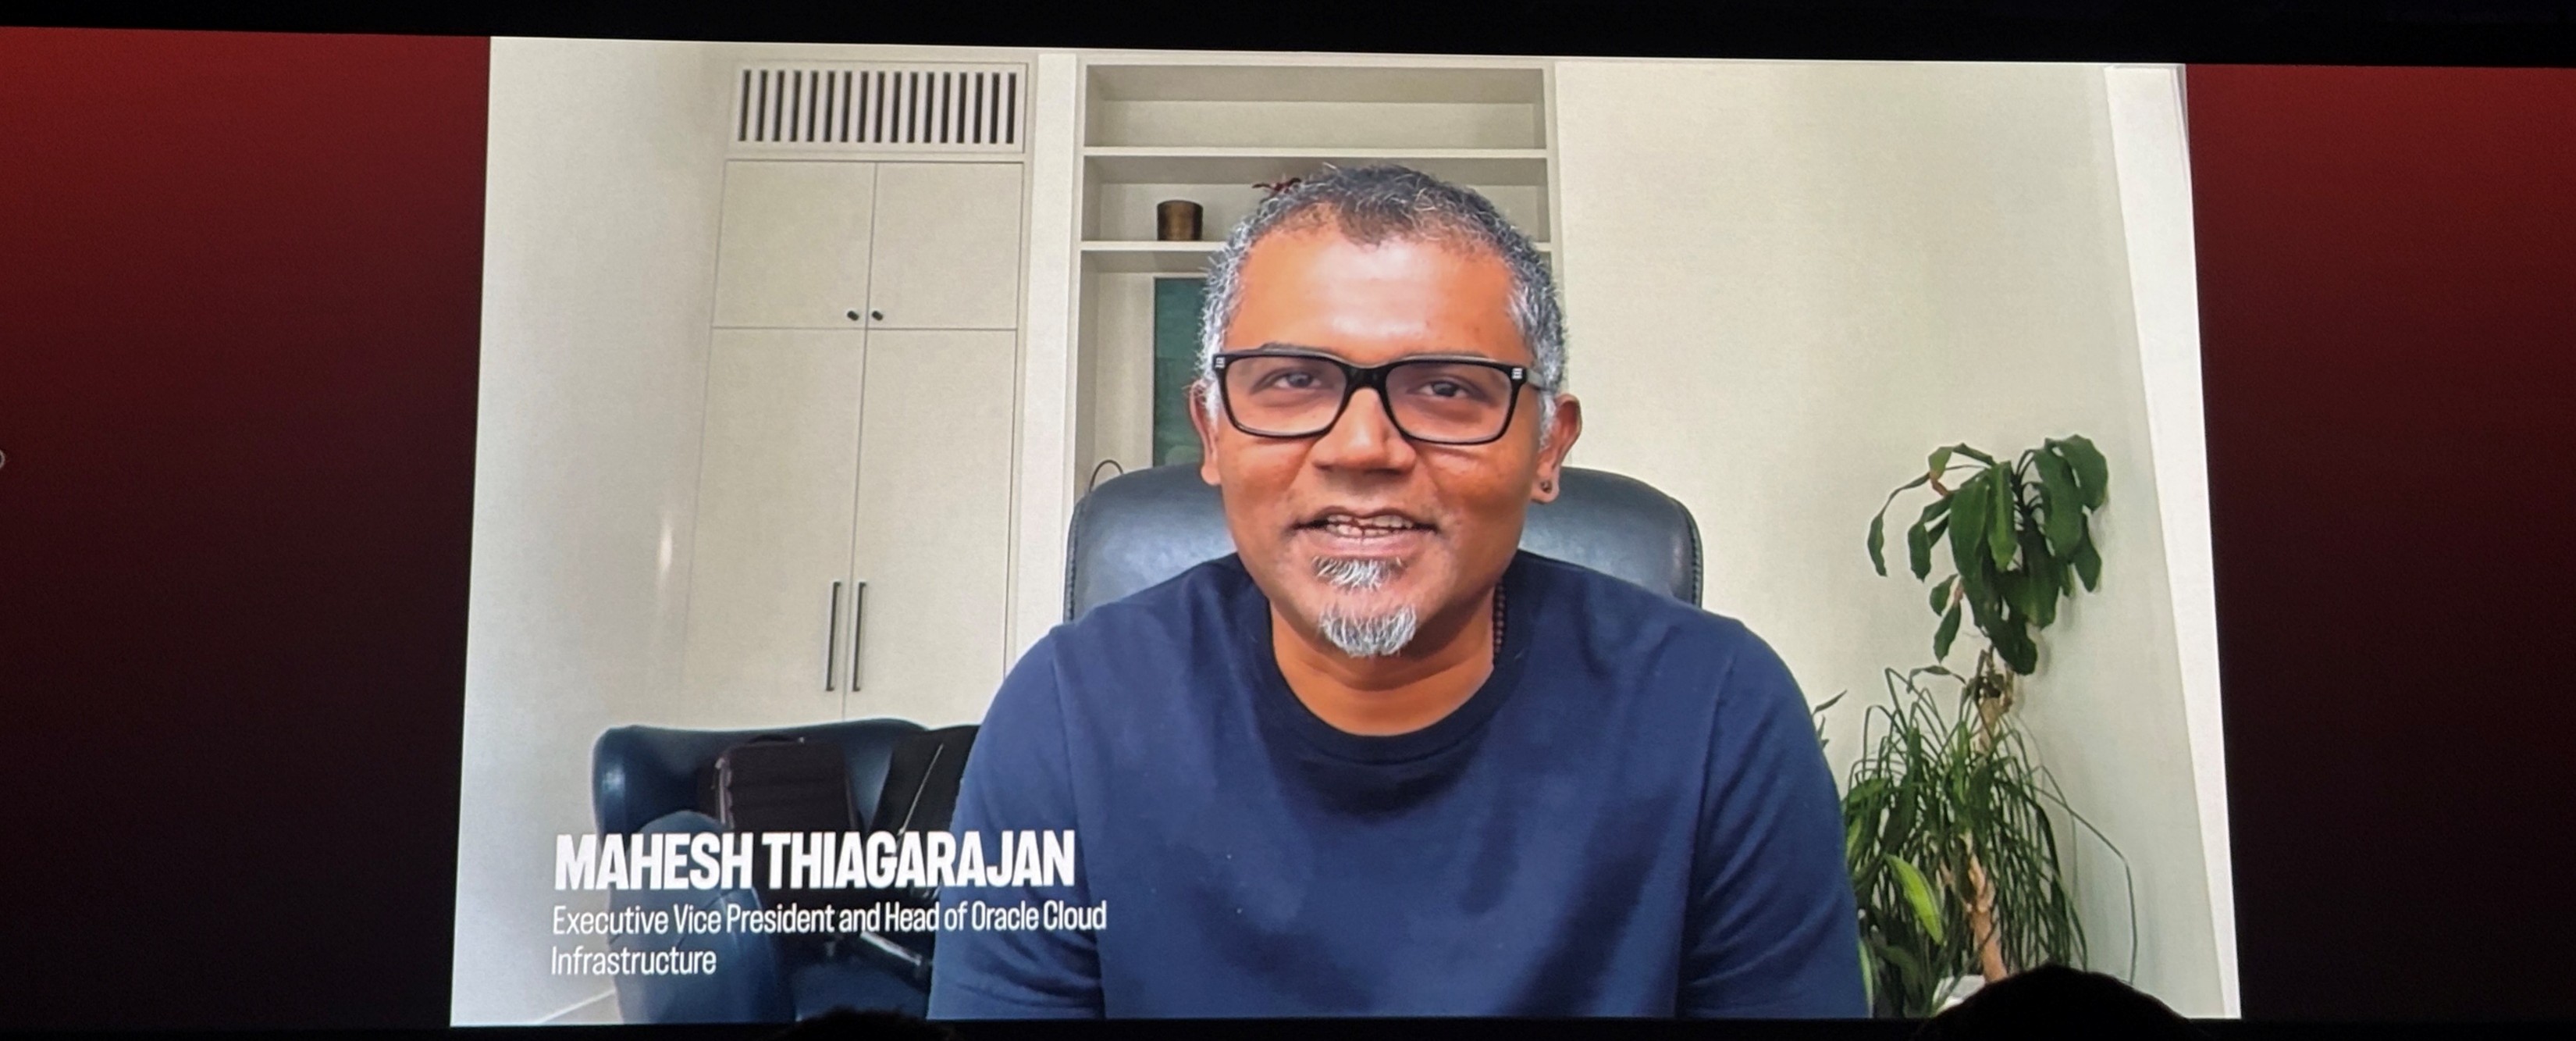
Google Cloud
Google Cloudとの連携では、Google Cloud NetApp Volumesを利用した大規模なデータセンター移行、最大200GB/s級の高性能ワークロード、Gemini EnterpriseとNetApp Volumesを組み合わせたRAG/AIエージェントについて紹介されました。
また、NetAppストレージはGoogle Distributed Cloudへネイティブに組み込まれ、規制の厳しい業界でも、エアギャップやソブリン環境の中でGeminiを利用できる方向性が示されています。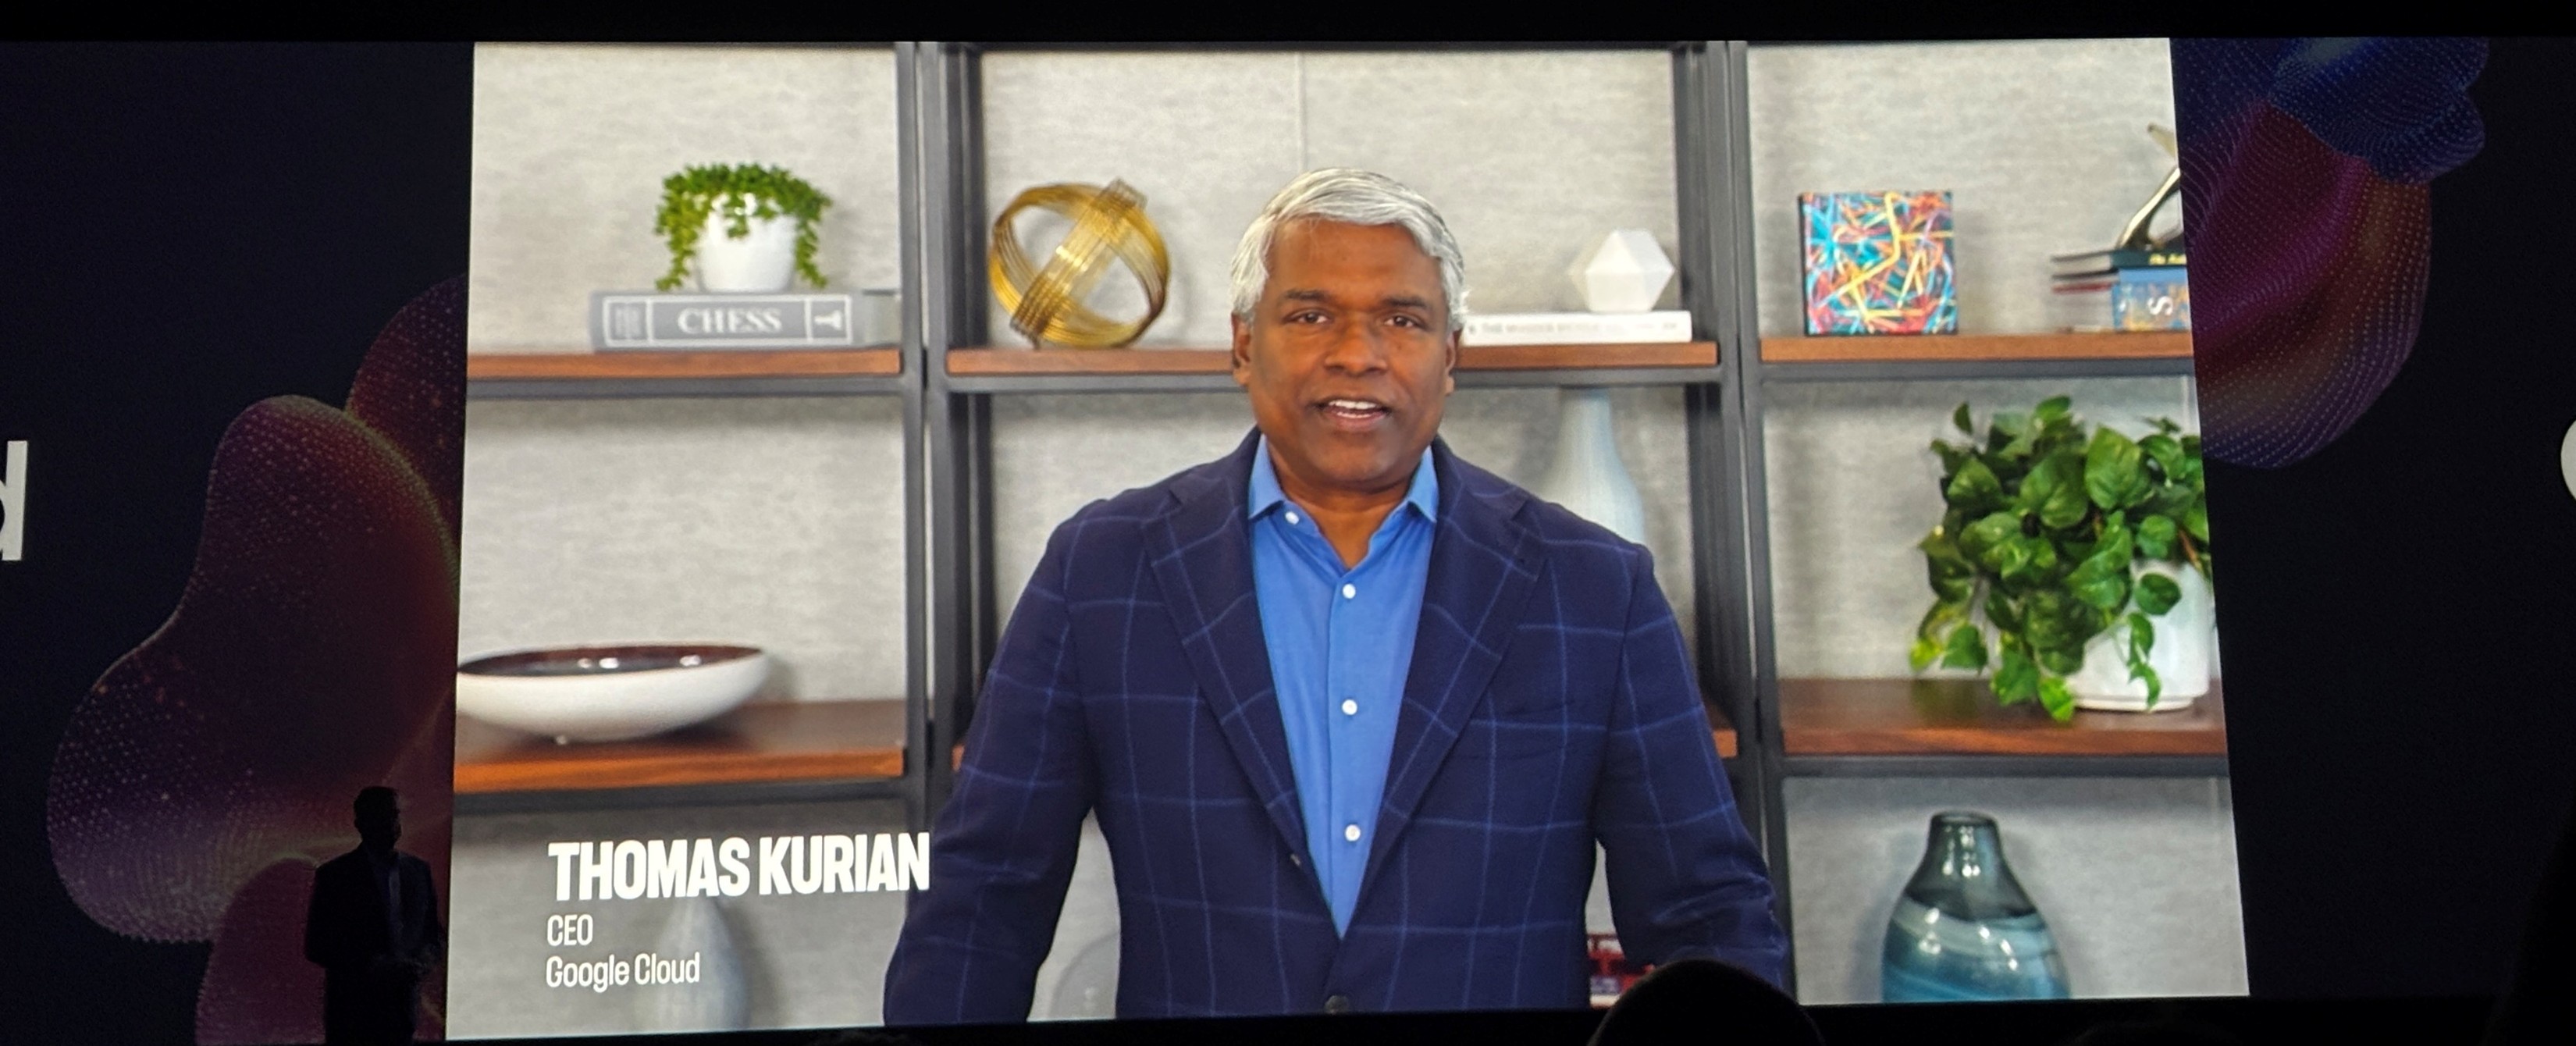
Microsoft
Microsoftとの連携では、ONTAPワークロードをAzureへ拡張する取り組みと、Azure NetApp Filesによる半導体設計、チップ検証、大規模エンジニアリングシミュレーションなどの高性能ワークロードが紹介されました。
MicrosoftのCloud/AI基盤とNetAppのデータ基盤を組み合わせることで、既存のデータやアプリケーションを活用しながら、ガバナンスと制御を維持してAIを導入できる点が強調されています。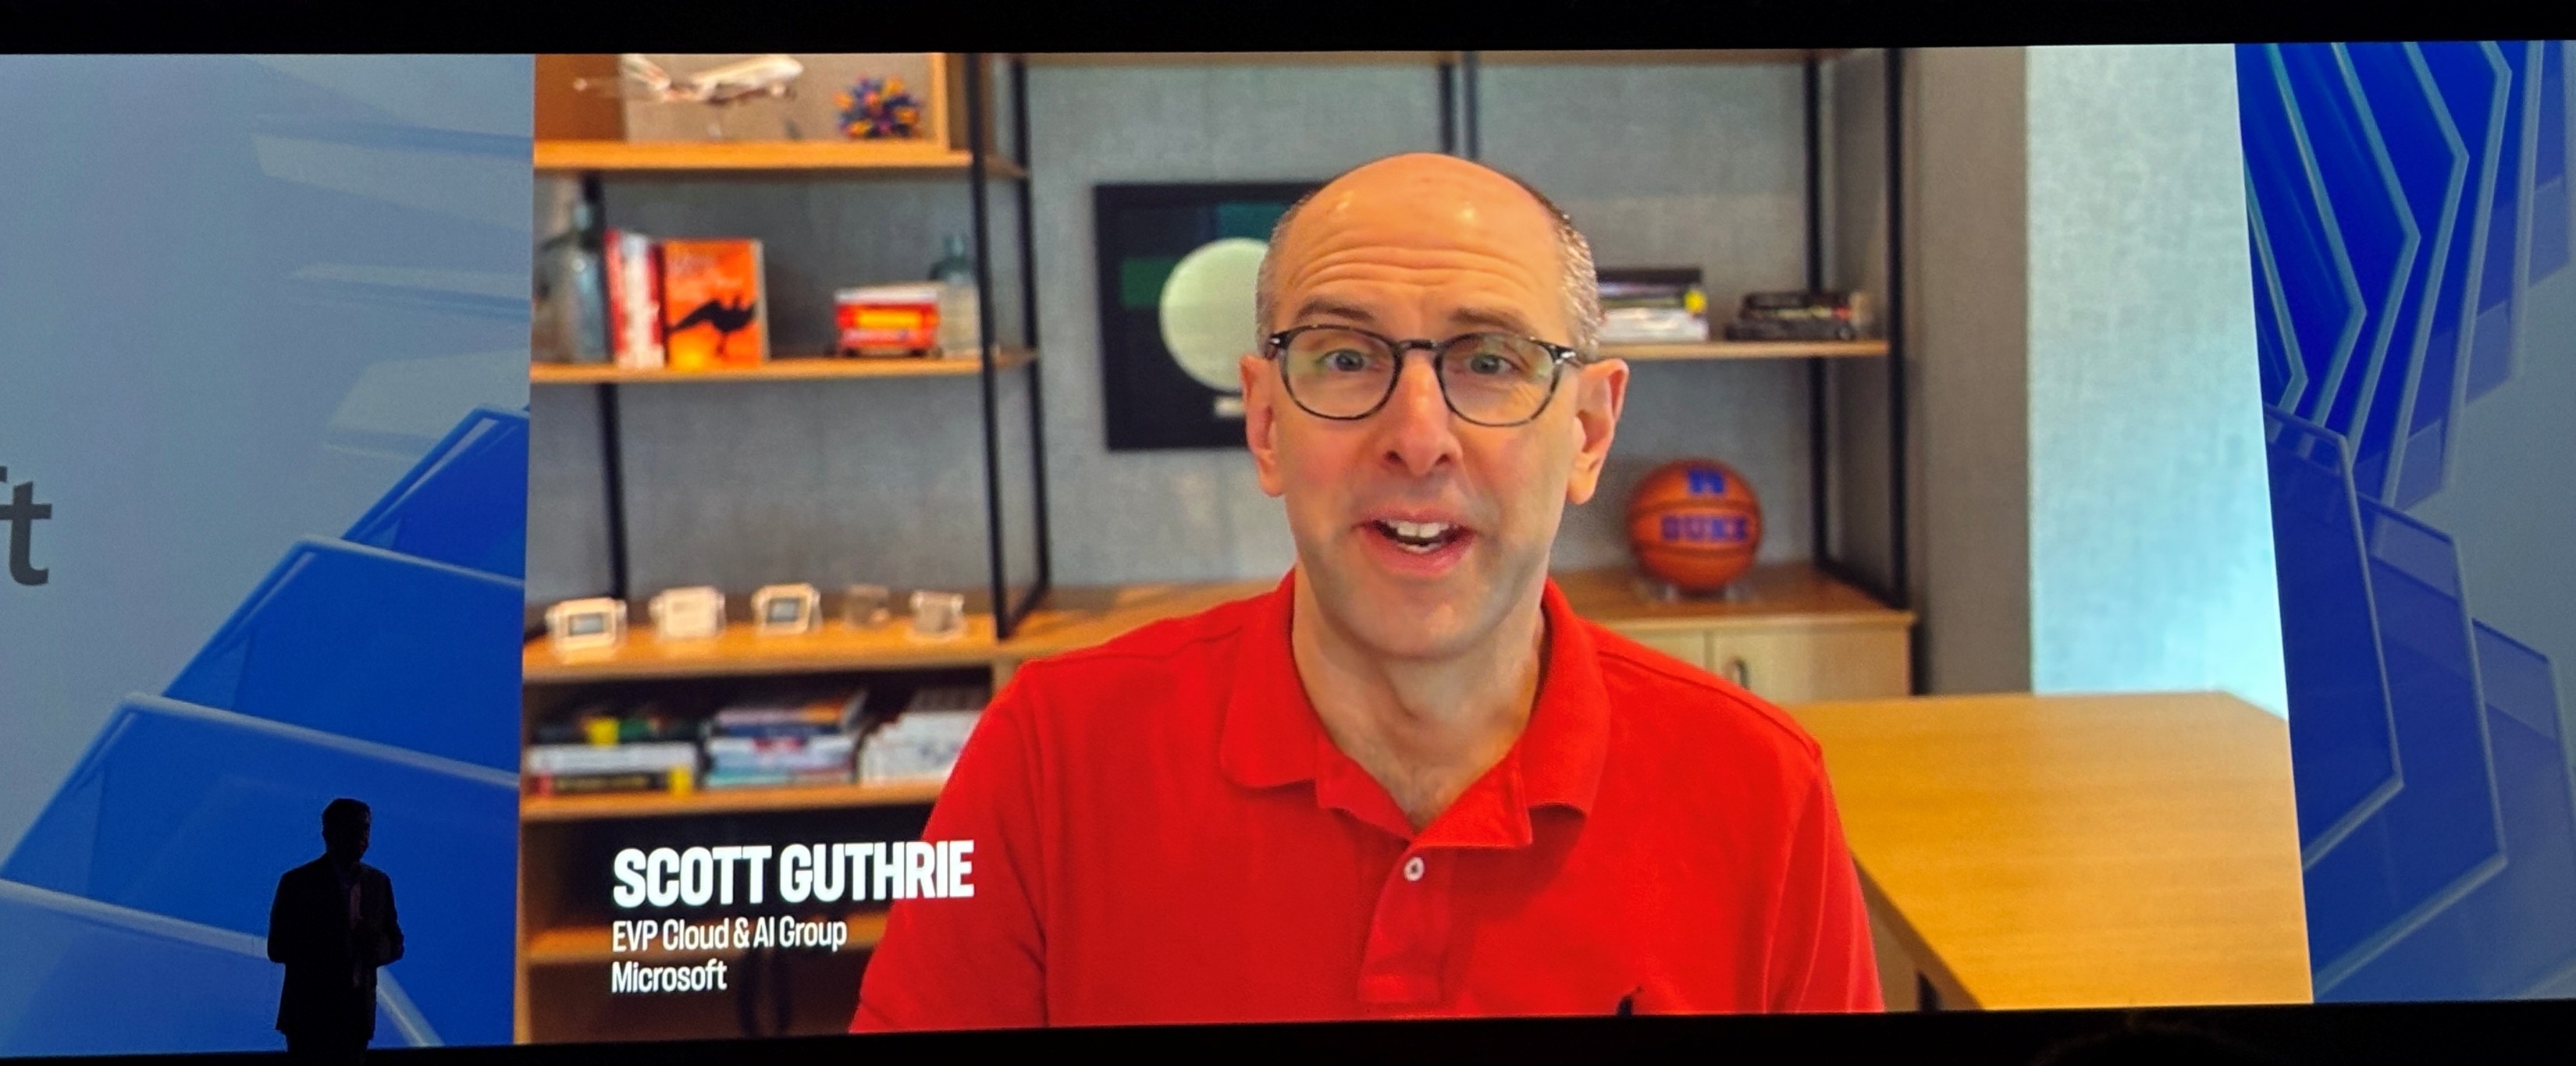
3社に共通するのは、お客様が既存のNetApp環境を捨てて作り直すのではなく、オンプレミスで利用してきたONTAPのデータサービスや運用性をクラウドへ拡張できるという点でした。
| Keynote Day2 |
Keynote Day2は、Syam Nair氏の登壇からスタートしました。
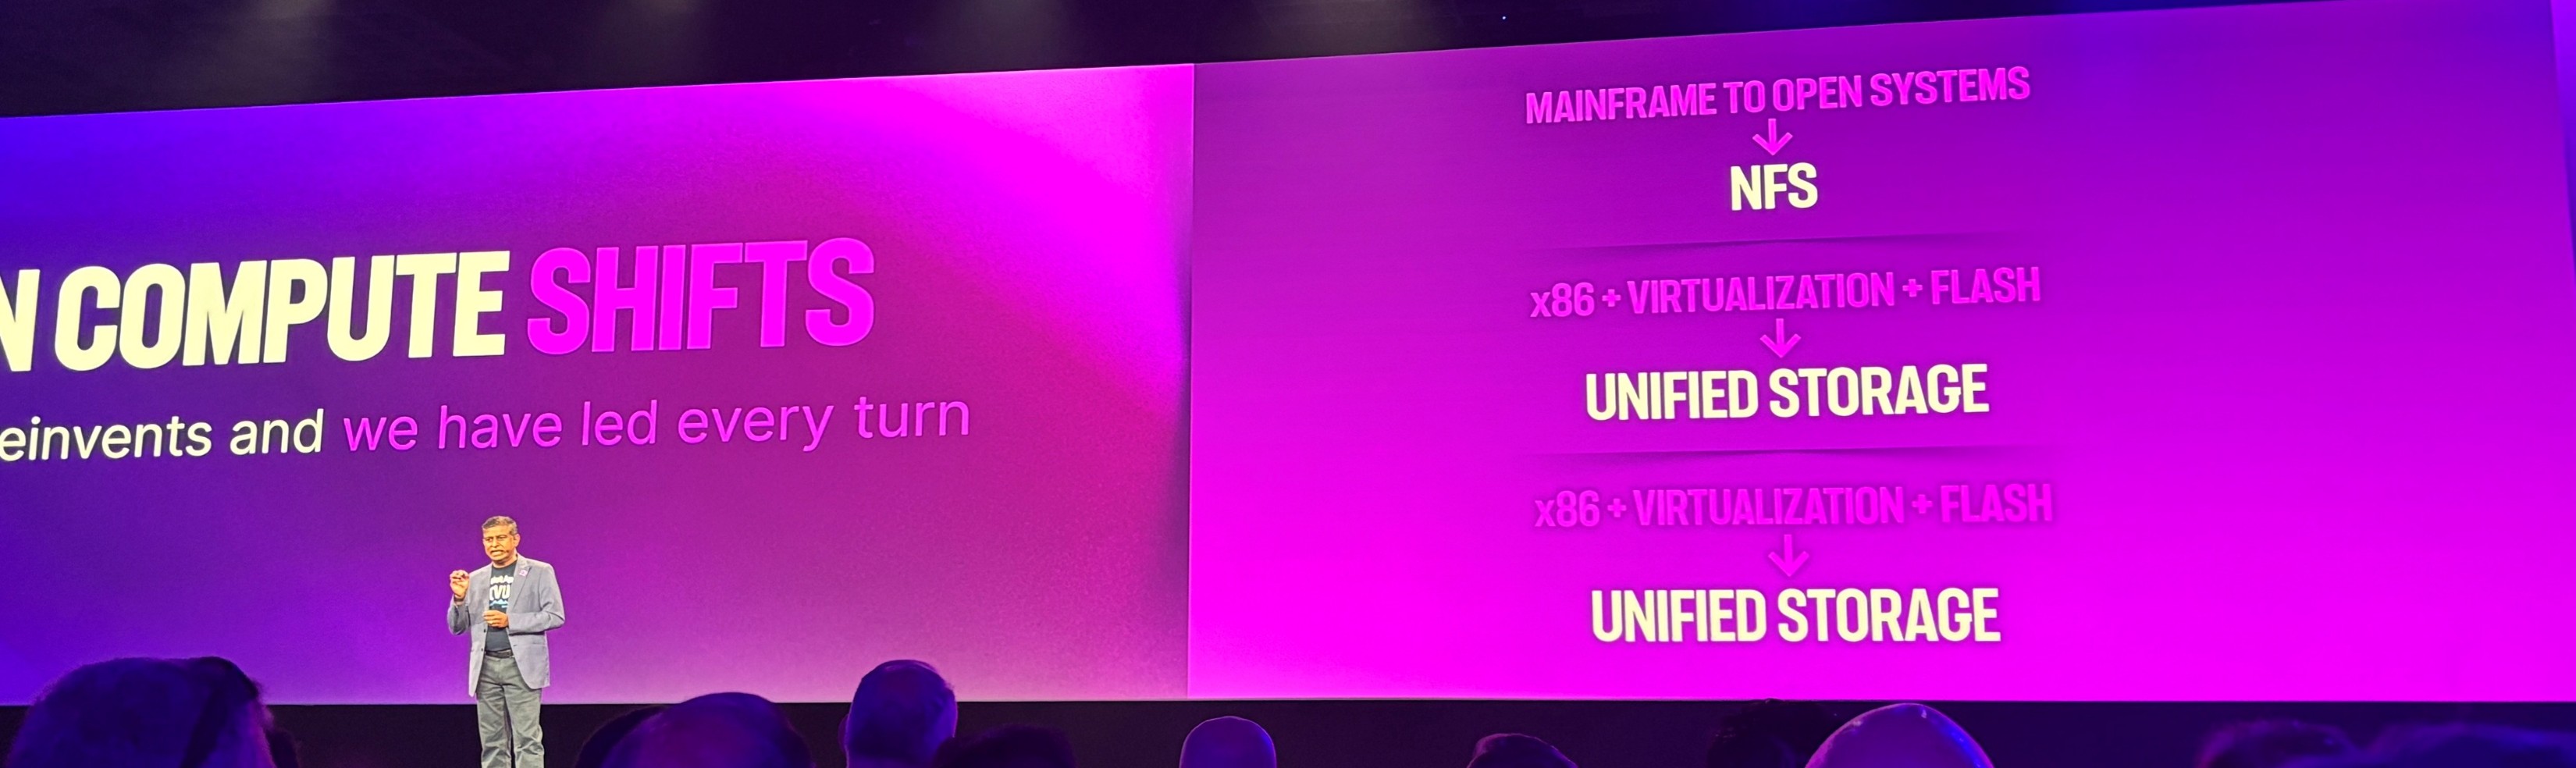
Day2では、Novusの詳細なアーキテクチャや実際のハードウェア構成など、具体的な話がメインとなっており、多くの場面で会場を沸かせていました。
※一部、Day1の記載内容と重複する部分がございますがご容赦ください。
AIファクトリーでは、GPUを止めないことが最も重要
Syam Nair氏は、AIファクトリーを、大量のGPUを集約し、電力とデータをAIモデルやトークンへ変換し続ける大規模なインフラと説明しました。
AIファクトリーはハイパースケーラーだけでなく、GPUをサービスとして提供するネオクラウド、各国のソブリンAI基盤や大企業にも広がっています。
これらに共通するのは、高価なGPUも、データを継続的に供給できなければ価値を生まないという点です。
Keynoteでは、AIクラウド事業者であるLambdaの担当者も登壇し、10,000基を超えるGPUクラスターで、NetAppと共同してストレージ基盤を提供していることが紹介されました。
50,000 GPU、100TB/s、1つのNamespace
続いてArindam Banerjee氏から、Novusのアーキテクチャが詳しく紹介されました。
- GPU数:50,000基
- GPU 1基あたりの継続的なデータ供給:約2GB/s
- 必要な合計性能:100TB/s
- GPUから見える構成:1つのNamespace
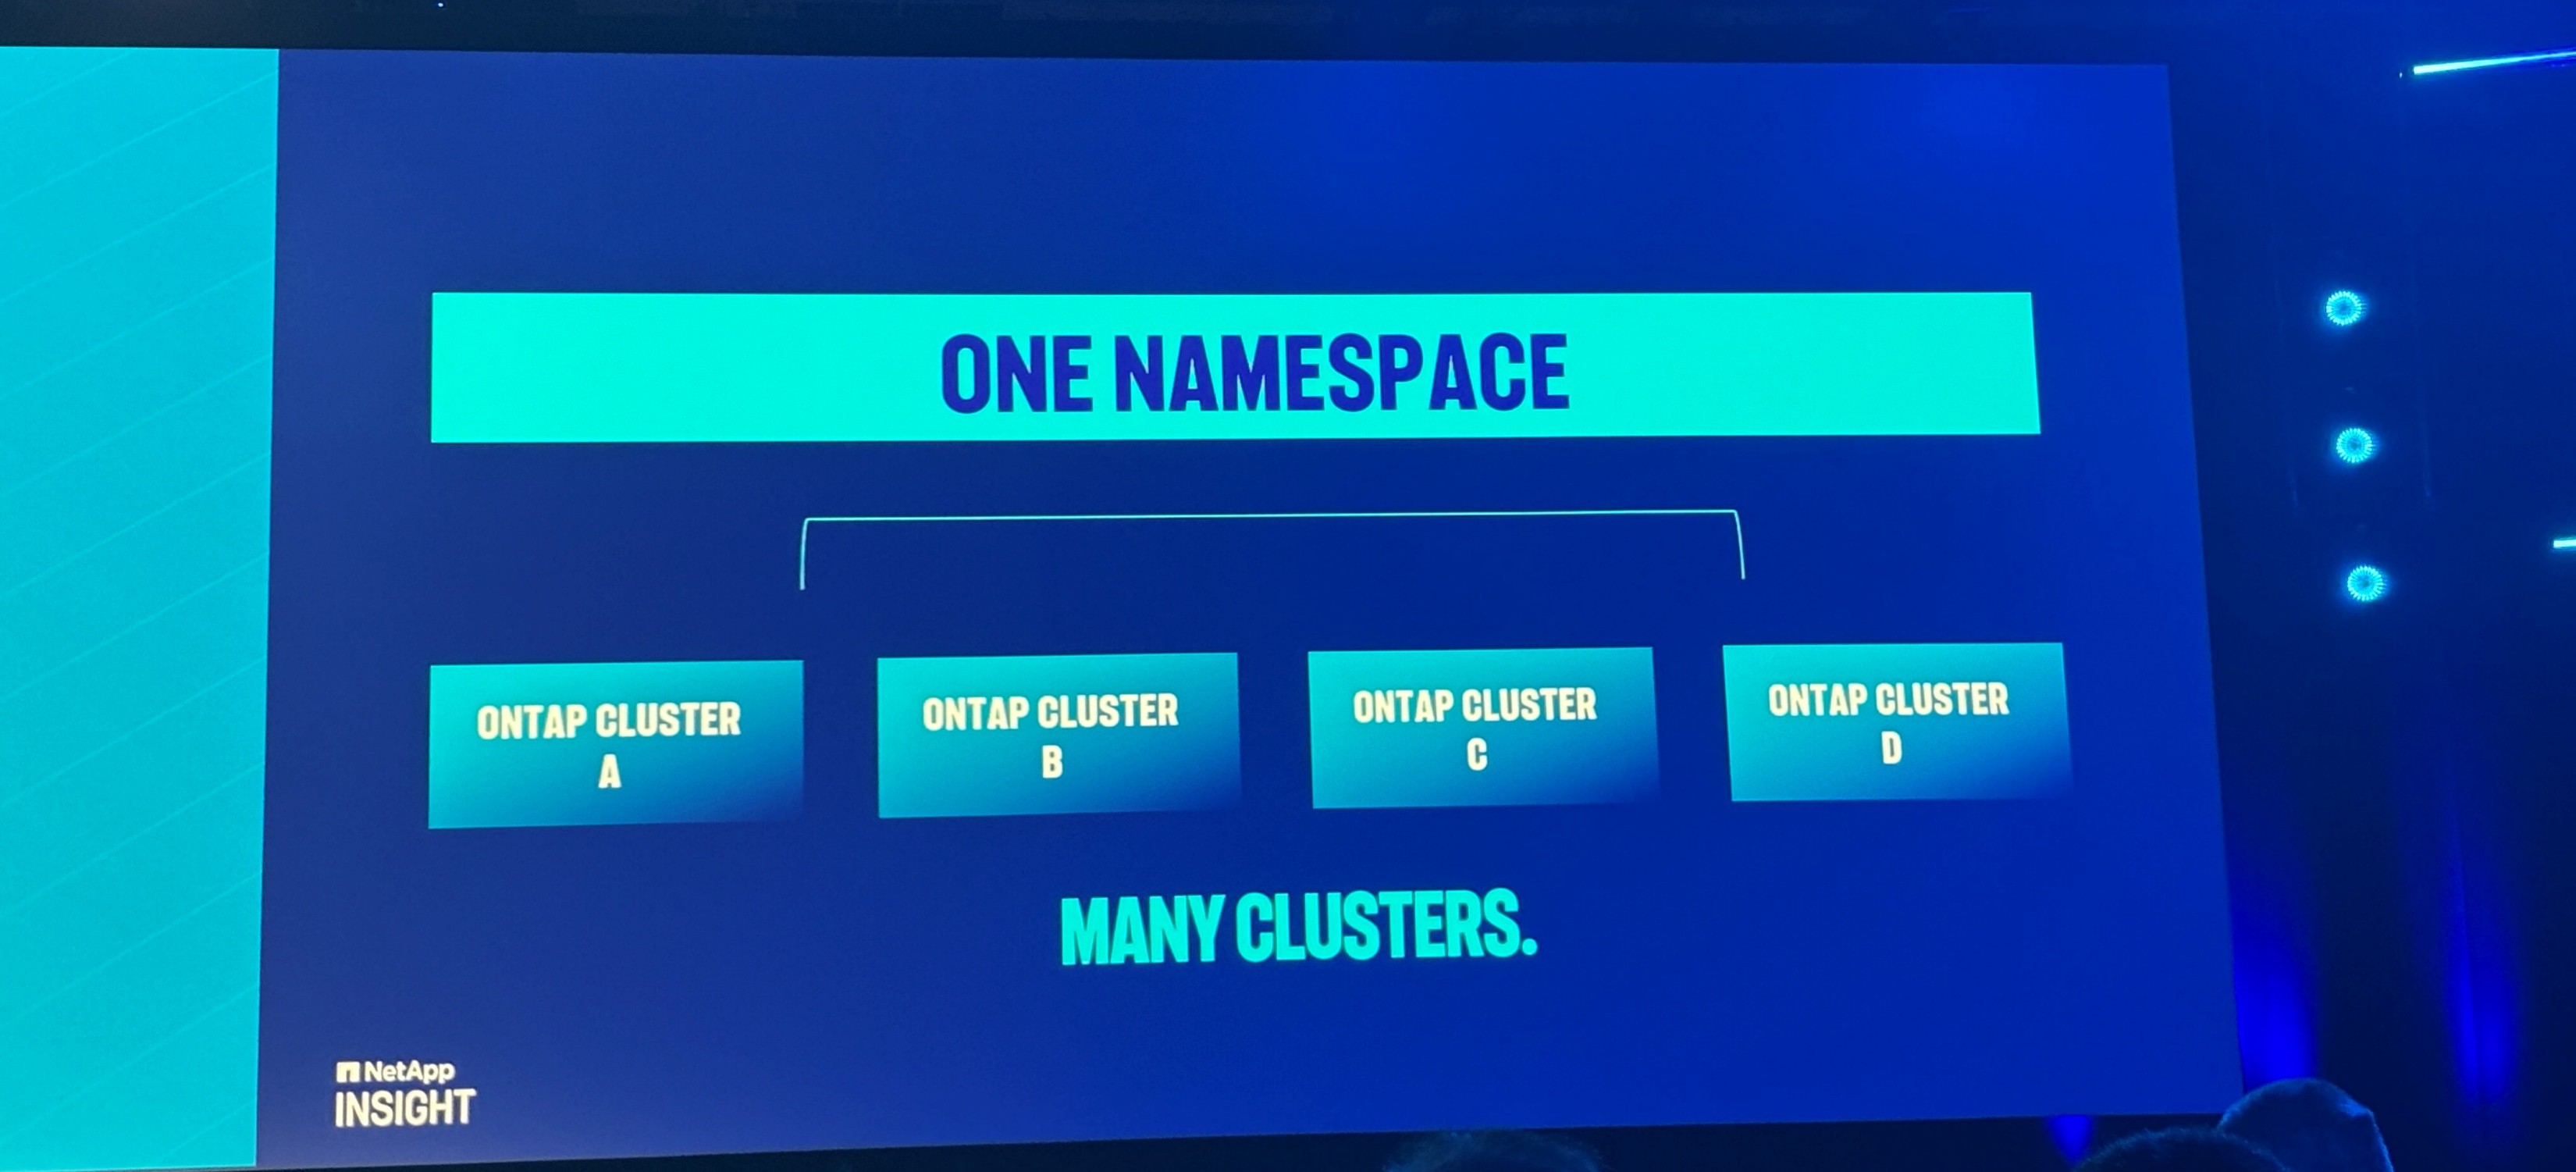
多数のストレージを並べるだけでは、ストレージごとに別々のマウントやNamespaceが生まれ、データ配置やCheckpointの連携をアプリケーション側で意識しなければなりません。
そこでNovusは、1つの巨大なクラスタを作るのではなく、独立した複数のONTAPクラスタを1つのNamespaceとして統合するFederation構成を採用しています。
ストレージクラスタを追加すると、そのクラスタの性能と容量が全体へ追加されますが、GPUサーバーからは引き続き1つのファイルシステムとして見えます。
アプリケーション側で再マウントやデータの再配置を行う必要はありません。
Latticeでメタデータ処理を分散
メタデータと実データを分けるだけでは、メタデータサーバーそのものが新しいボトルネックになります。
そこでNovusでは、Day1でGary Grider氏から紹介されたLatticeの考え方を取り入れ、NFSセッションなどのプロトコル処理を担当する部分と、ファイルのメタデータを保持する分散Key-Value型のカタログを分離し、それぞれを負荷に応じて独立して拡張できるようにしています。
これにより、接続するクライアント数が増えた場合と、管理するファイル数が増えた場合で、必要な処理だけを個別に拡張できます。
Keynoteでは、毎秒1,000万回規模のメタデータ操作を想定していると説明されました。
データ層にはONTAPを利用
Novusのデータ層にはONTAPクラスタが利用されます。
そのため、性能だけでなく、データ整合性、高可用性、セキュリティ、マルチテナント、Quality of ServiceといったONTAPの機能も利用します。
AIファクトリーの規模では、障害は例外ではなく、どこかで常に発生し得る状態です。
1つの障害で同期学習全体を停止させないため、Novusは100TB/sという性能と、継続運用の両立を重視しています。
NVIDIAのVP of Storage TechnologyであるJason Hardy氏も登壇し、AIファクトリーではスループットだけでなく、チェックポイント、モデルの読み込み、可用性を含めてストレージを設計する必要があると説明しました。
Novusのハードウェア構成
NetAppのVP of Product ManagementであるGunna Marripudi氏から、Novusの初期構成についても紹介されました。
- NetApp Novus Data Director:メタデータを管理するソフトウェア。認定済みx86サーバーで動作
- NetApp AFF A90:ONTAPを搭載し、実データを保存・転送する
Novus Data Directorの最初のエコシステム パートナーとして、Supermicroも紹介されています。
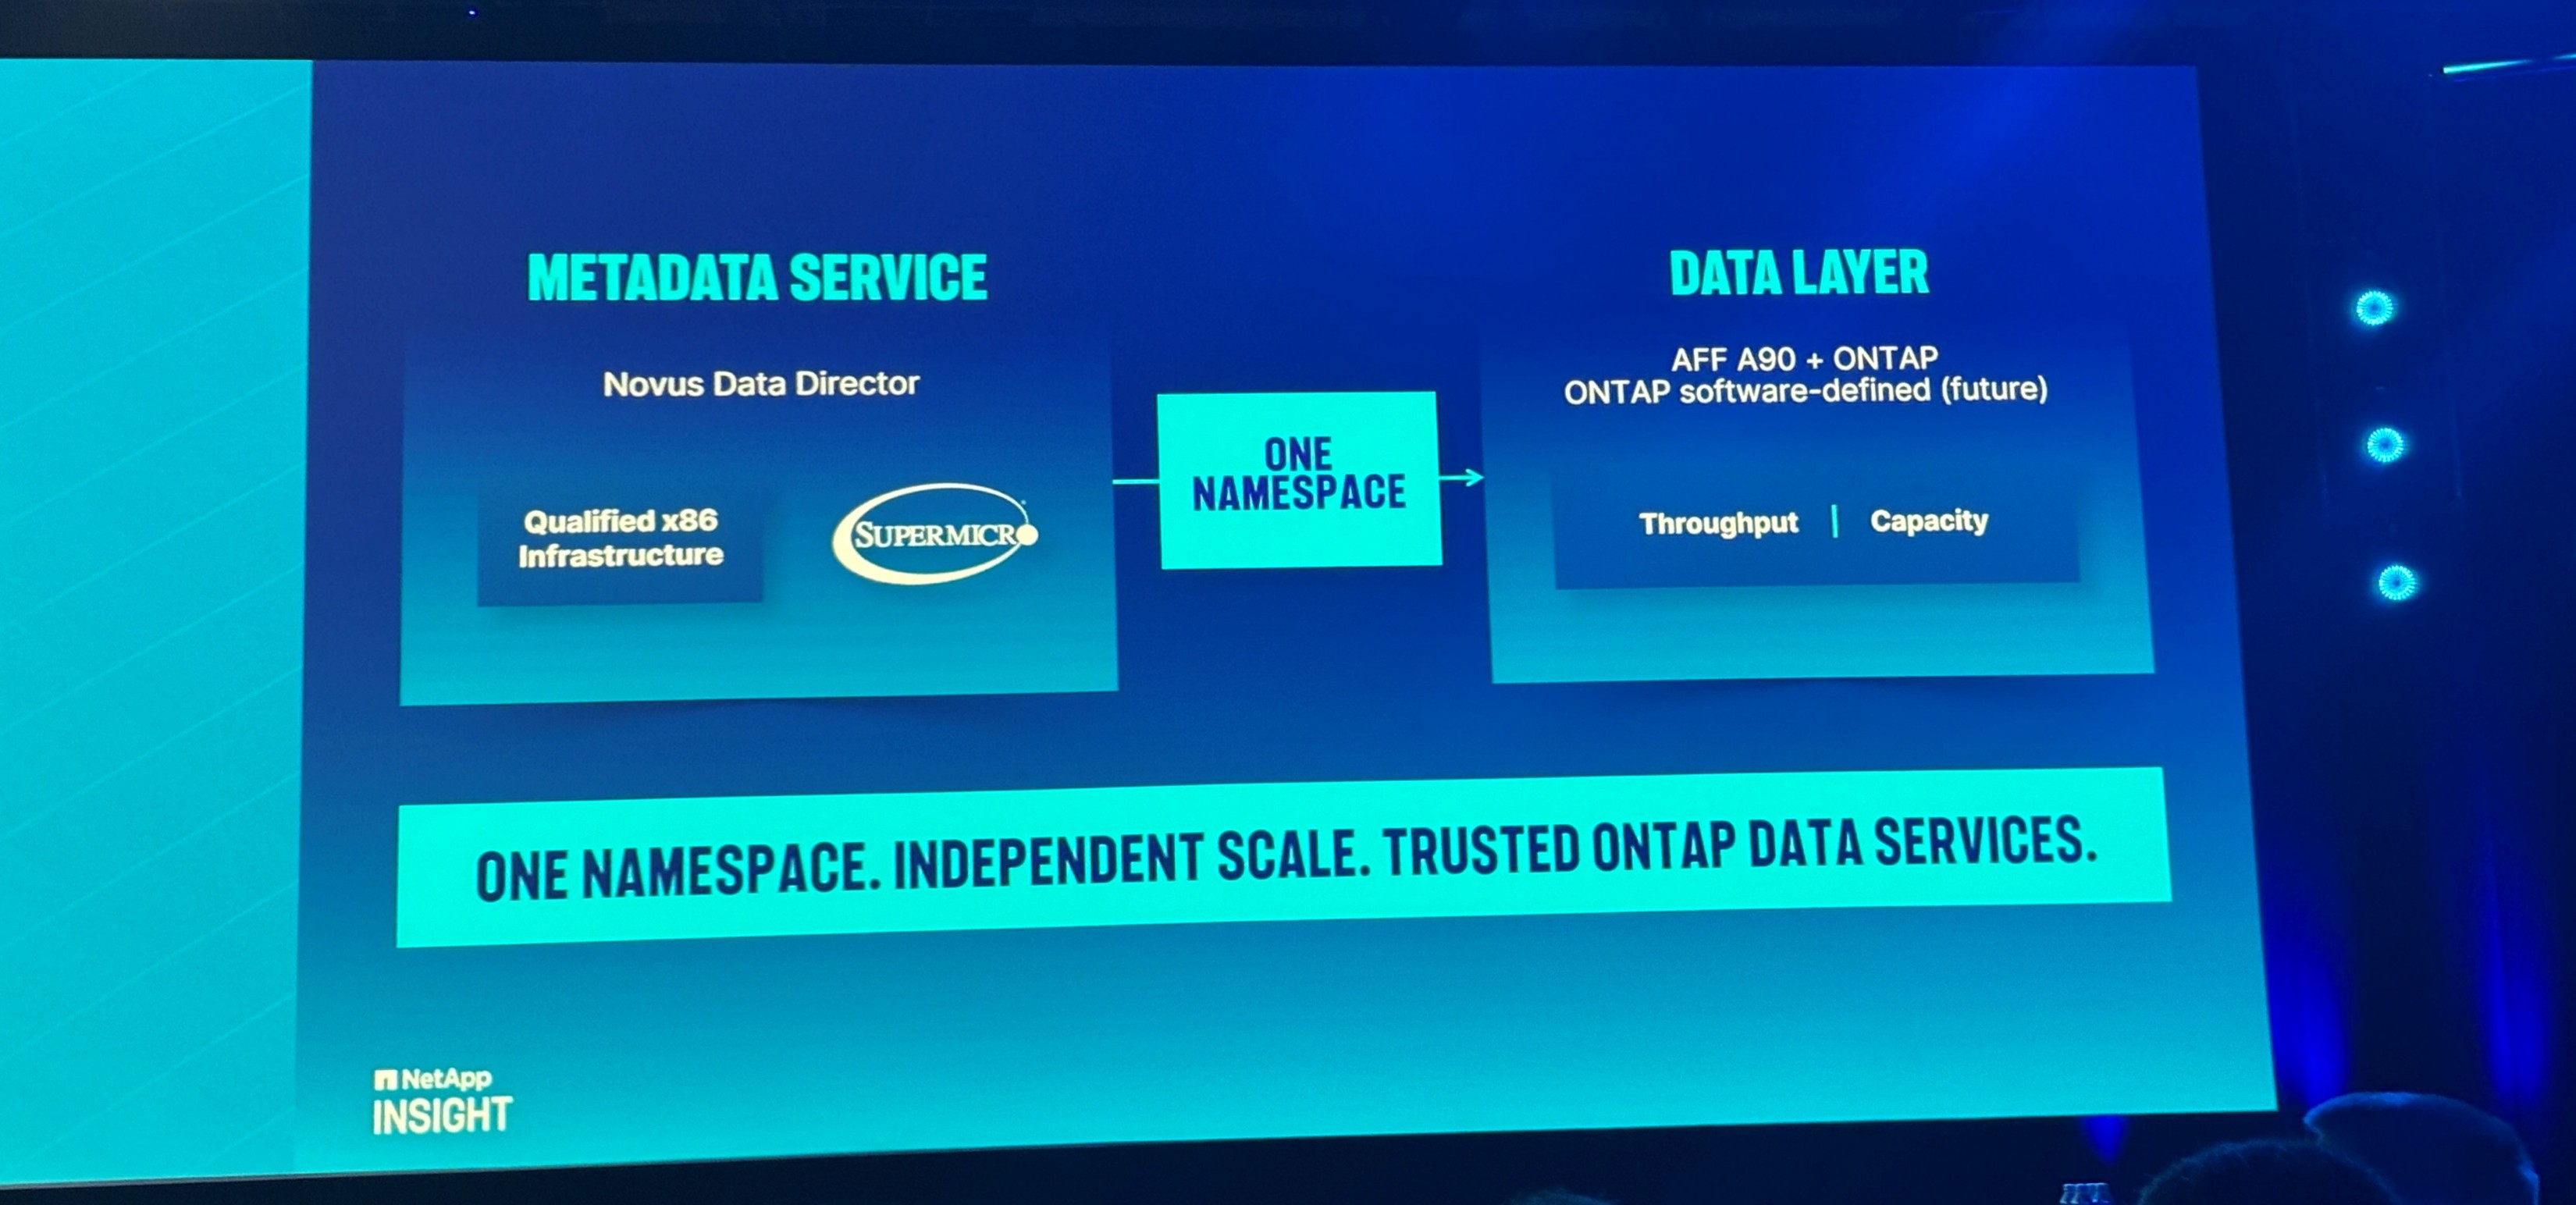
また、将来の構想として、業界標準のx86サーバーとローカルNVMeストレージで動作するSoftware-defined Data Layerも紹介されました。
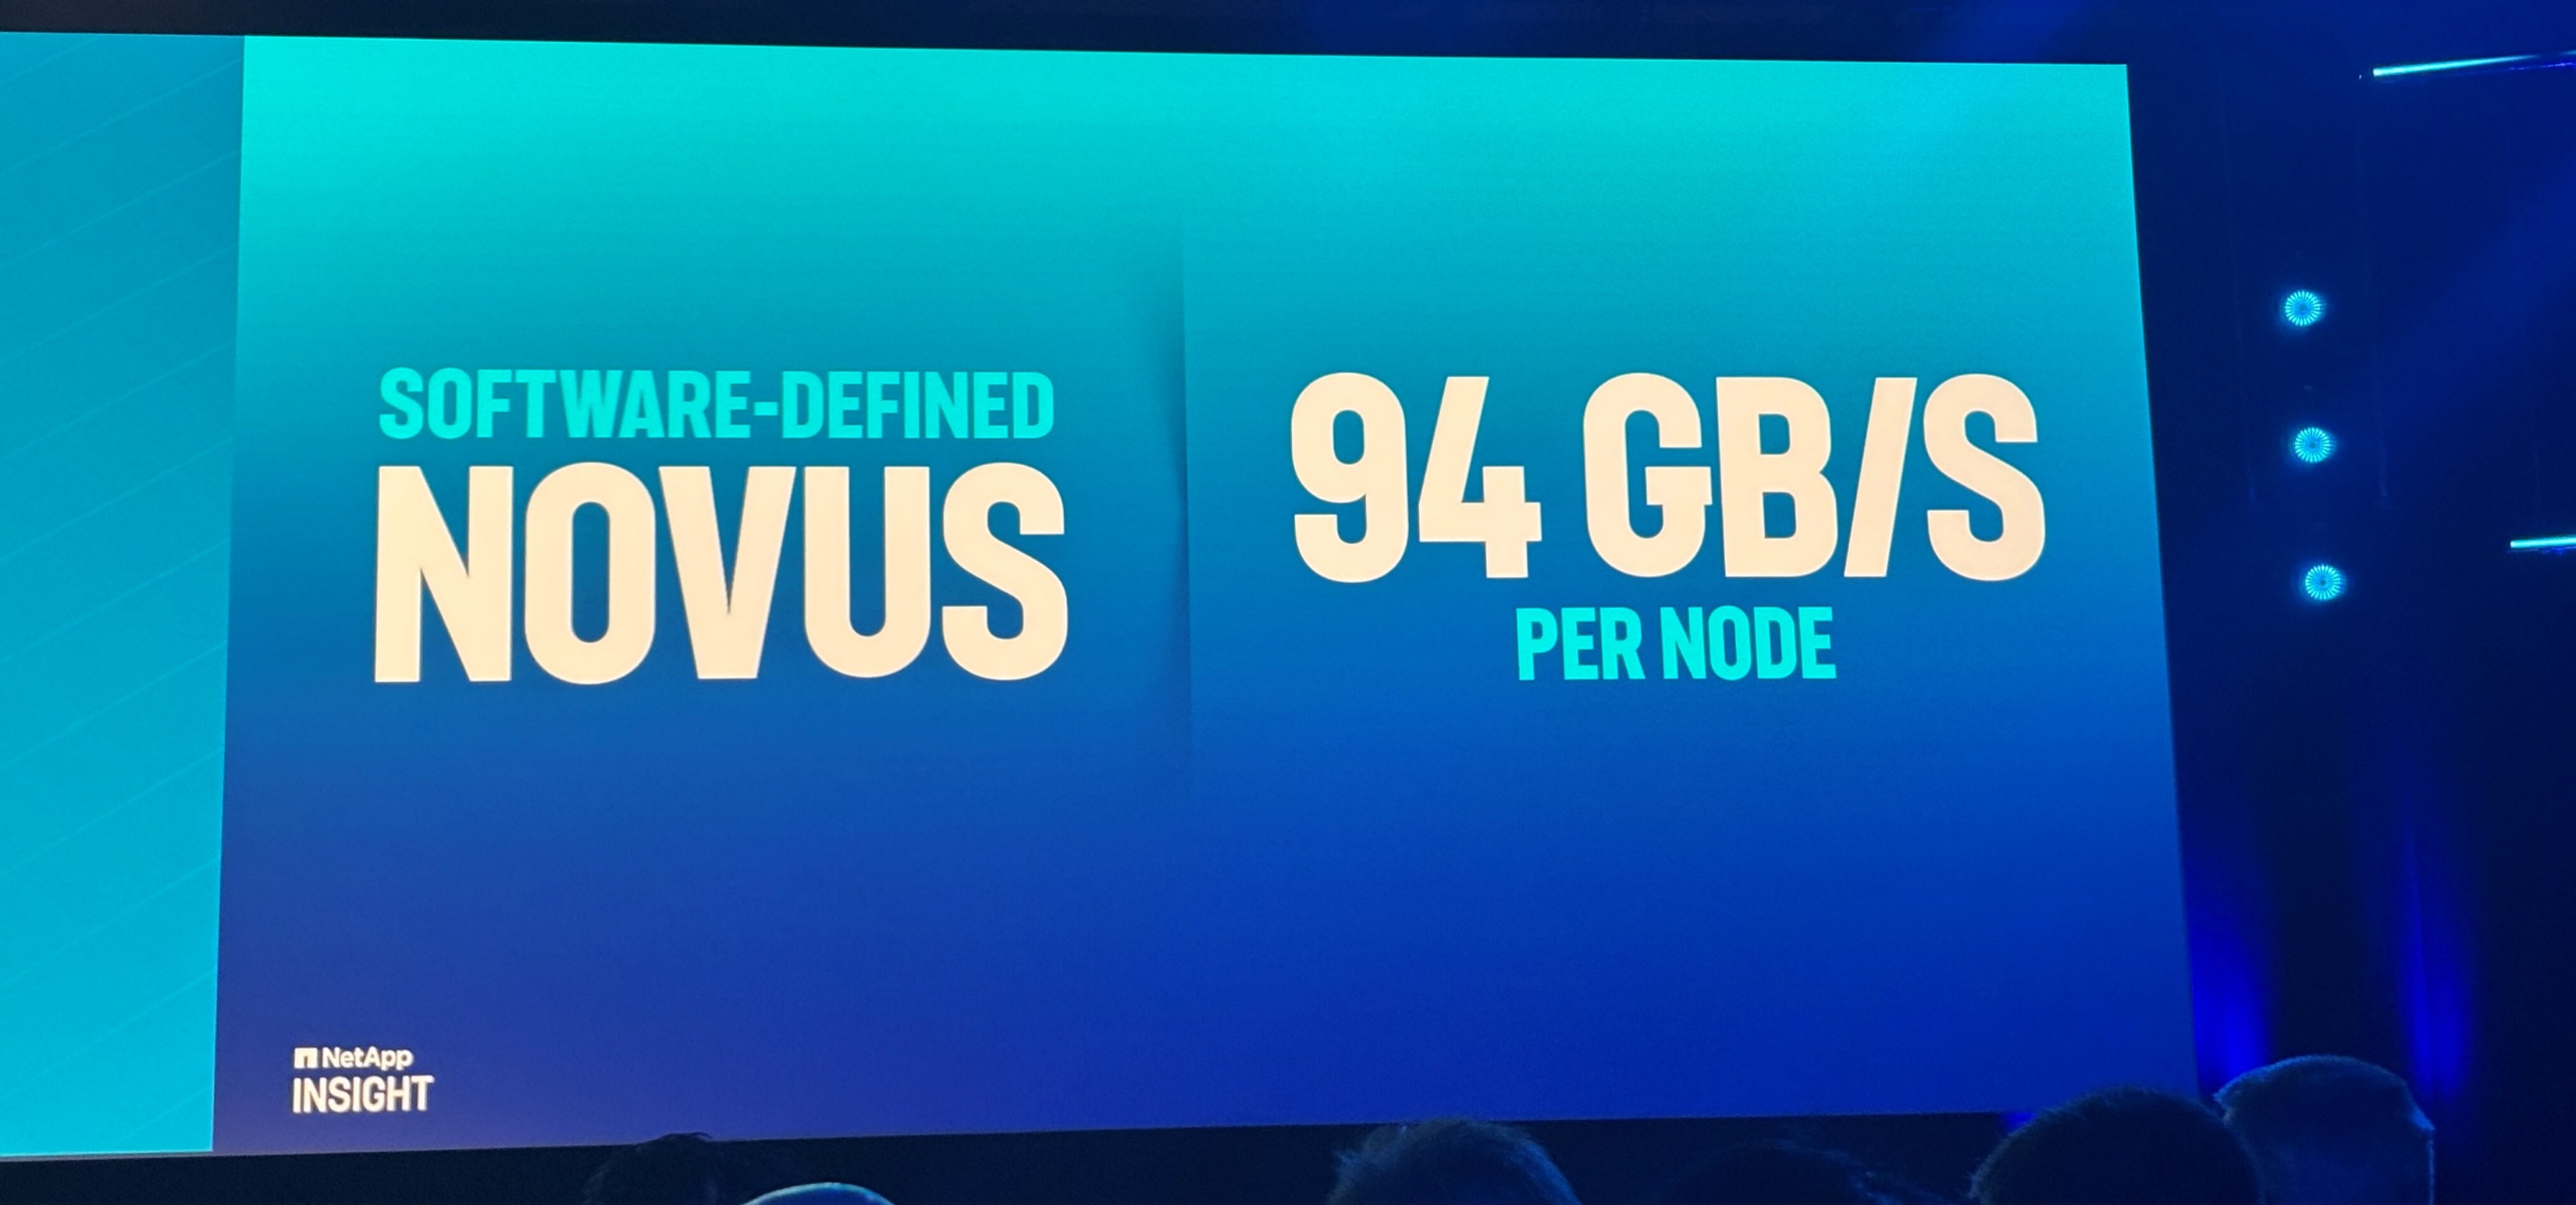
Keynoteでは、1ノードあたり最大94GB/sという数値が示されています。
さらに、GPUメモリから退避されたKVキャッシュをNovusへ保存し、再利用することで、ストレージをGPUメモリの永続的な拡張として利用する構想も説明されました。
複数テナントを管理する運用デモ
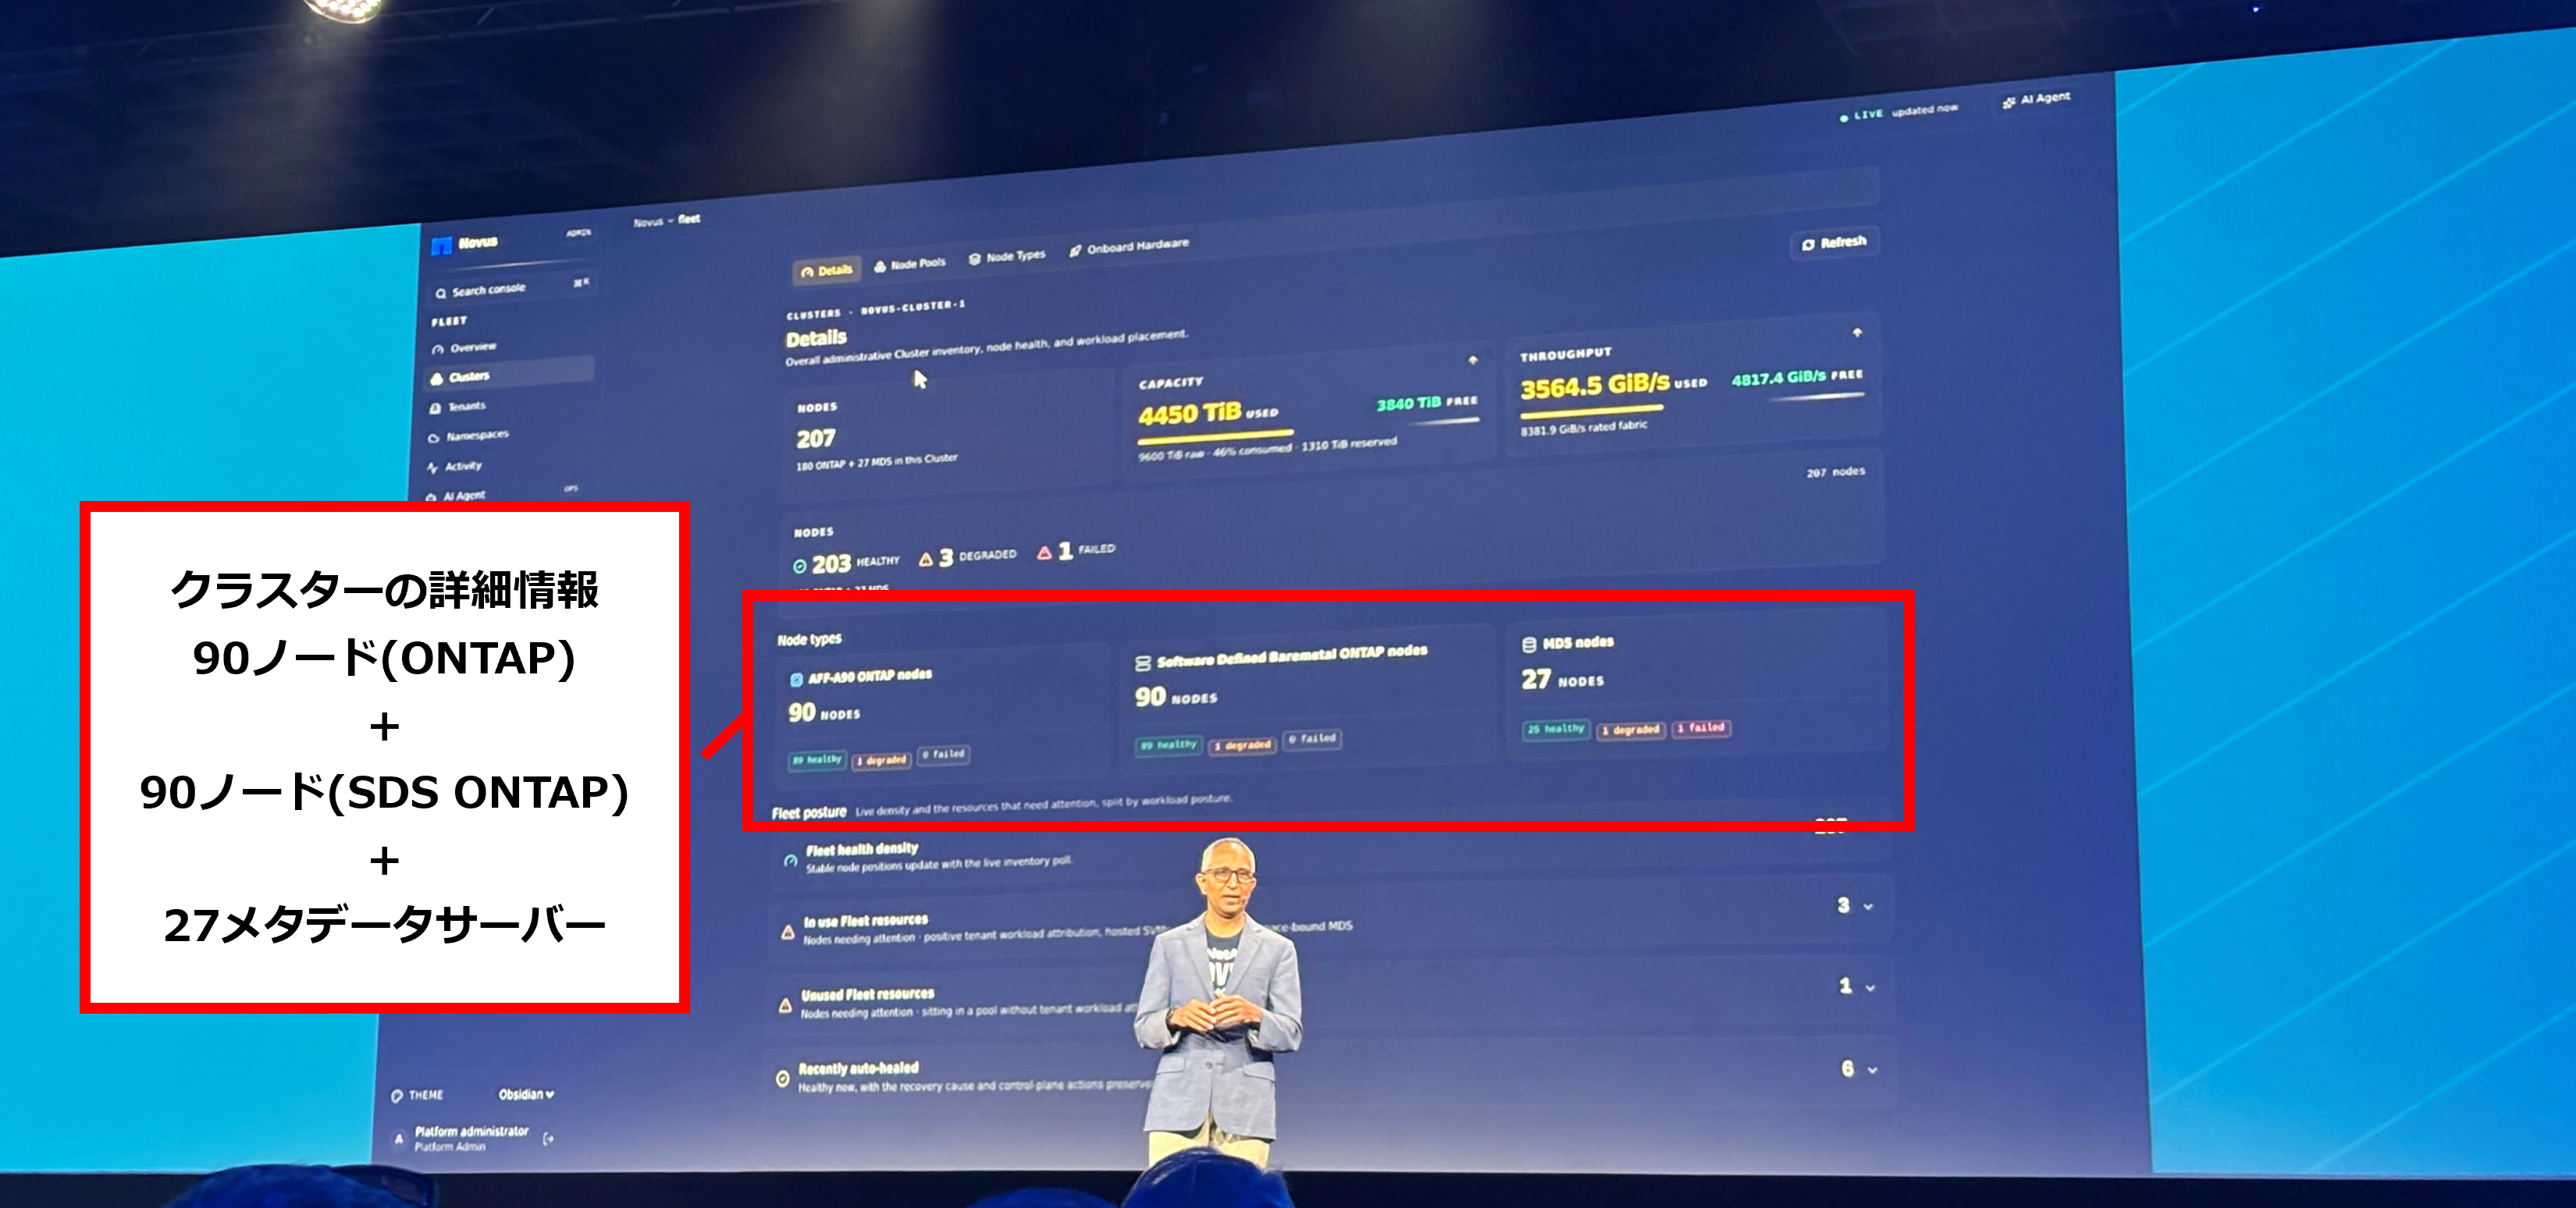
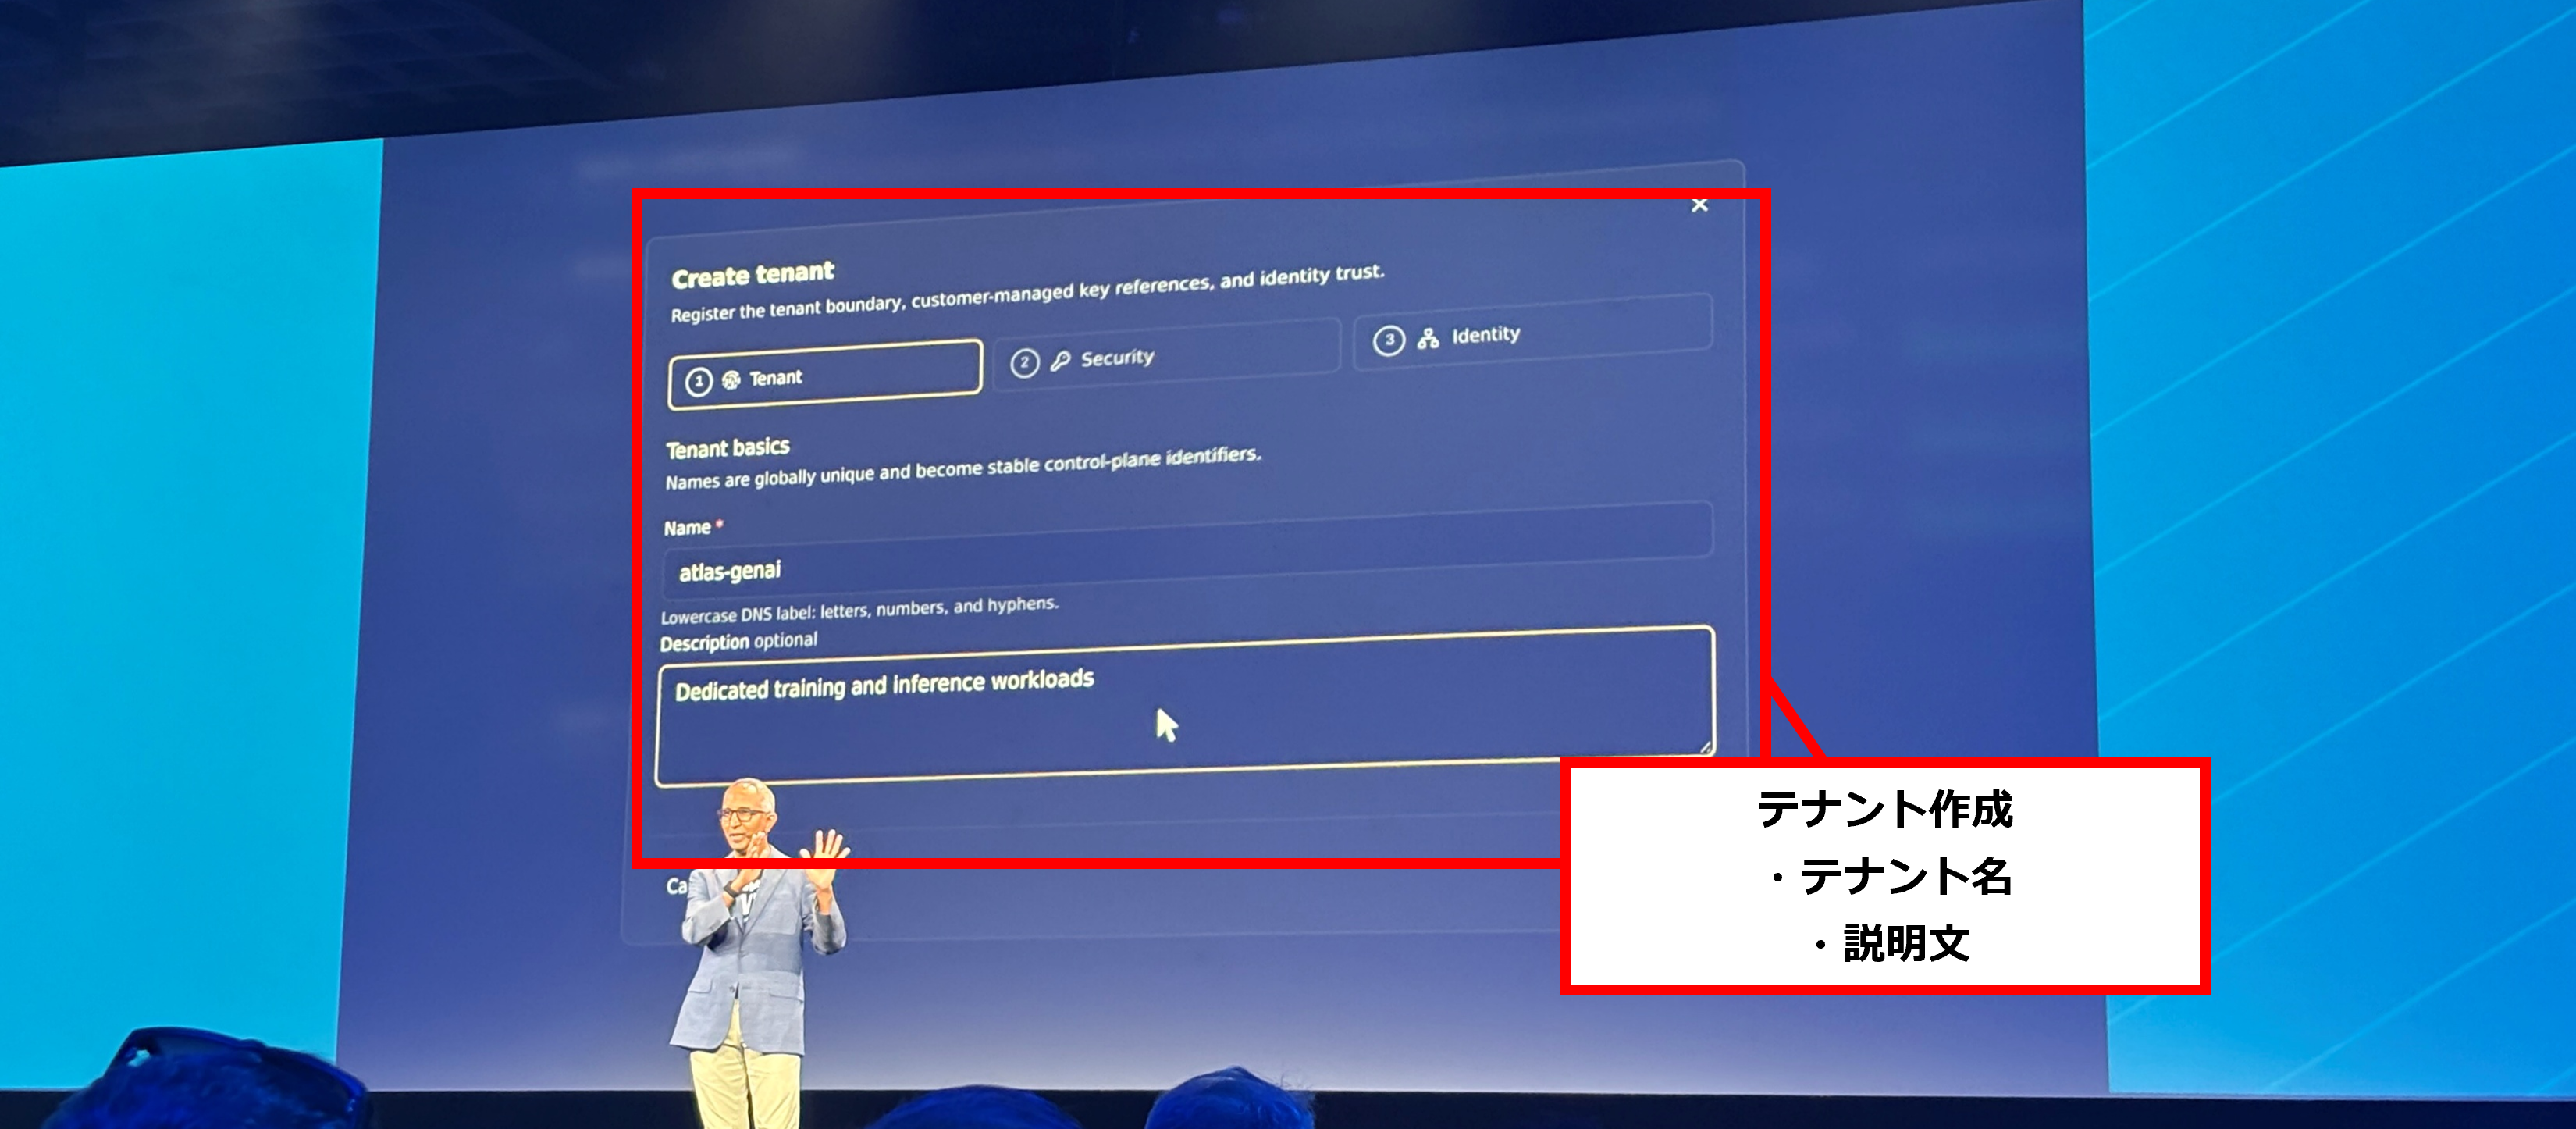
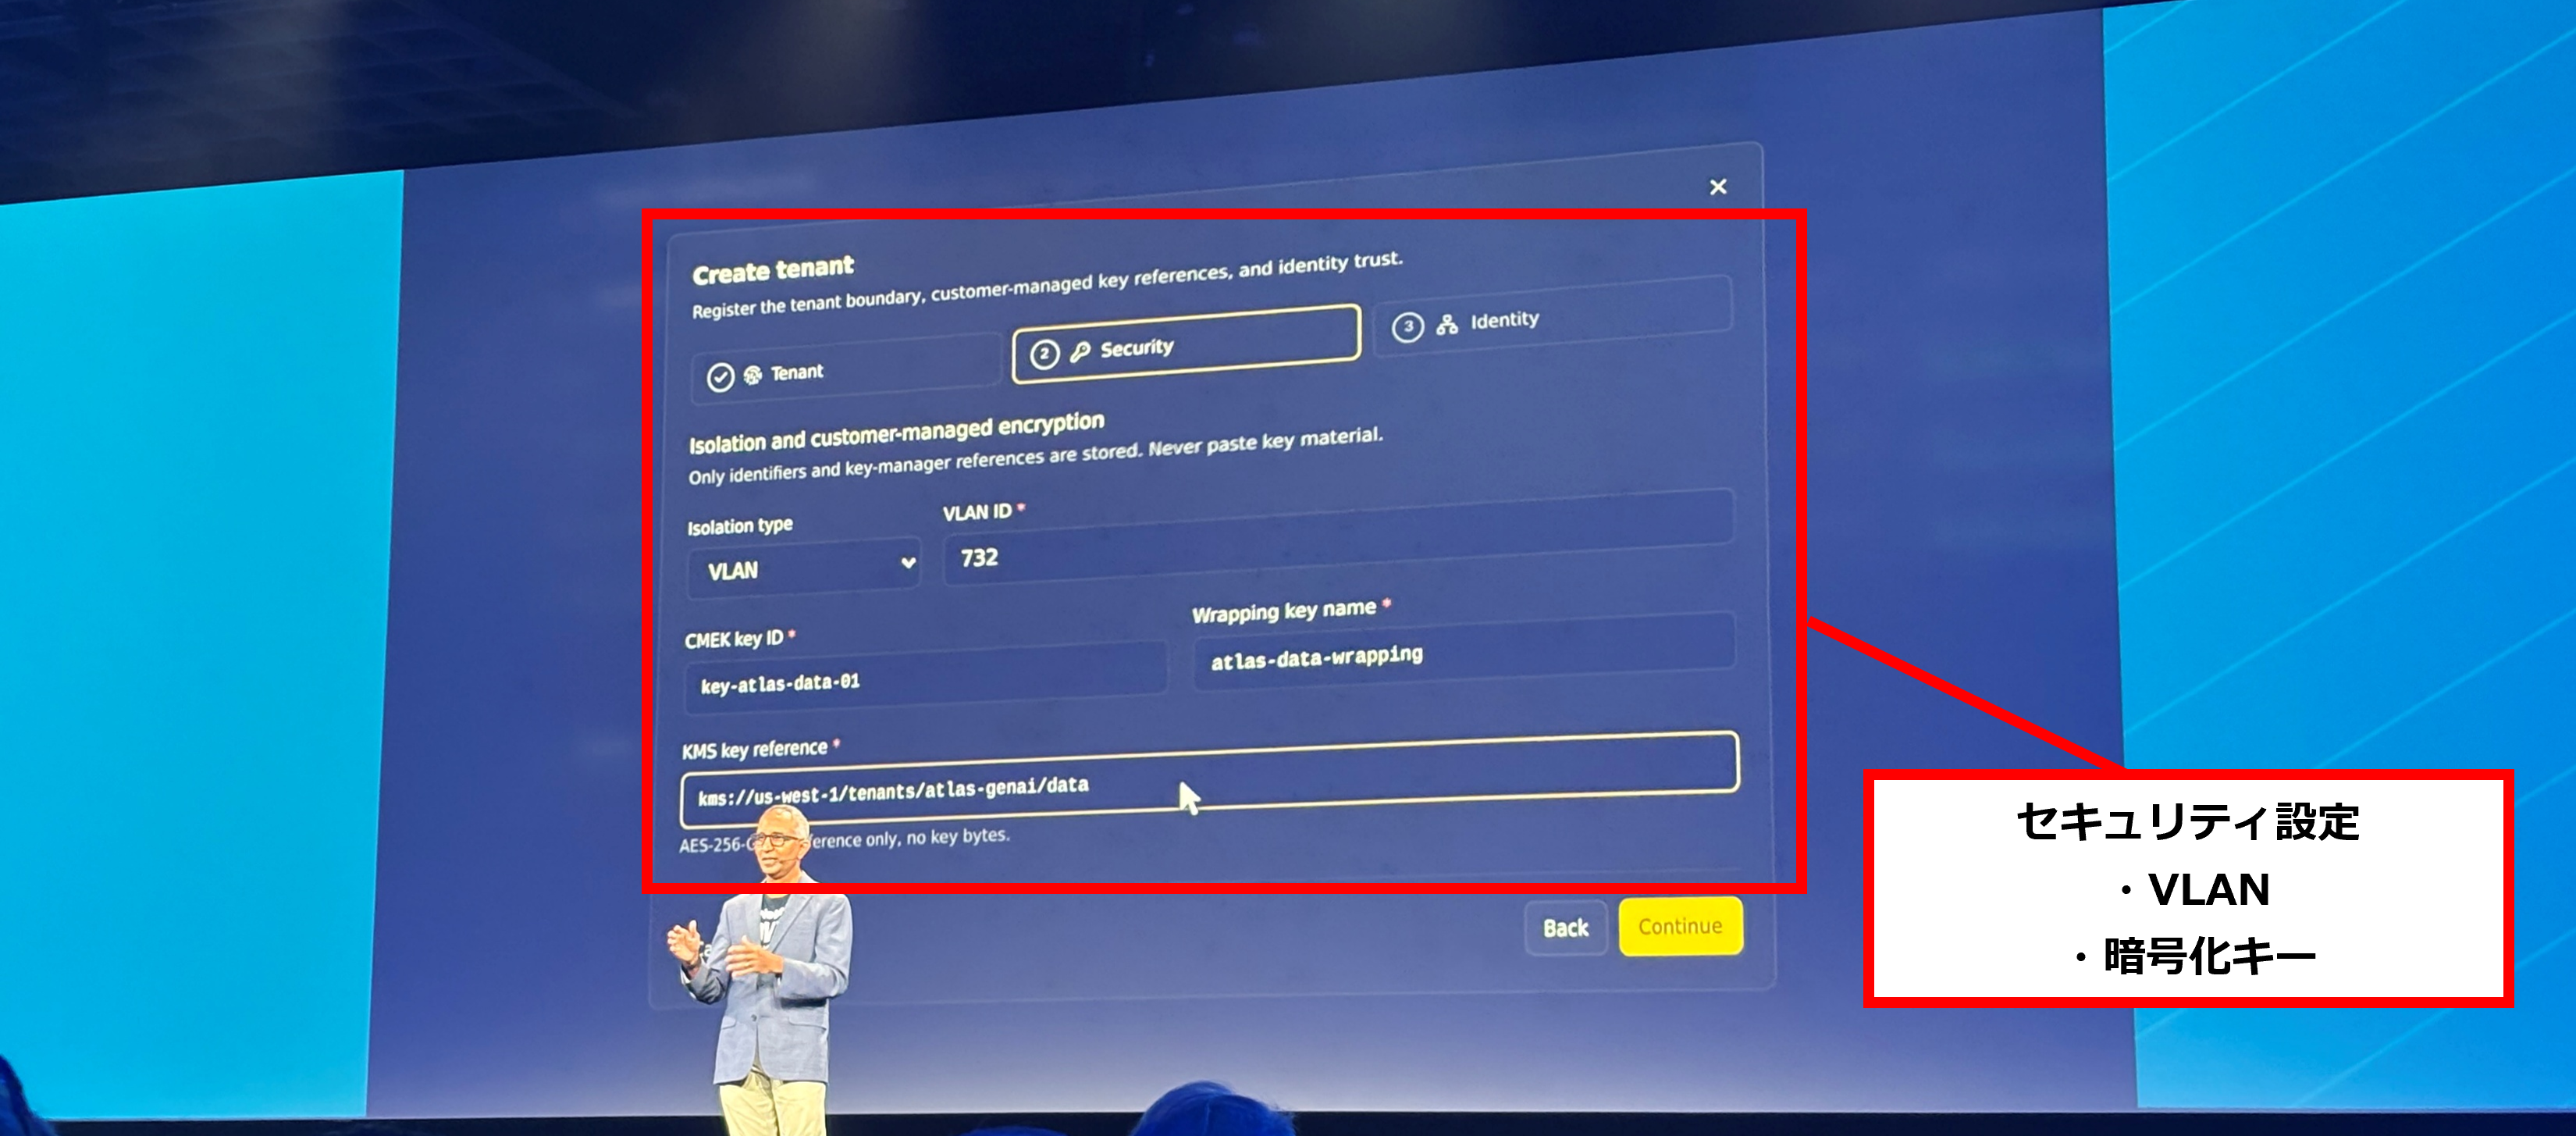
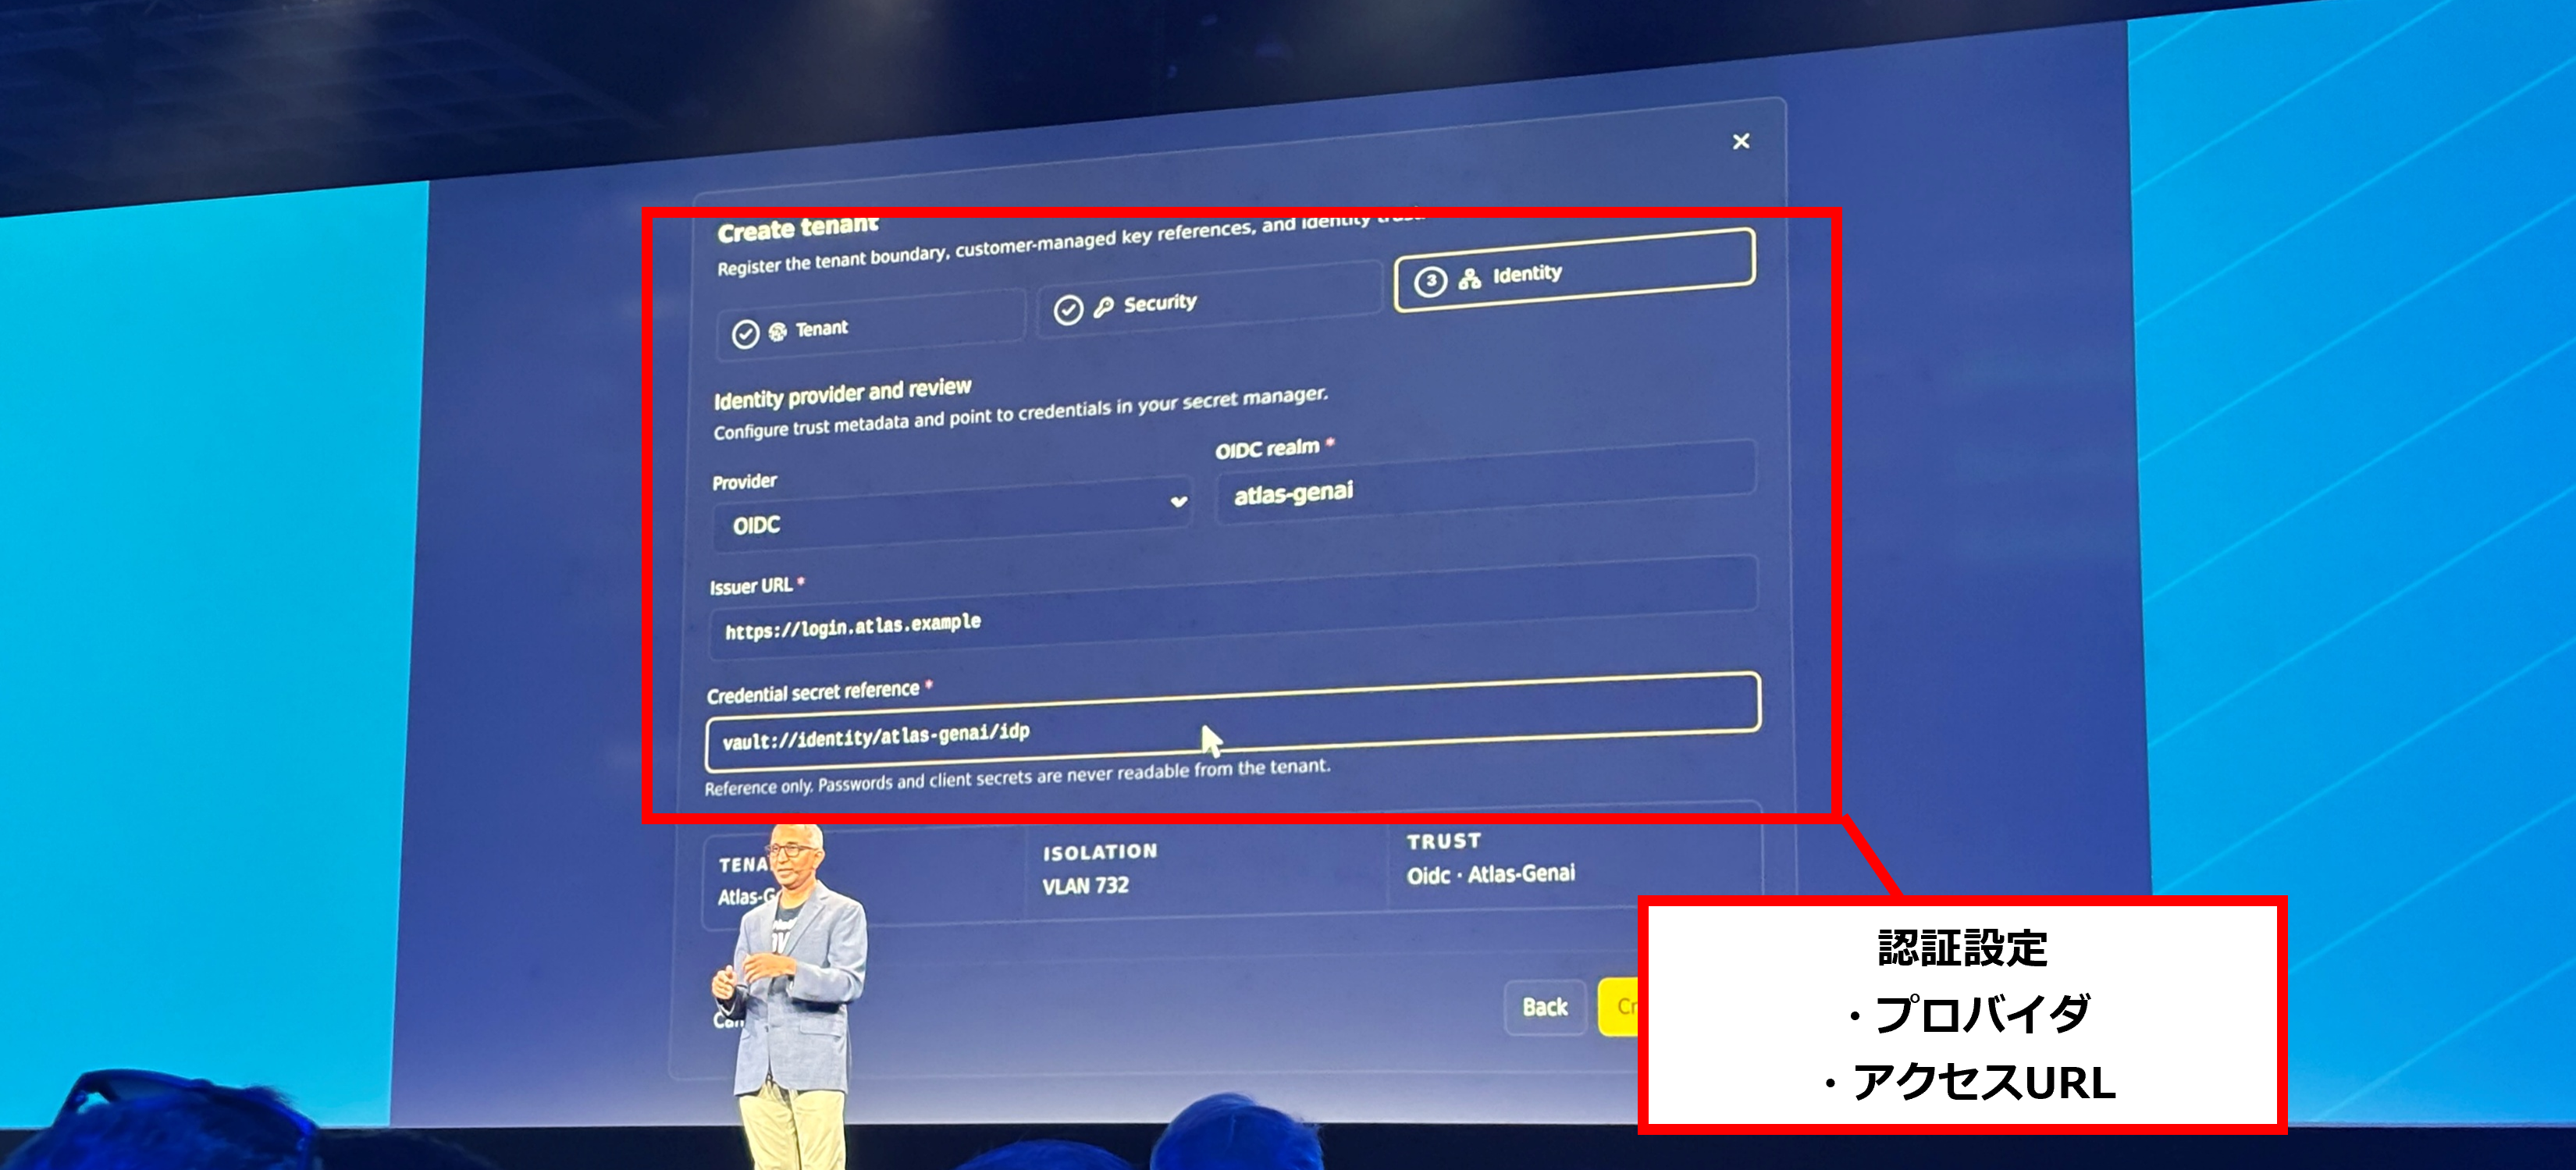
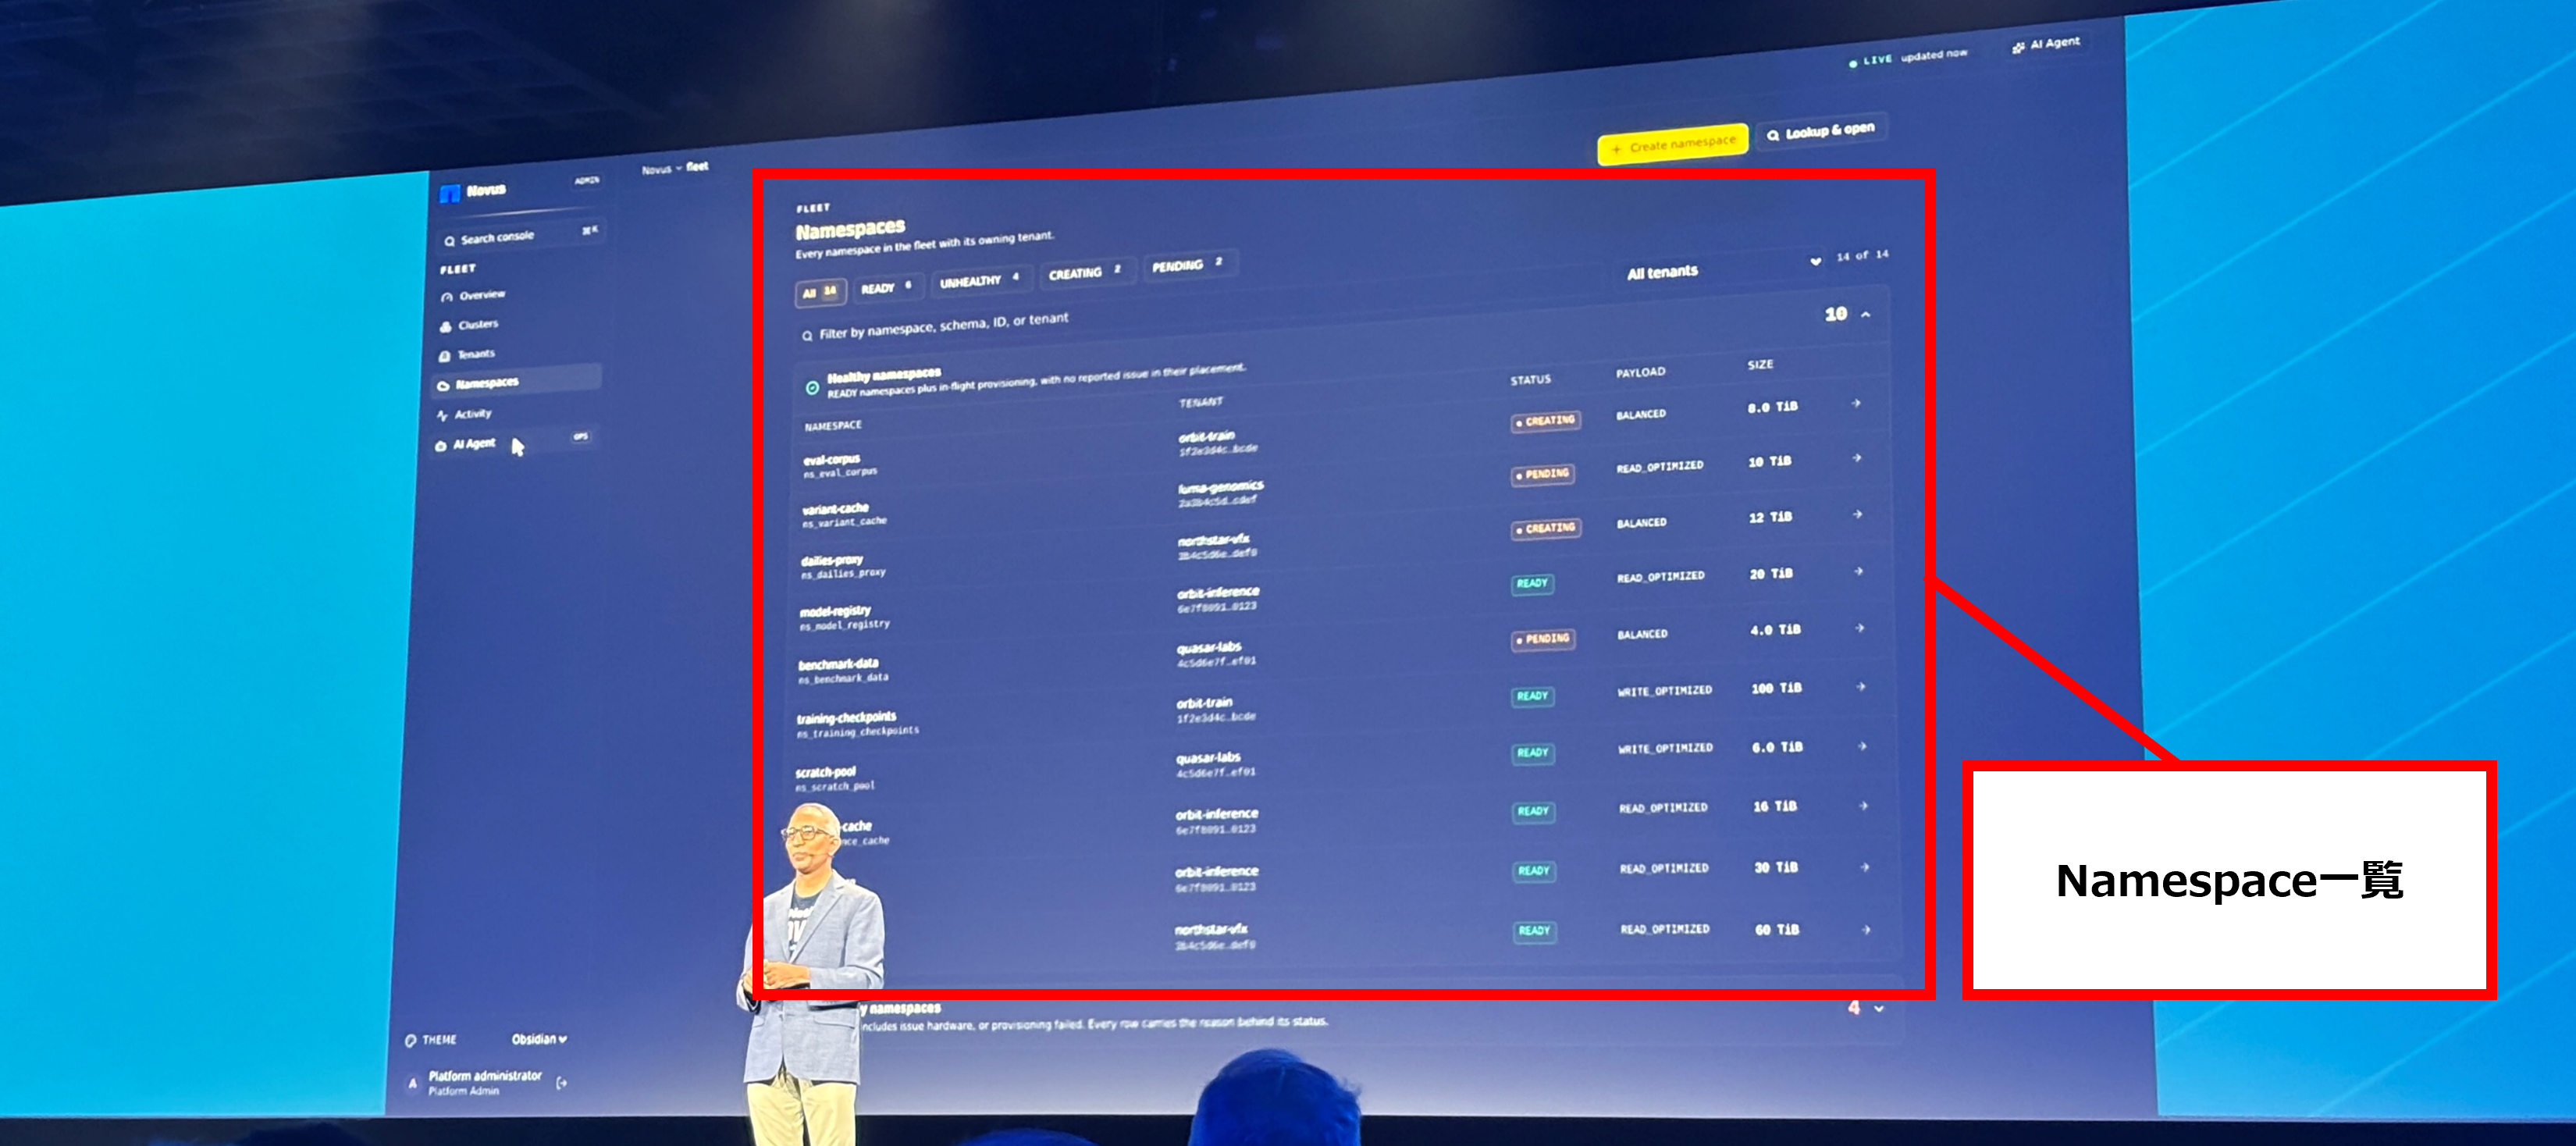
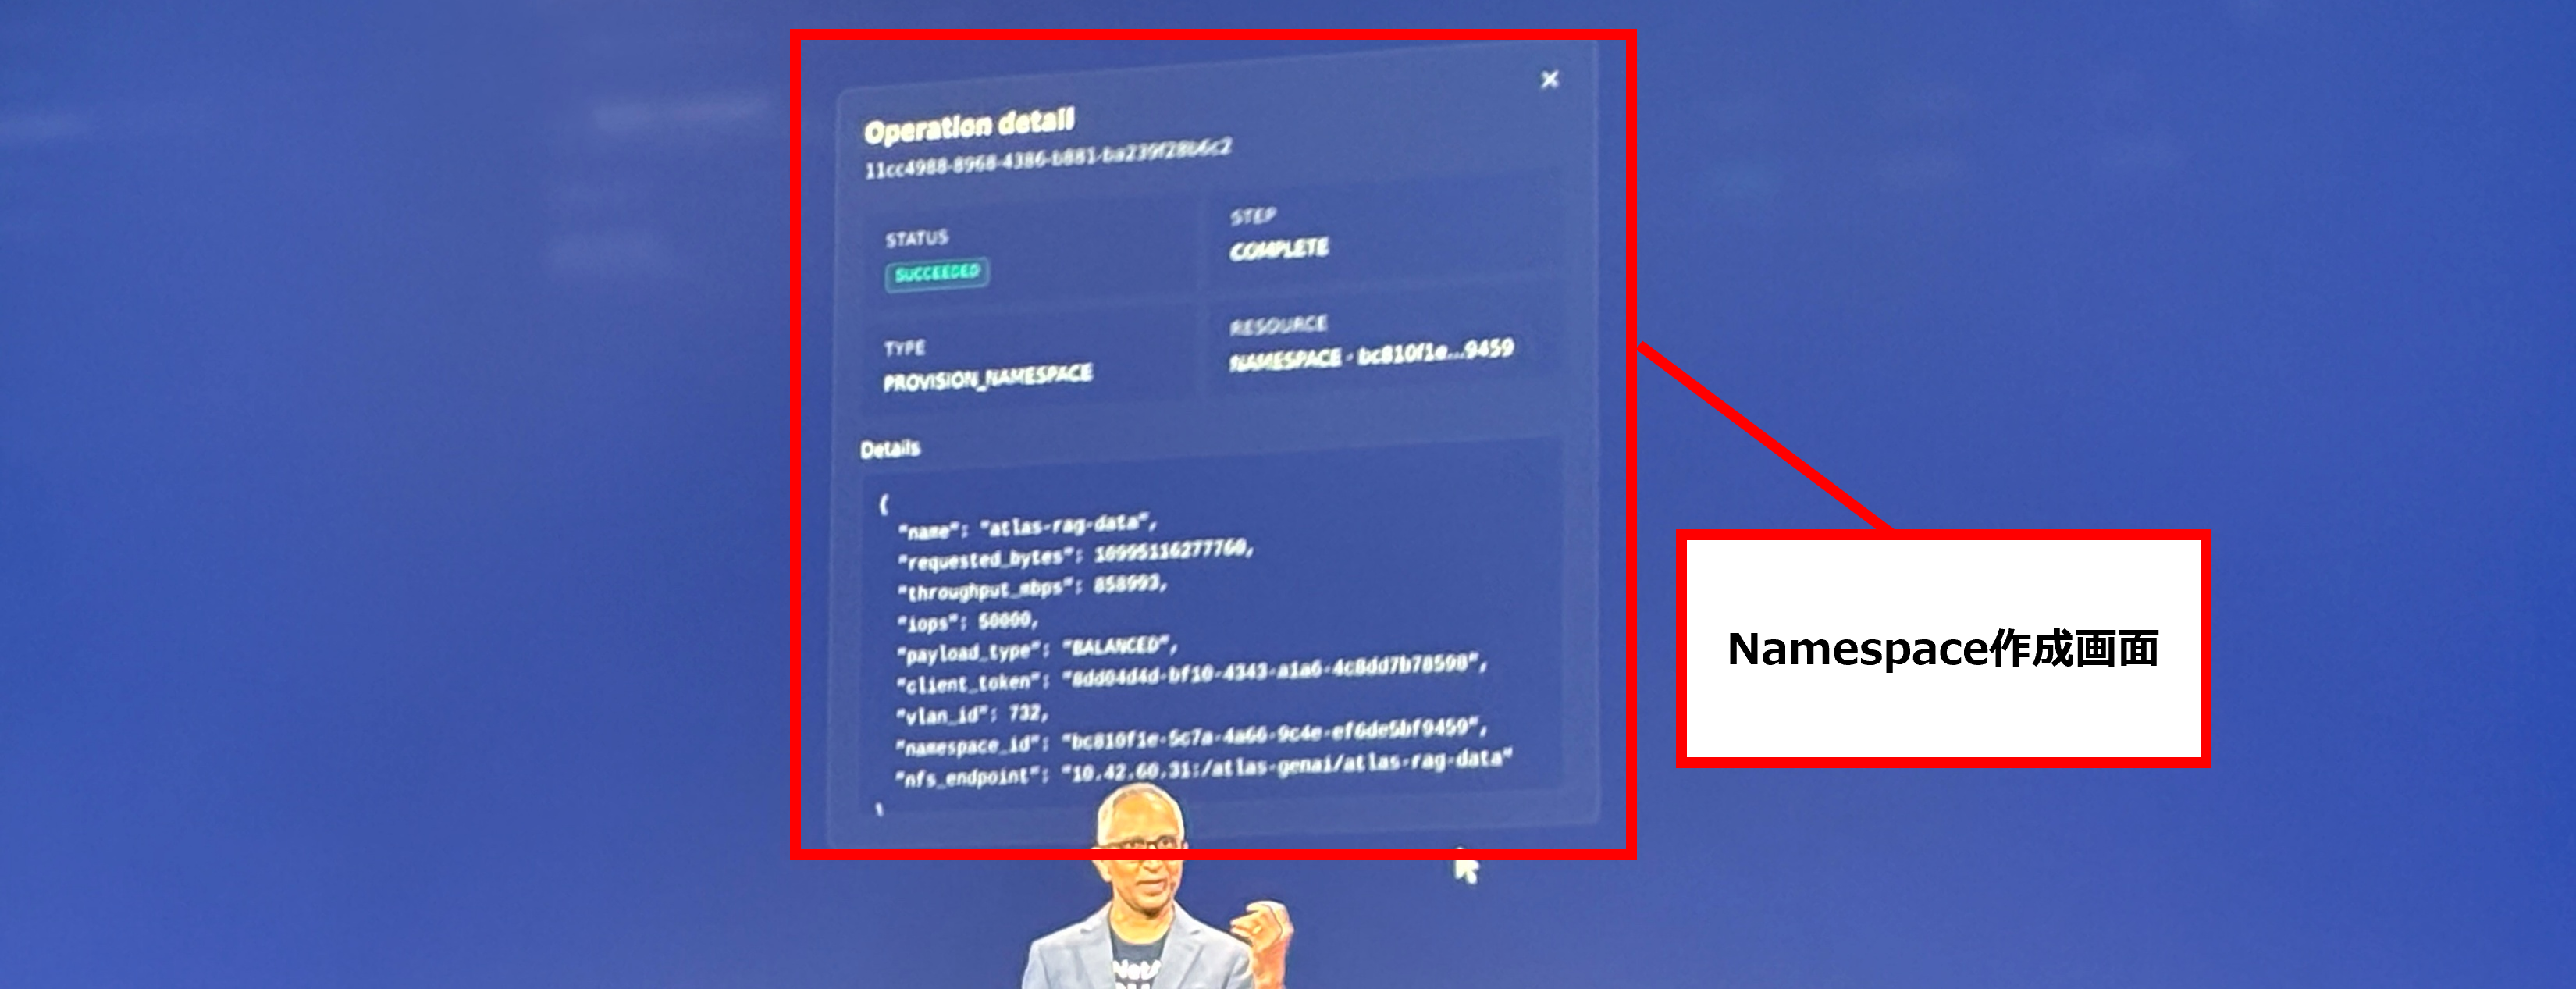
Keynoteでは、Novusの運用画面を使い、データノードの追加、テナントの作成、リソース割り当て、ヘルス監視、Namespace作成を行うデモも実施されました。
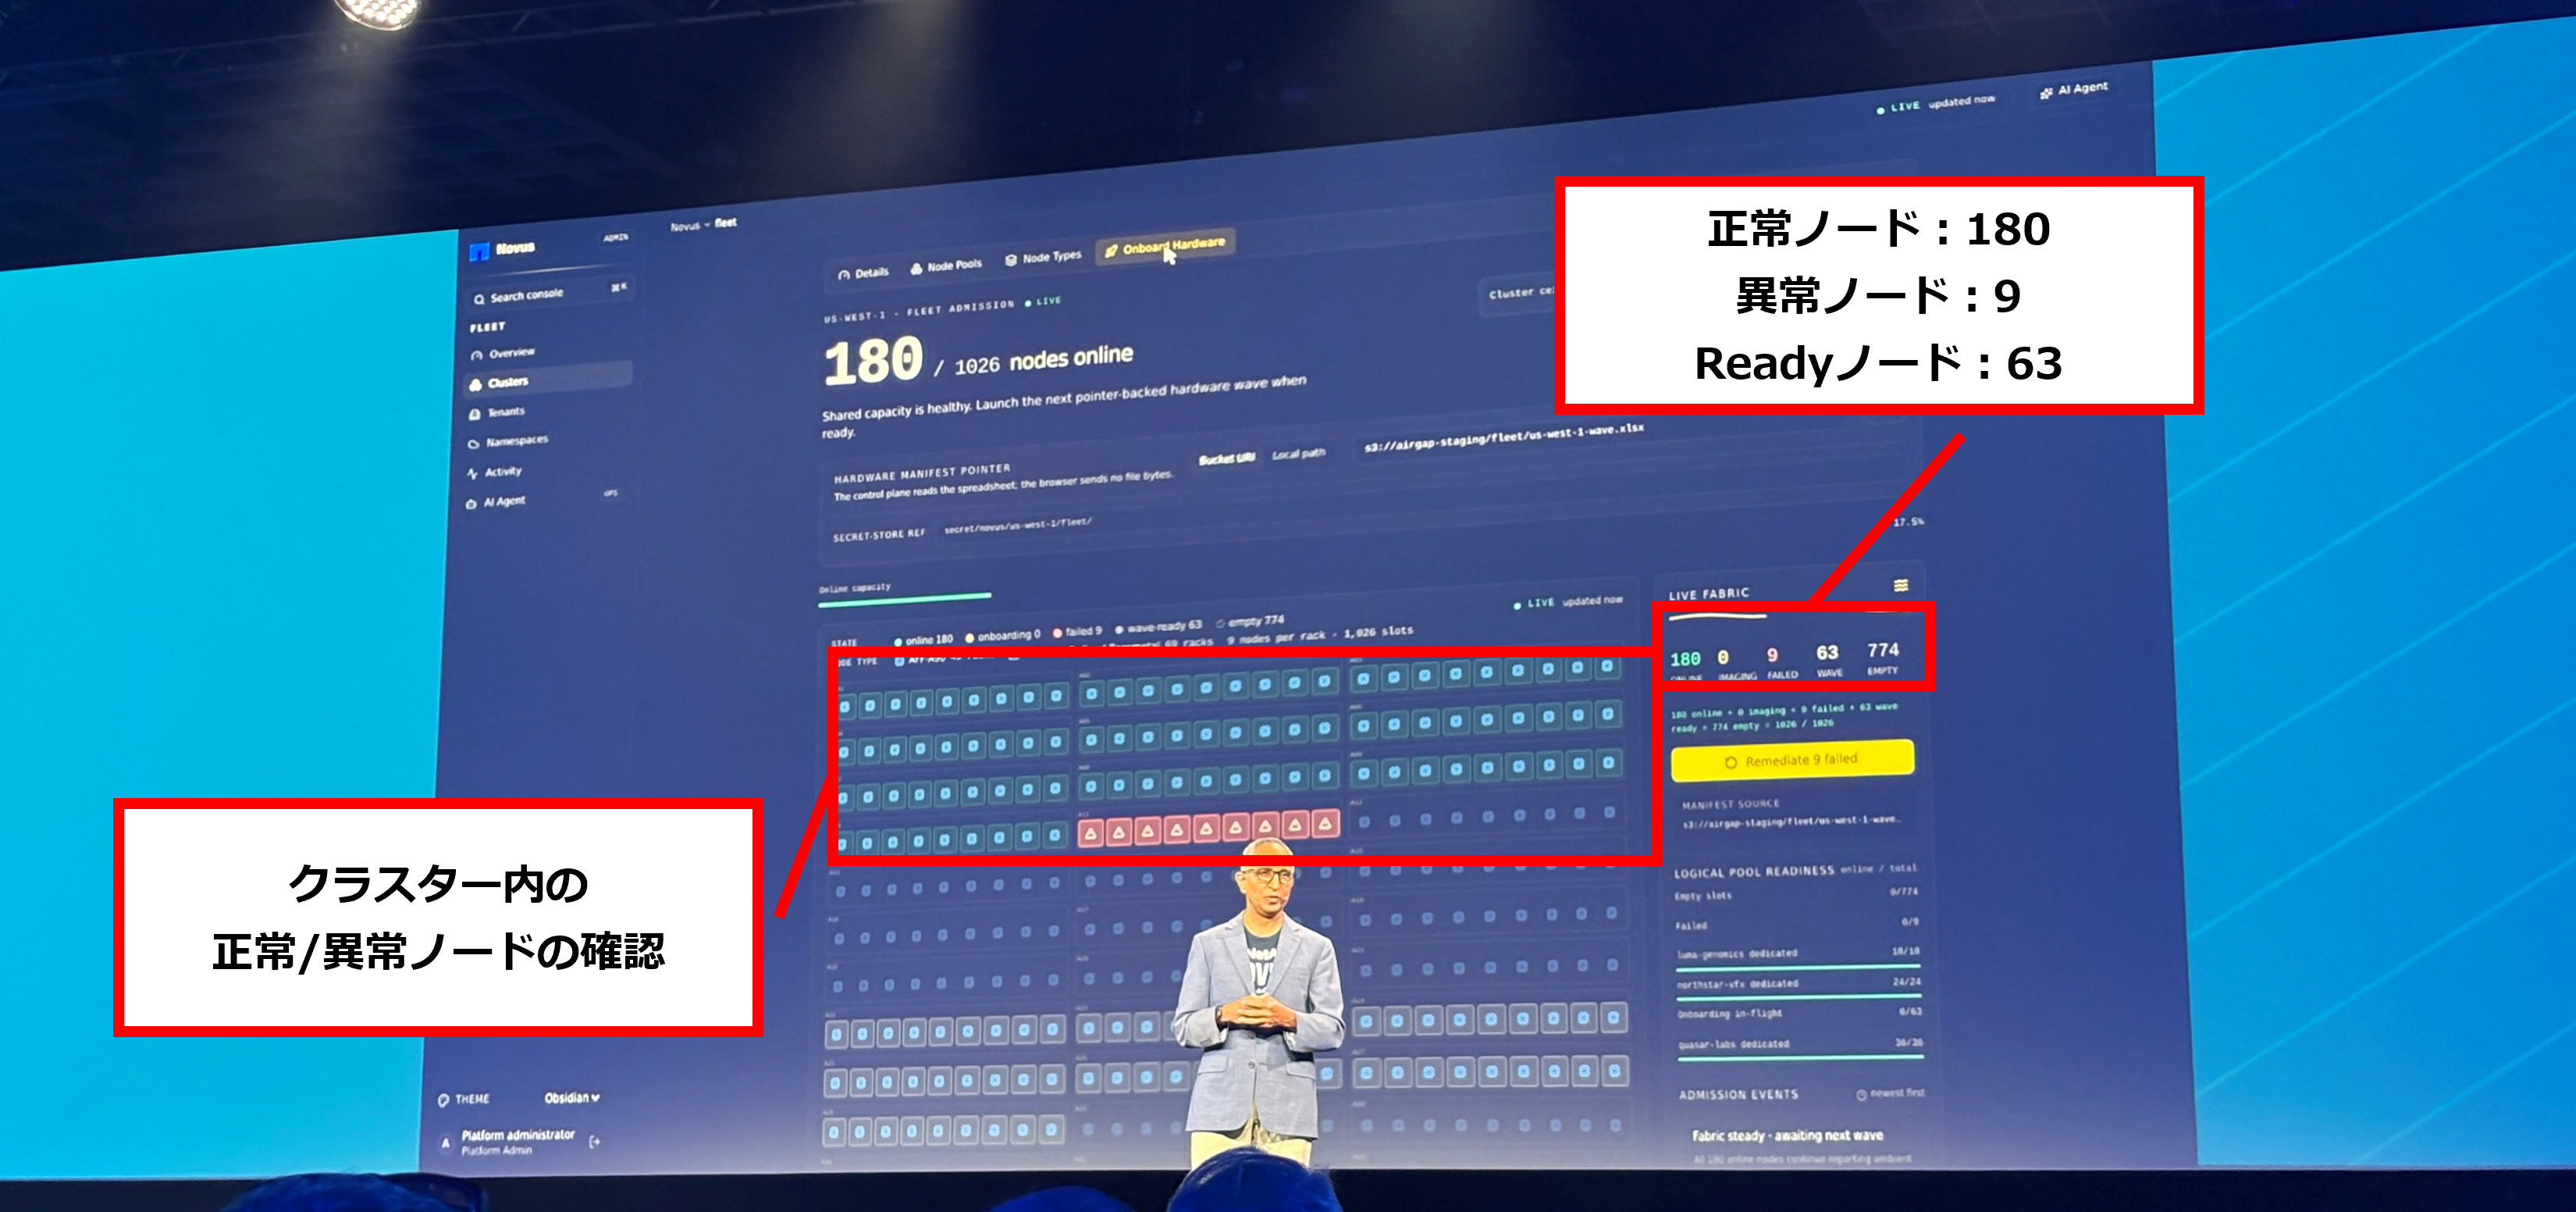
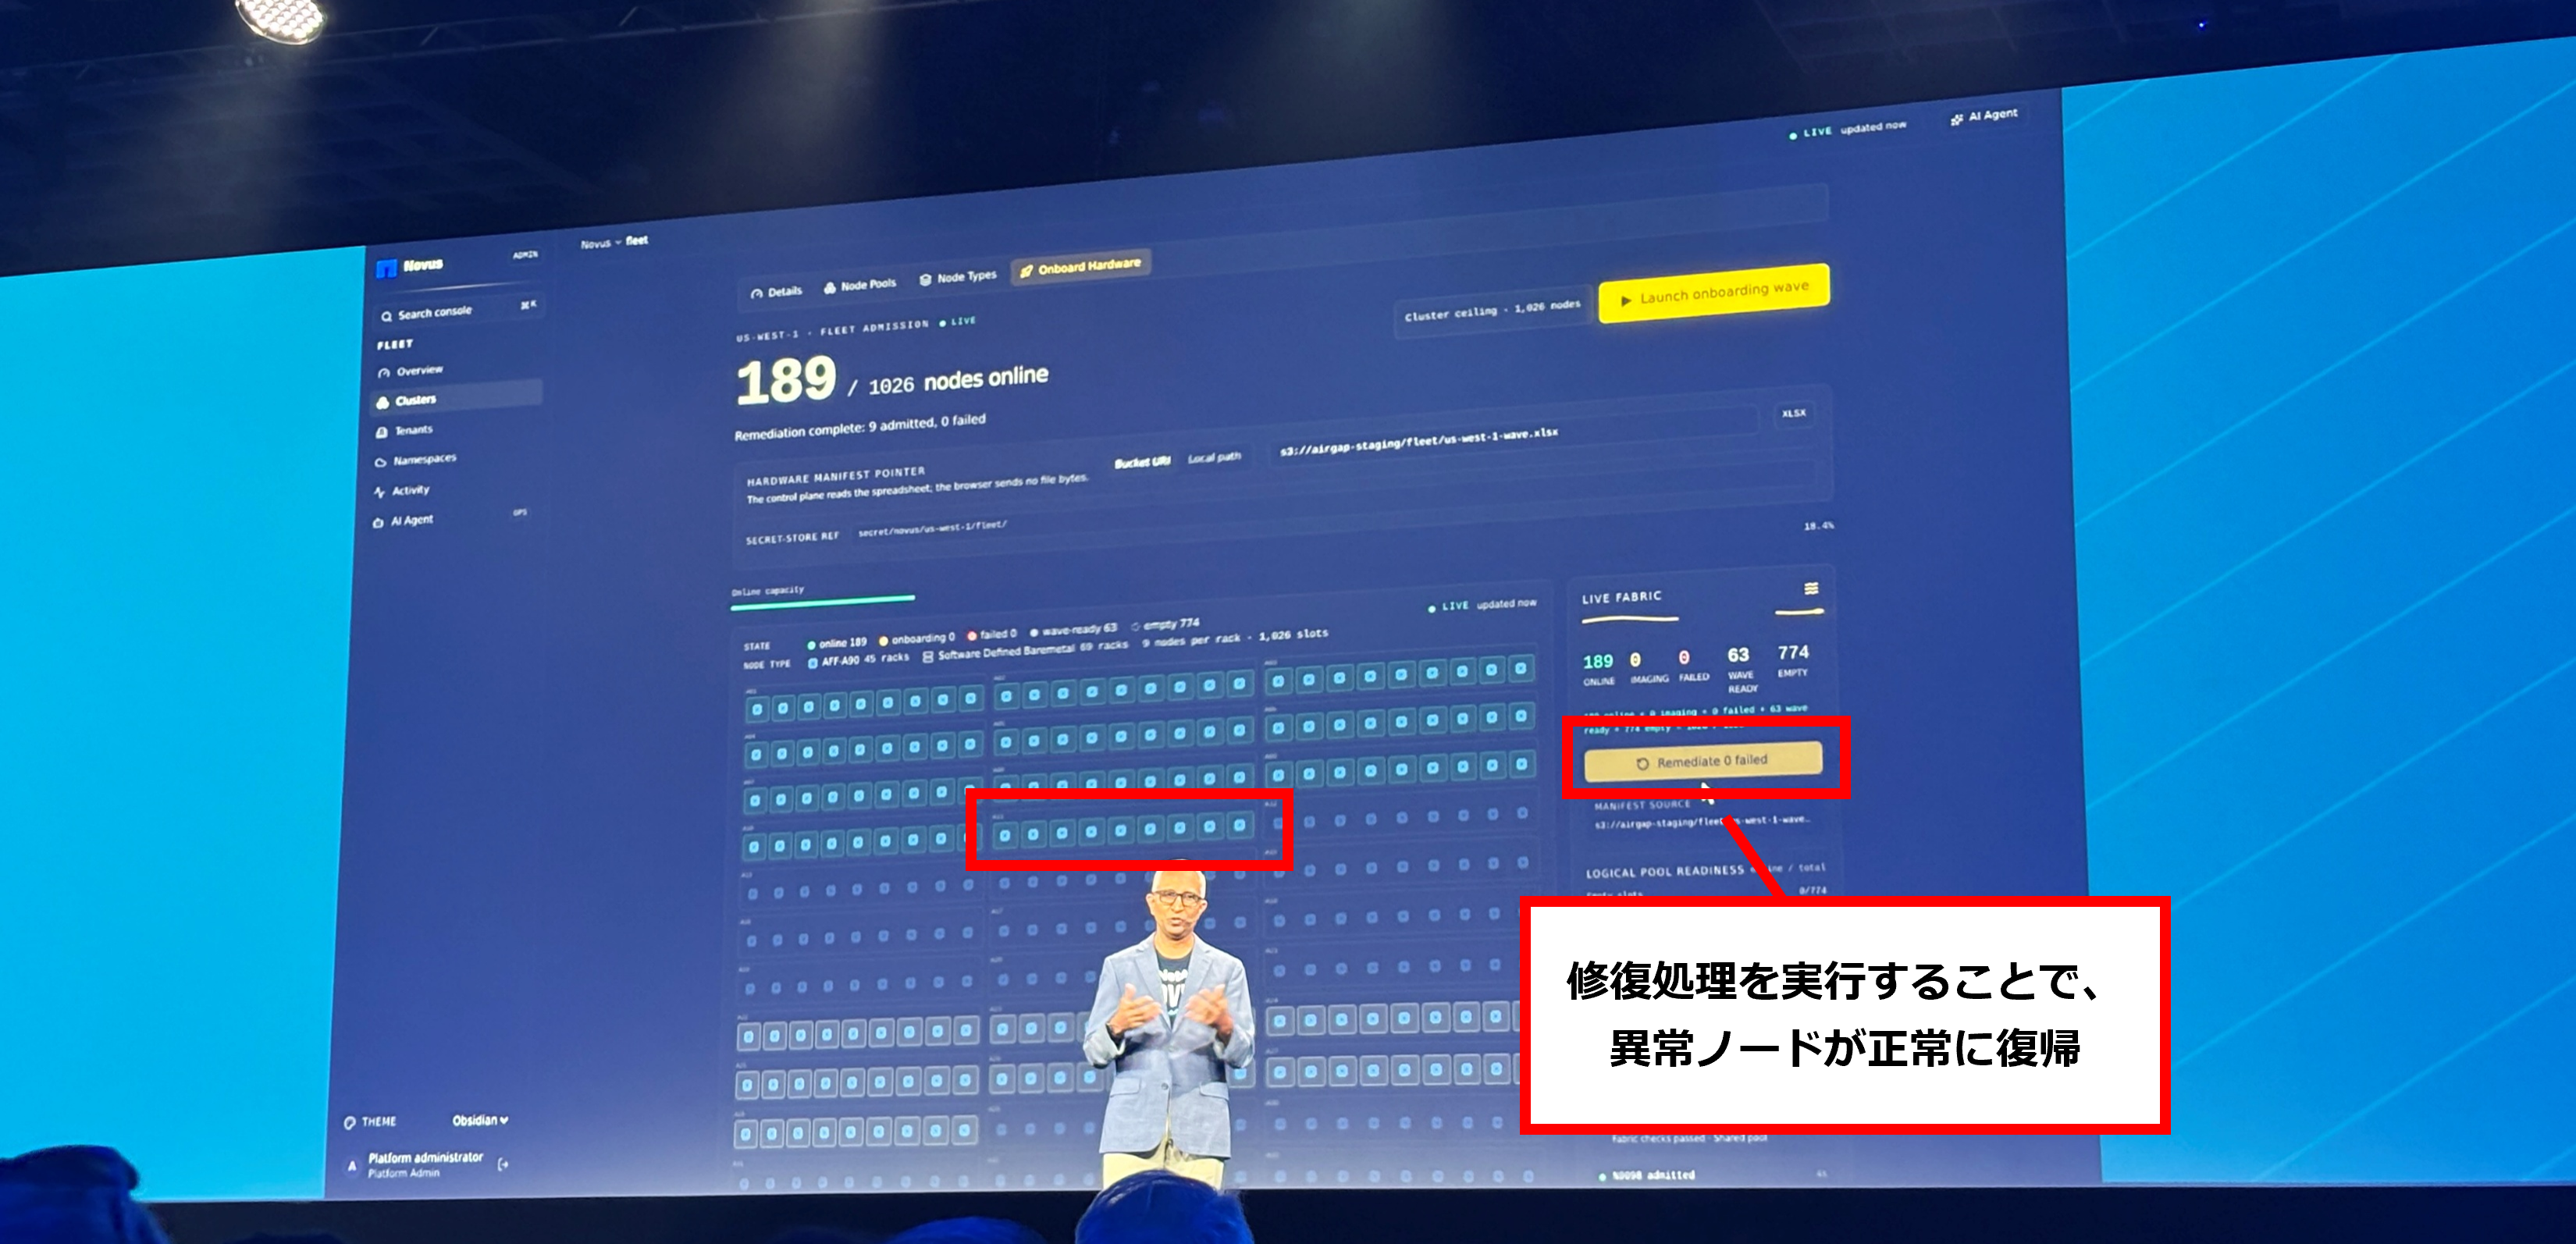
デモでは、Novus環境への登録に失敗していた9台のノードに対して修復を実行し、正常な状態へ復旧。
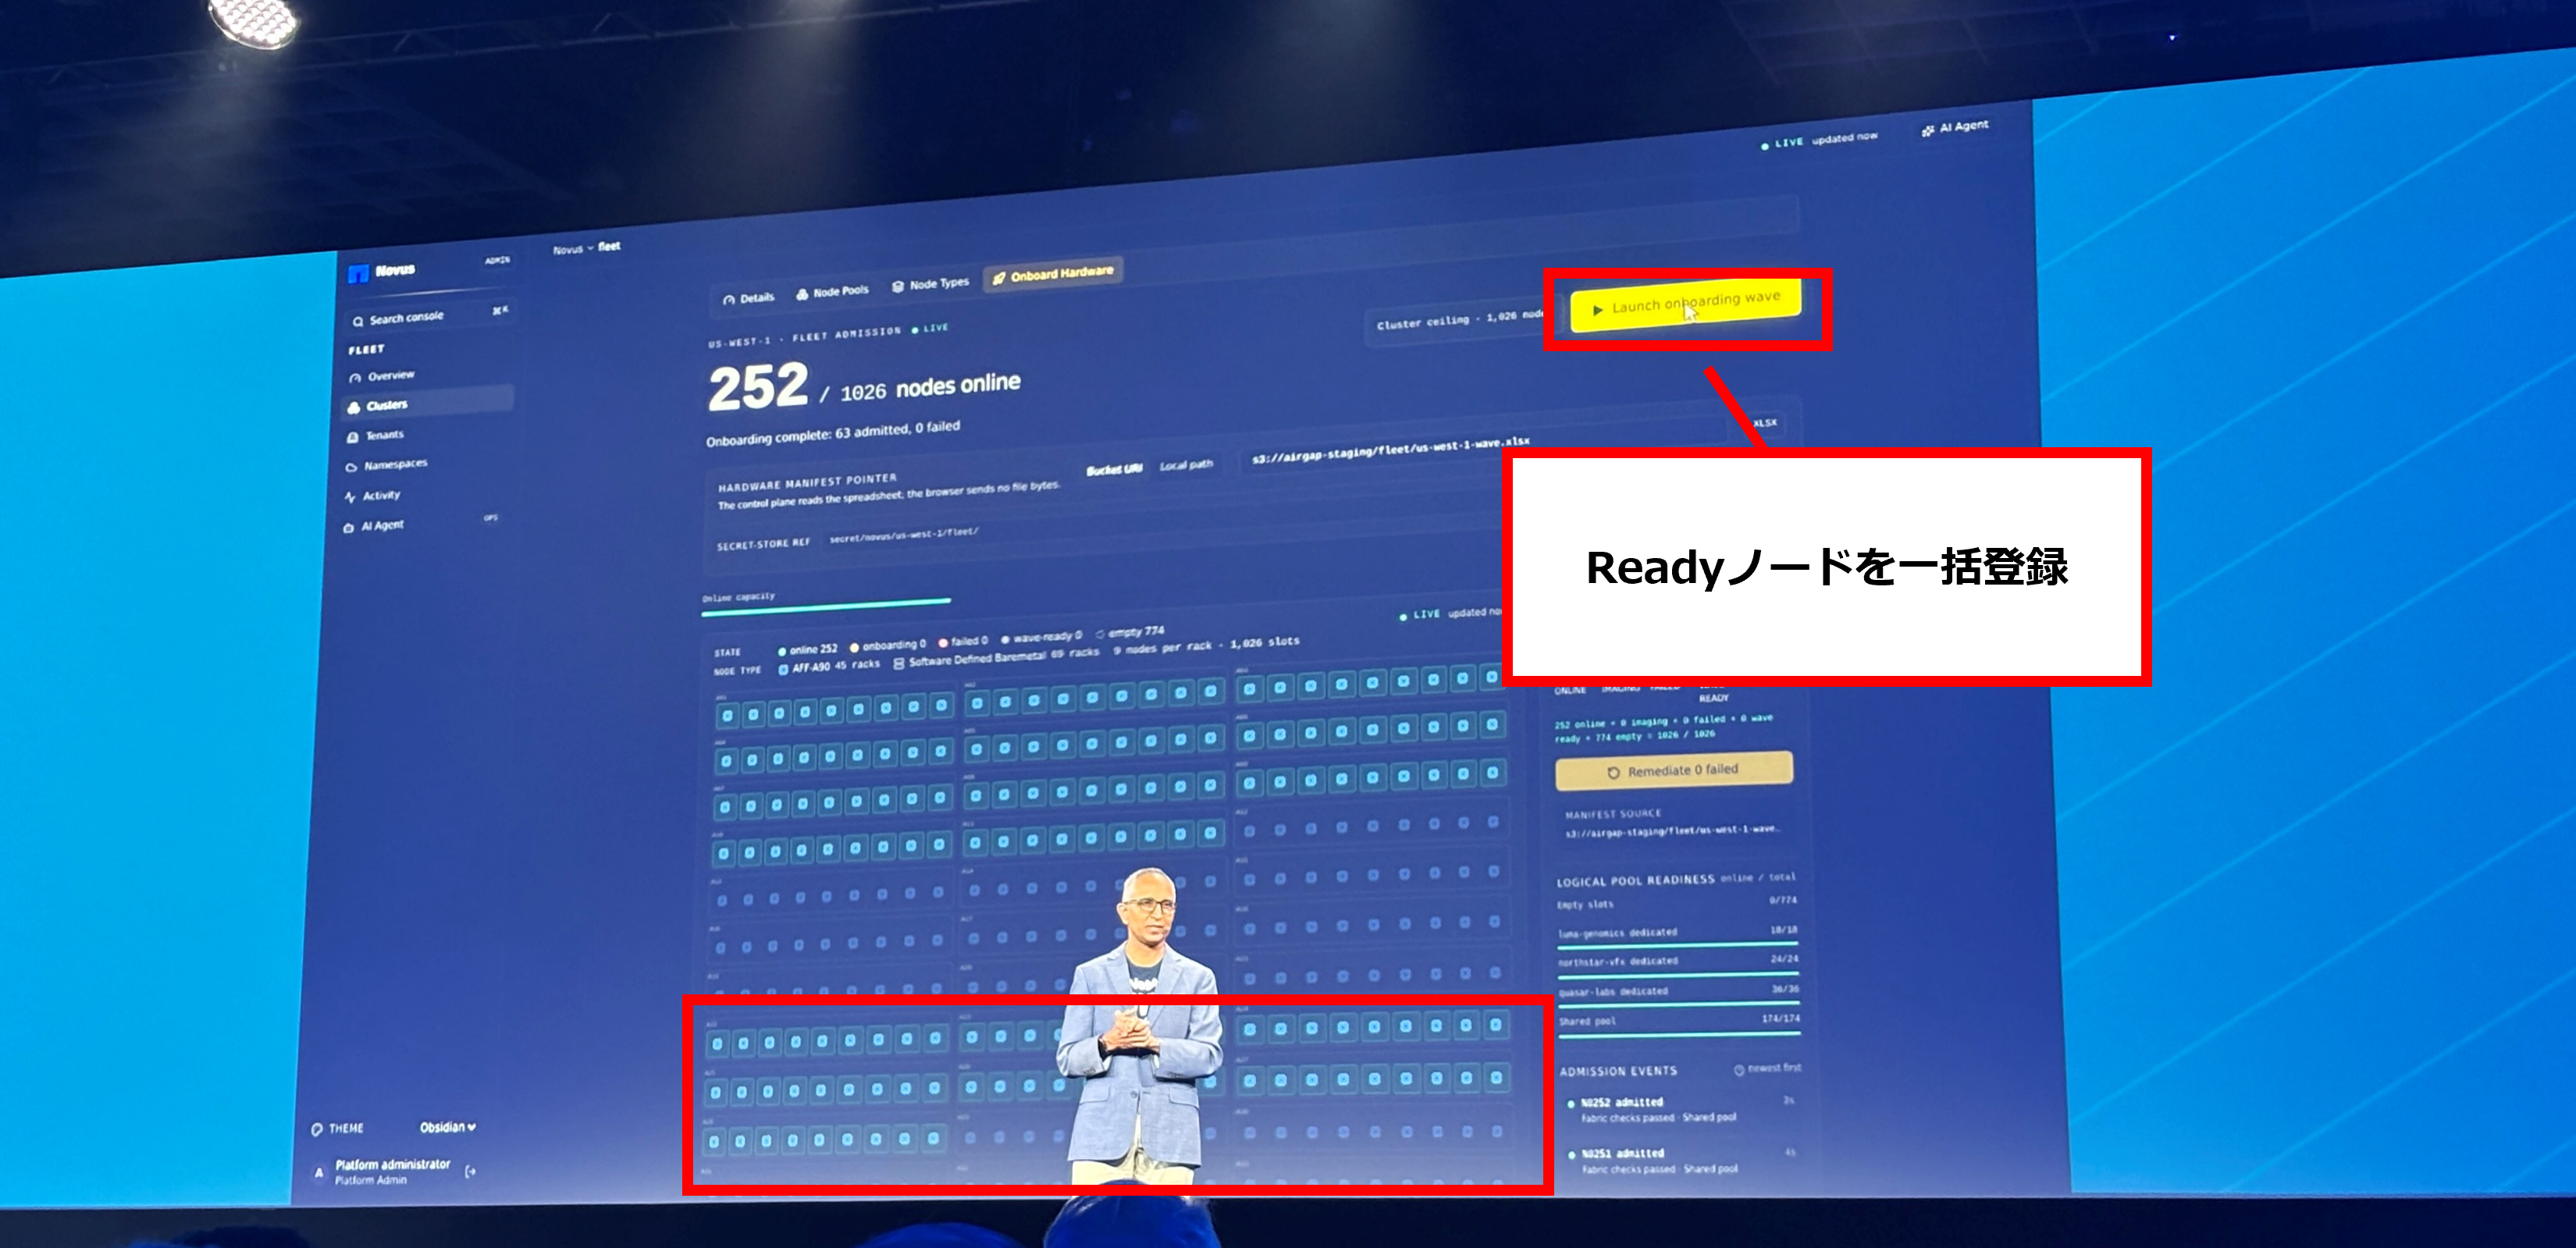
その後、事前に用意したHardware Manifestを読み込み、新たに63台のデータストレージノードを一括で追加していました。
さらにNovusの管理画面から新規ノードの検証と展開、Fleetへの参加処理が自動的に進められ、正常ノード数は189台から252台へ増加しました。
AI Factoryのような大規模環境を想定し、数十台のストレージノードをクラウド基盤のように一括展開・管理できる点が印象的でした。
【Novusでストレージノードを追加するデモ】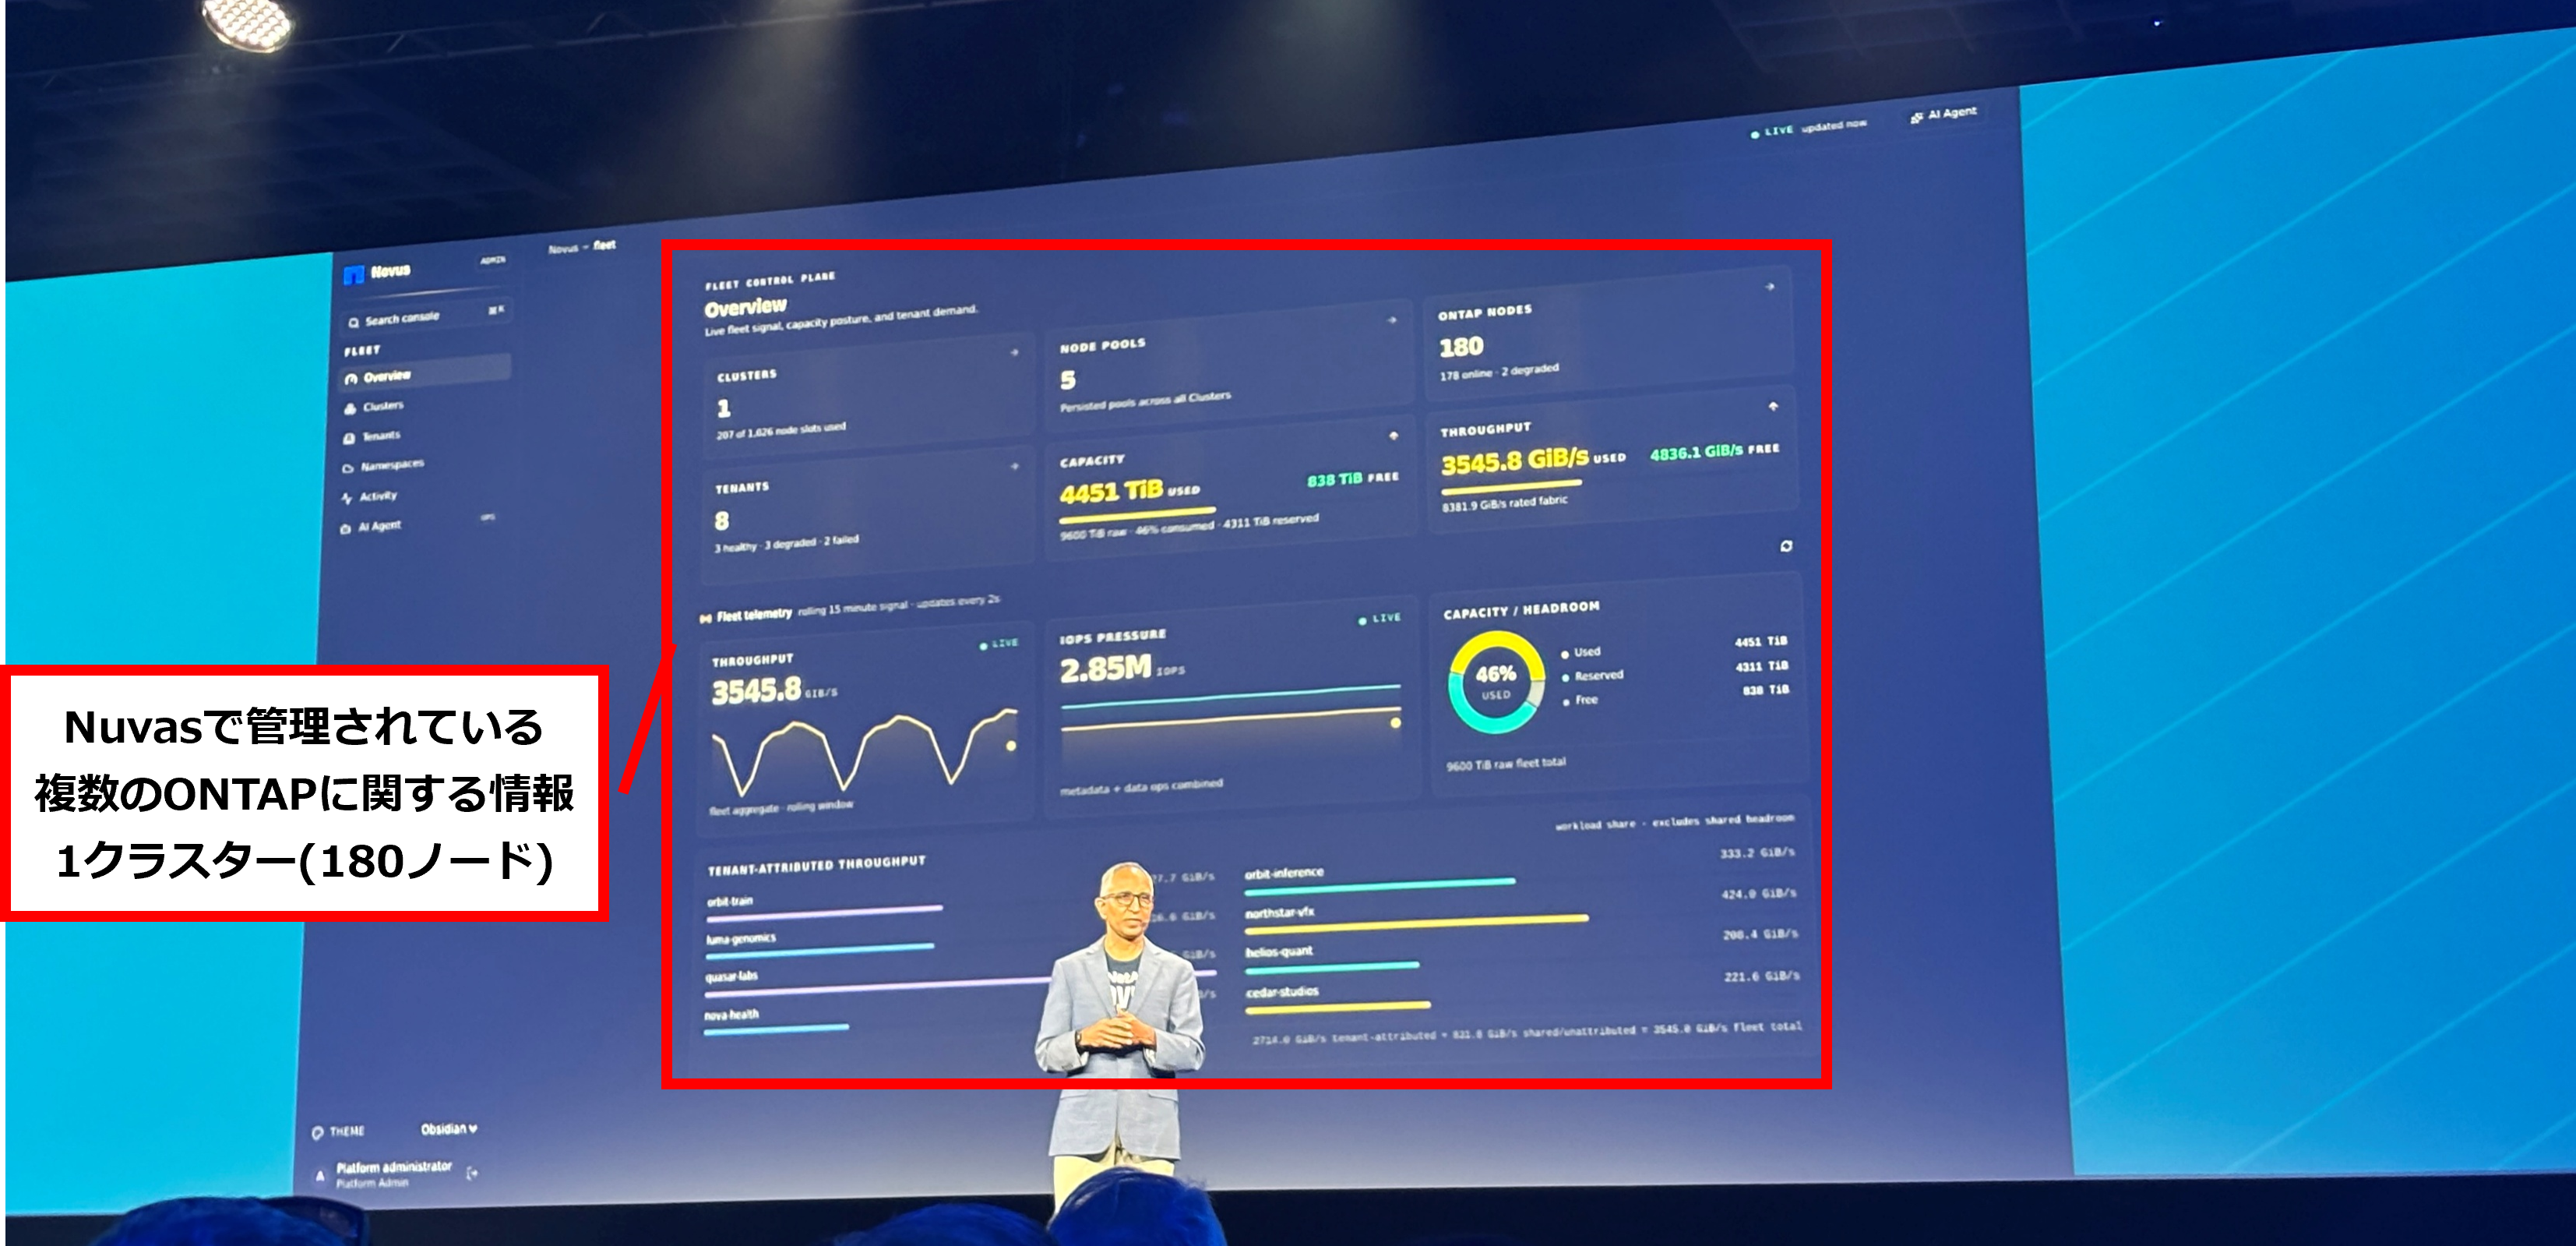
また、追加したストレージをクライアントへ割り当てるためのテナントとNamespaceの作成の流れもデモで公開していました。
【NovusでテナントとNamespaceを作成するデモ】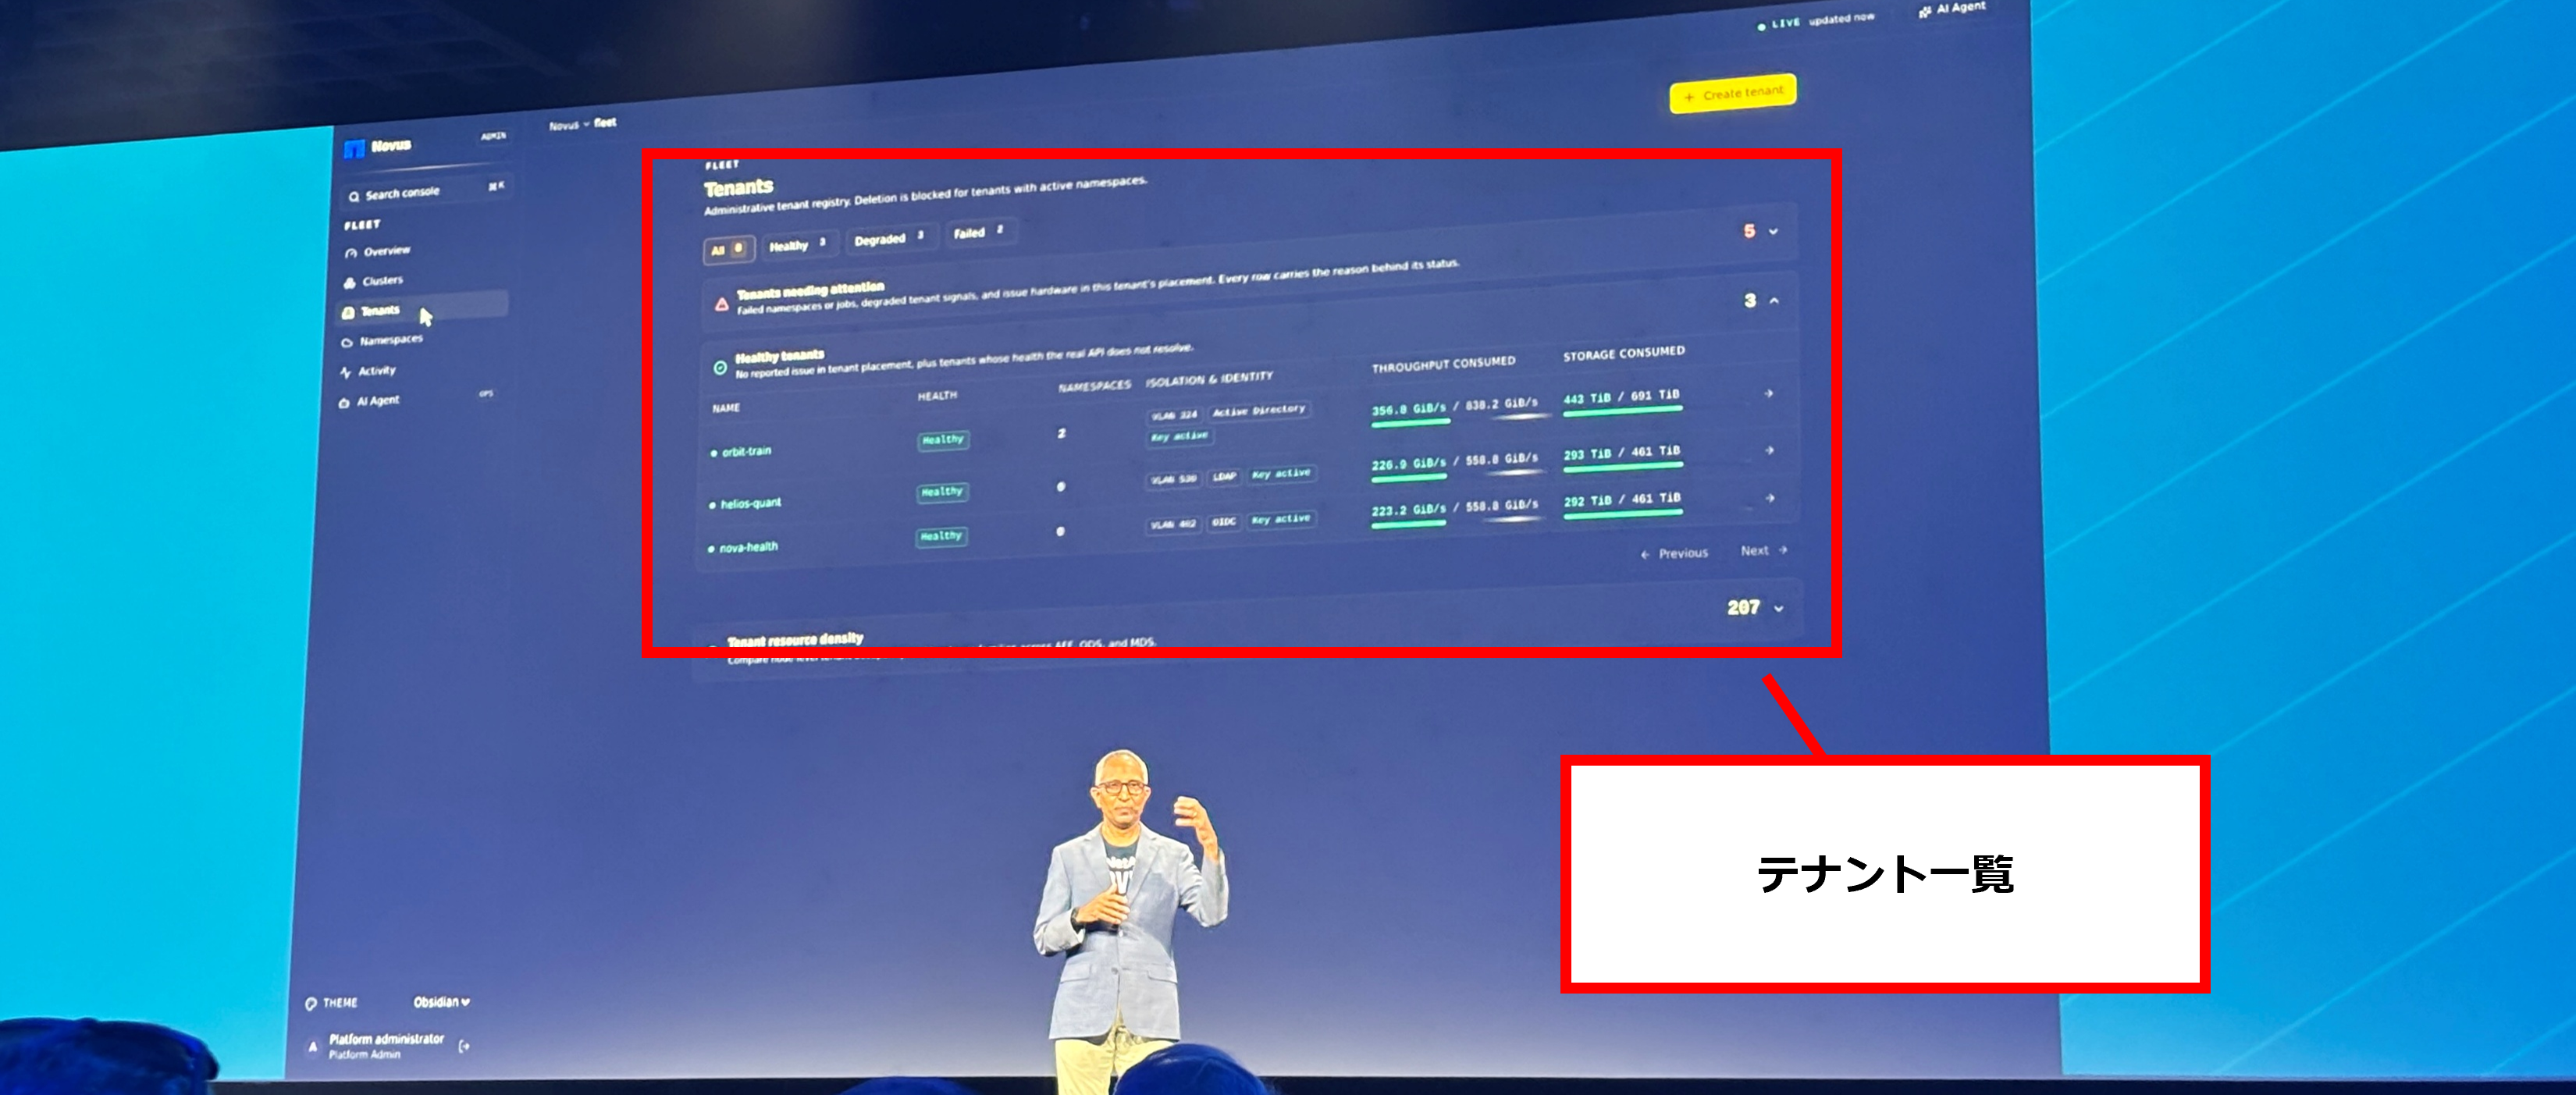
肝心のNovusの提供開始時期については、Keynoteにて2026年10月からDeployment開始可能という案内があり、NetAppのプレスリリースでもNovus Data Directorを認定済みSupermicroサーバーで動作させ、データ層にAFF A90を利用する初期構成について、現時点で注文可能な旨が発表されています。
詳細が気になる方は、弊社またはNetApp様までお問い合わせください。
以下、Novus関連の公式情報ソース
- NetApp Novus公式ページ
- NetApp公式ブログ:A New Data Architecture for AI Factories at Scale
- NetApp Novus発表プレスリリース
- NetAppとSupermicroの共同発表
- NetApp Novus Solution Brief
| NetApp × Nutanix 3Tier連携 |
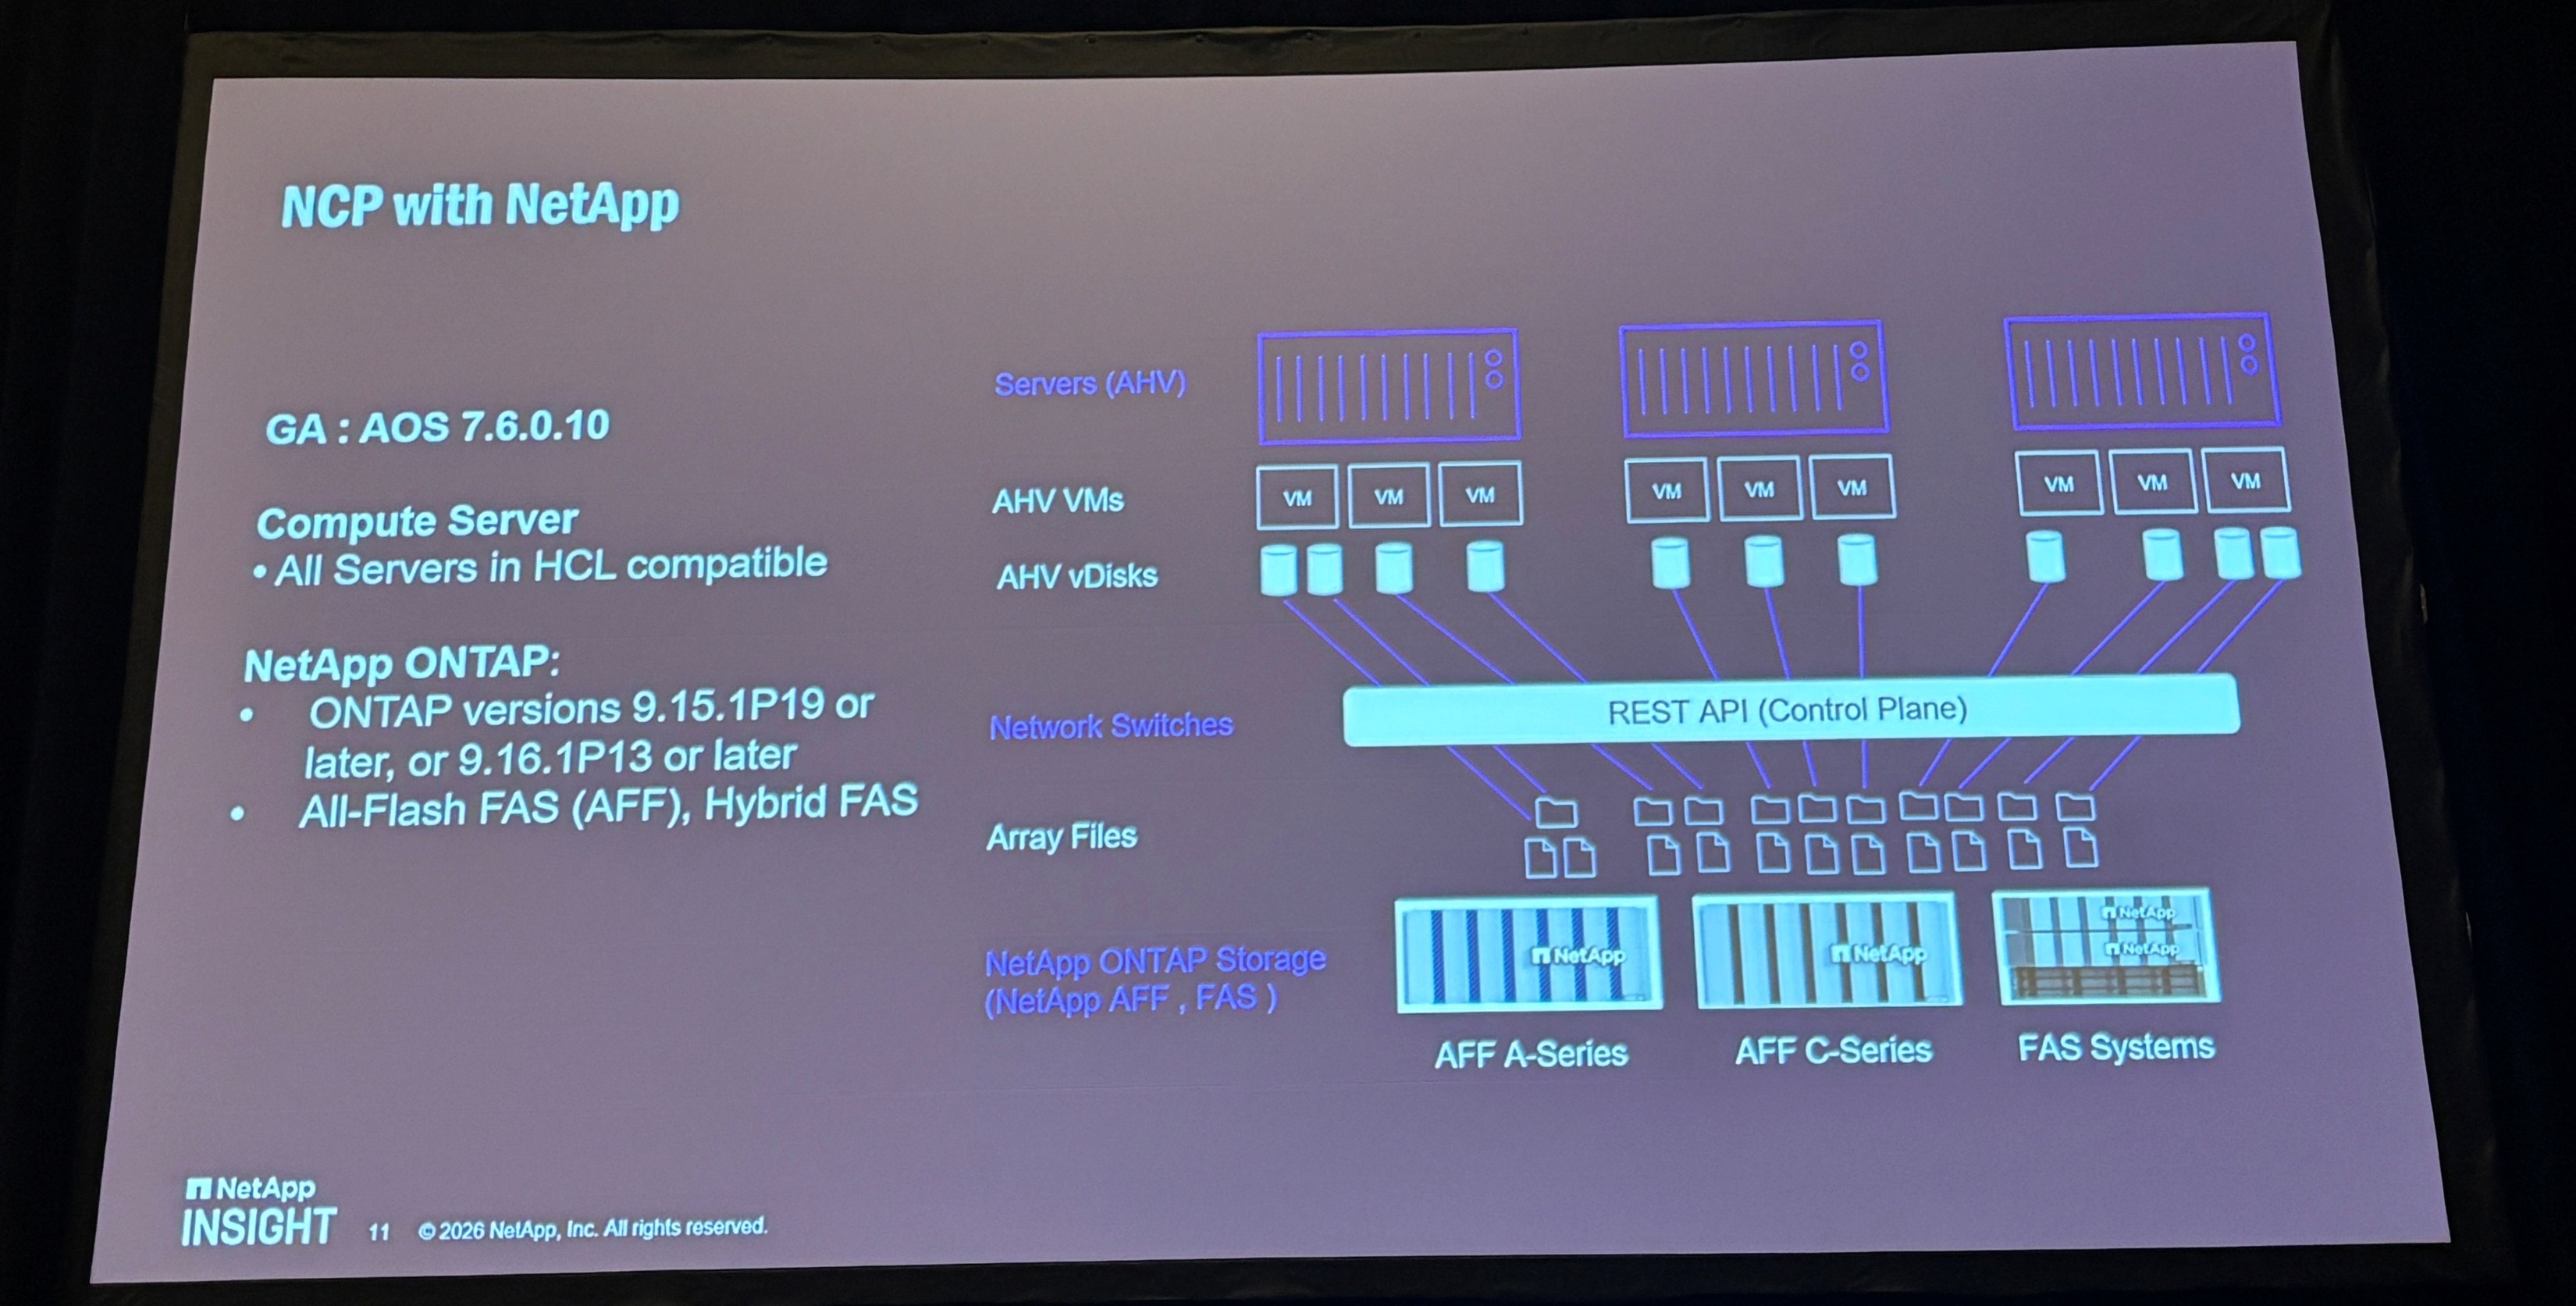
従来のNutanixは、コンピュートとストレージを同一ノードに搭載するHCI構成が基本でしたが、今回発表された構成では、Nutanix AHVを実行するコンピュートサーバーと、NetAppのAFF/FASストレージを分離し、それぞれを独立して拡張できるようになっています。
対応するNetAppストレージとして、以下の製品が示されました。
- AFF Aシリーズ
- AFF Cシリーズ
- FASシリーズ
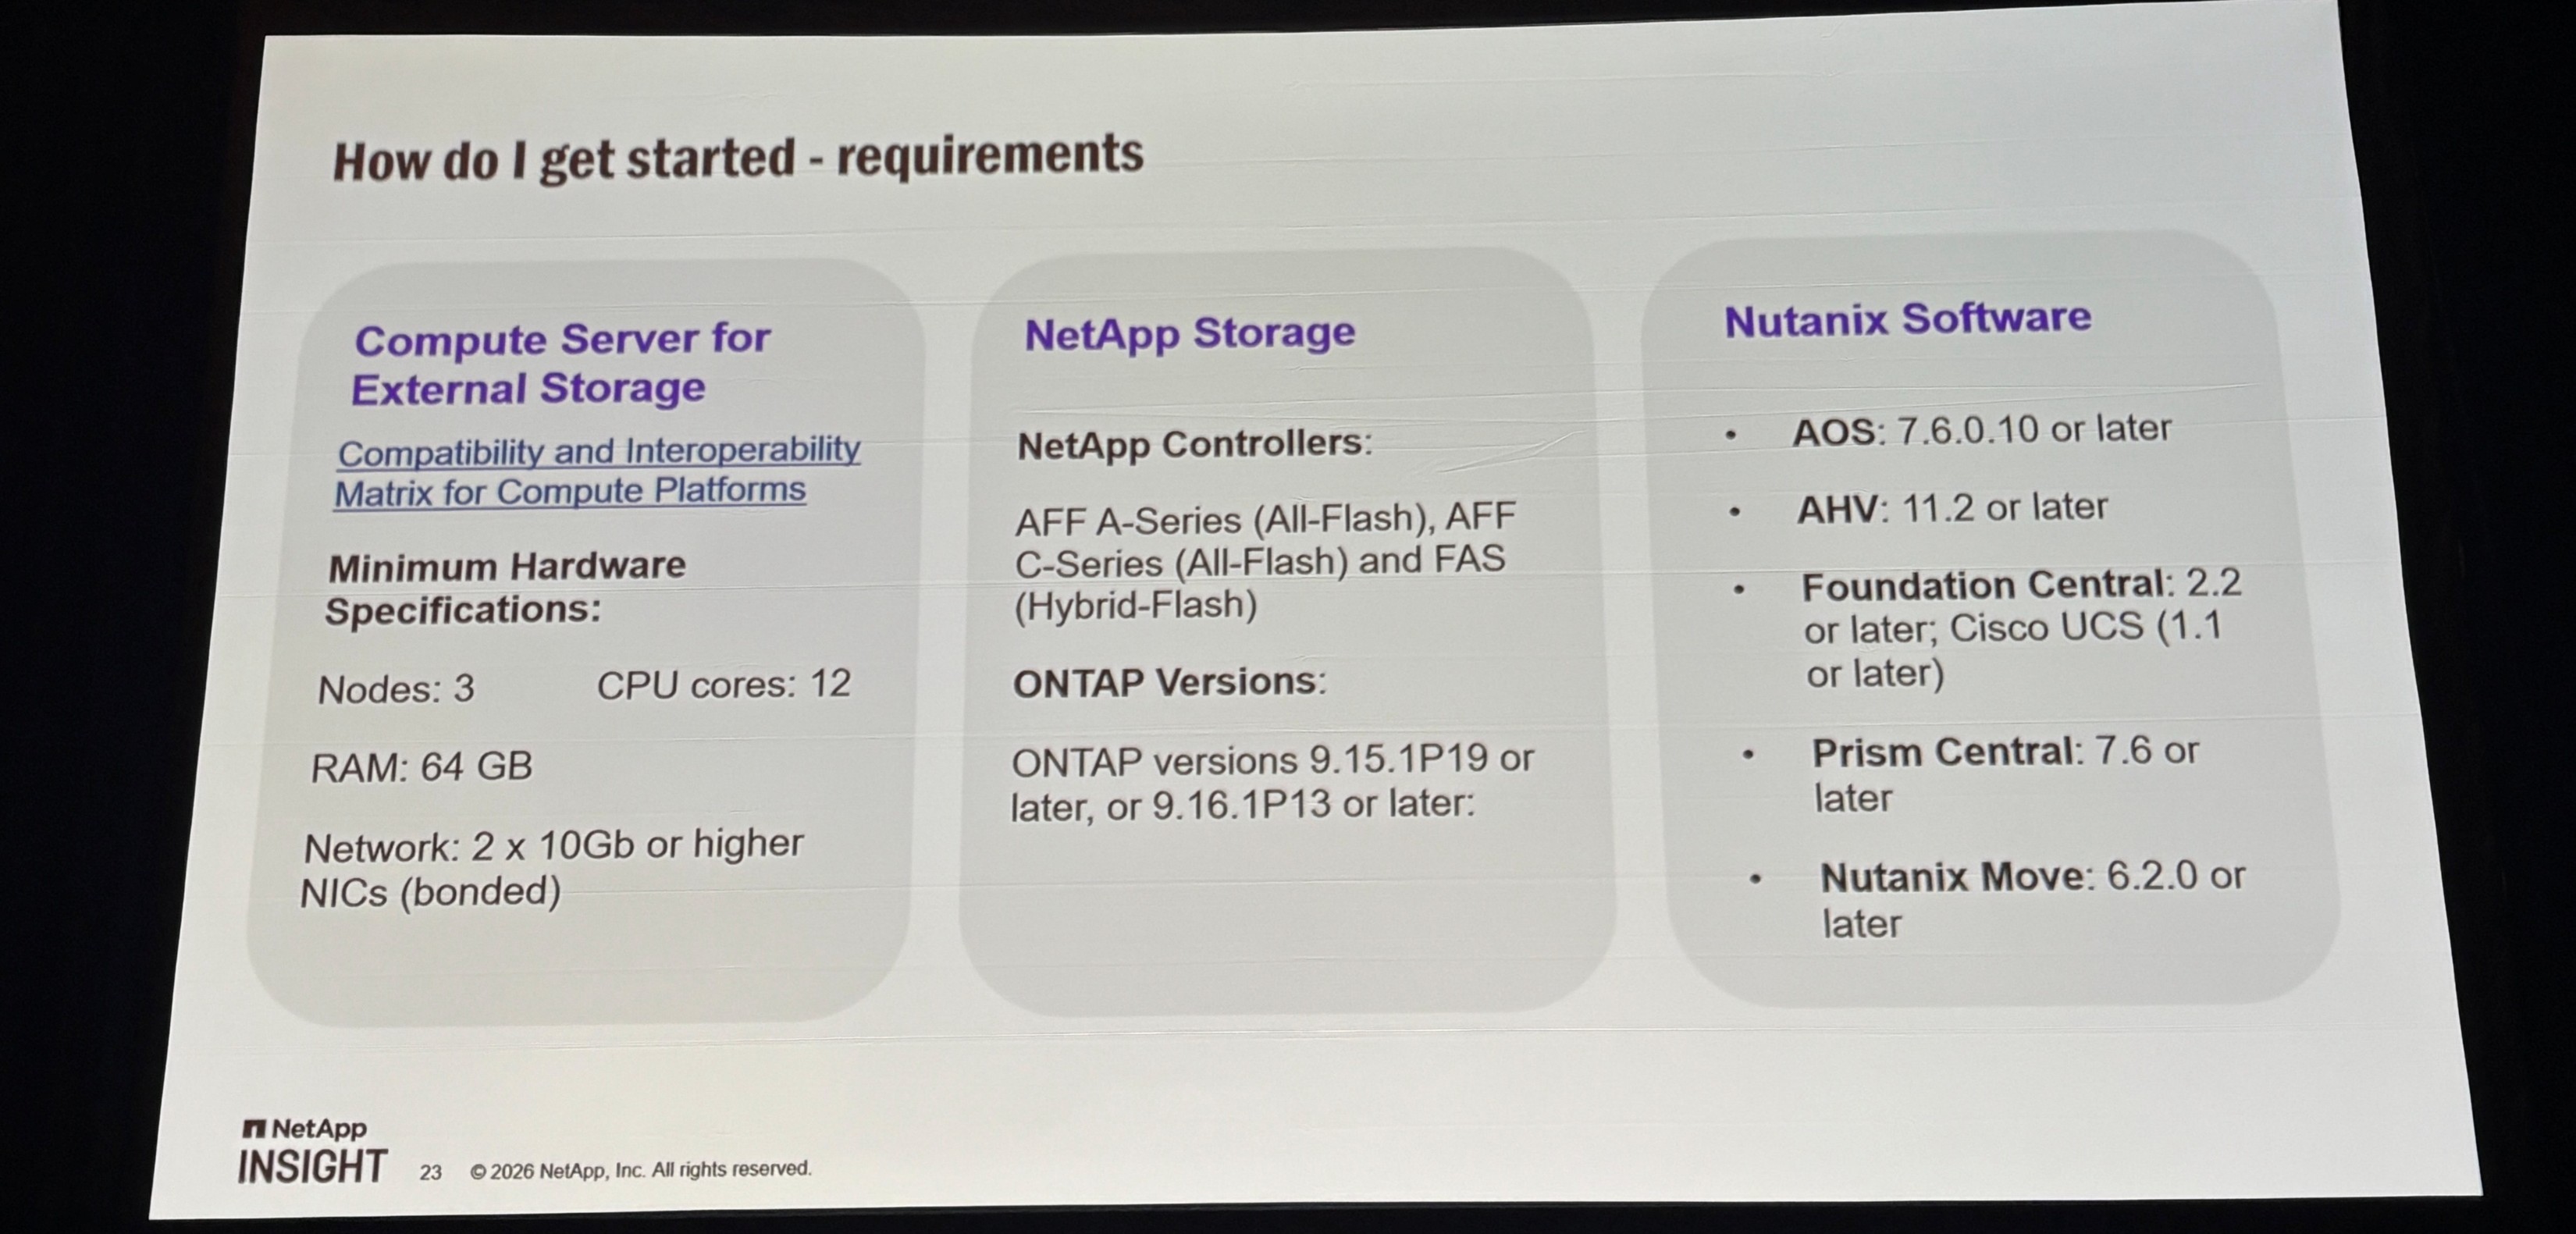
発表時点では、ONTAP 9.15.1P19以降、またはONTAP 9.16.1P13以降が要件とされており、Nutanix側は、AOS 7.6.0.10以降、AHV 11.2以降、Prism Central 7.6以降などが必要です。
この構成の主なメリットは、次の3点です。
-
コンピュートとストレージの独立した拡張
GPUやCPUなどのコンピュートリソースと、ストレージ容量・性能を、それぞれ必要な分だけ追加できます。 -
既存ONTAP資産の活用
既存のAFF/FASを活用しながら、仮想化基盤をNutanix AHVへ移行できます。 -
ONTAPのデータ保護機能
Snapshot、レプリケーション、ARP/AIなど、ONTAPのサイバーレジリエンス機能をNutanix環境でも活用できます。
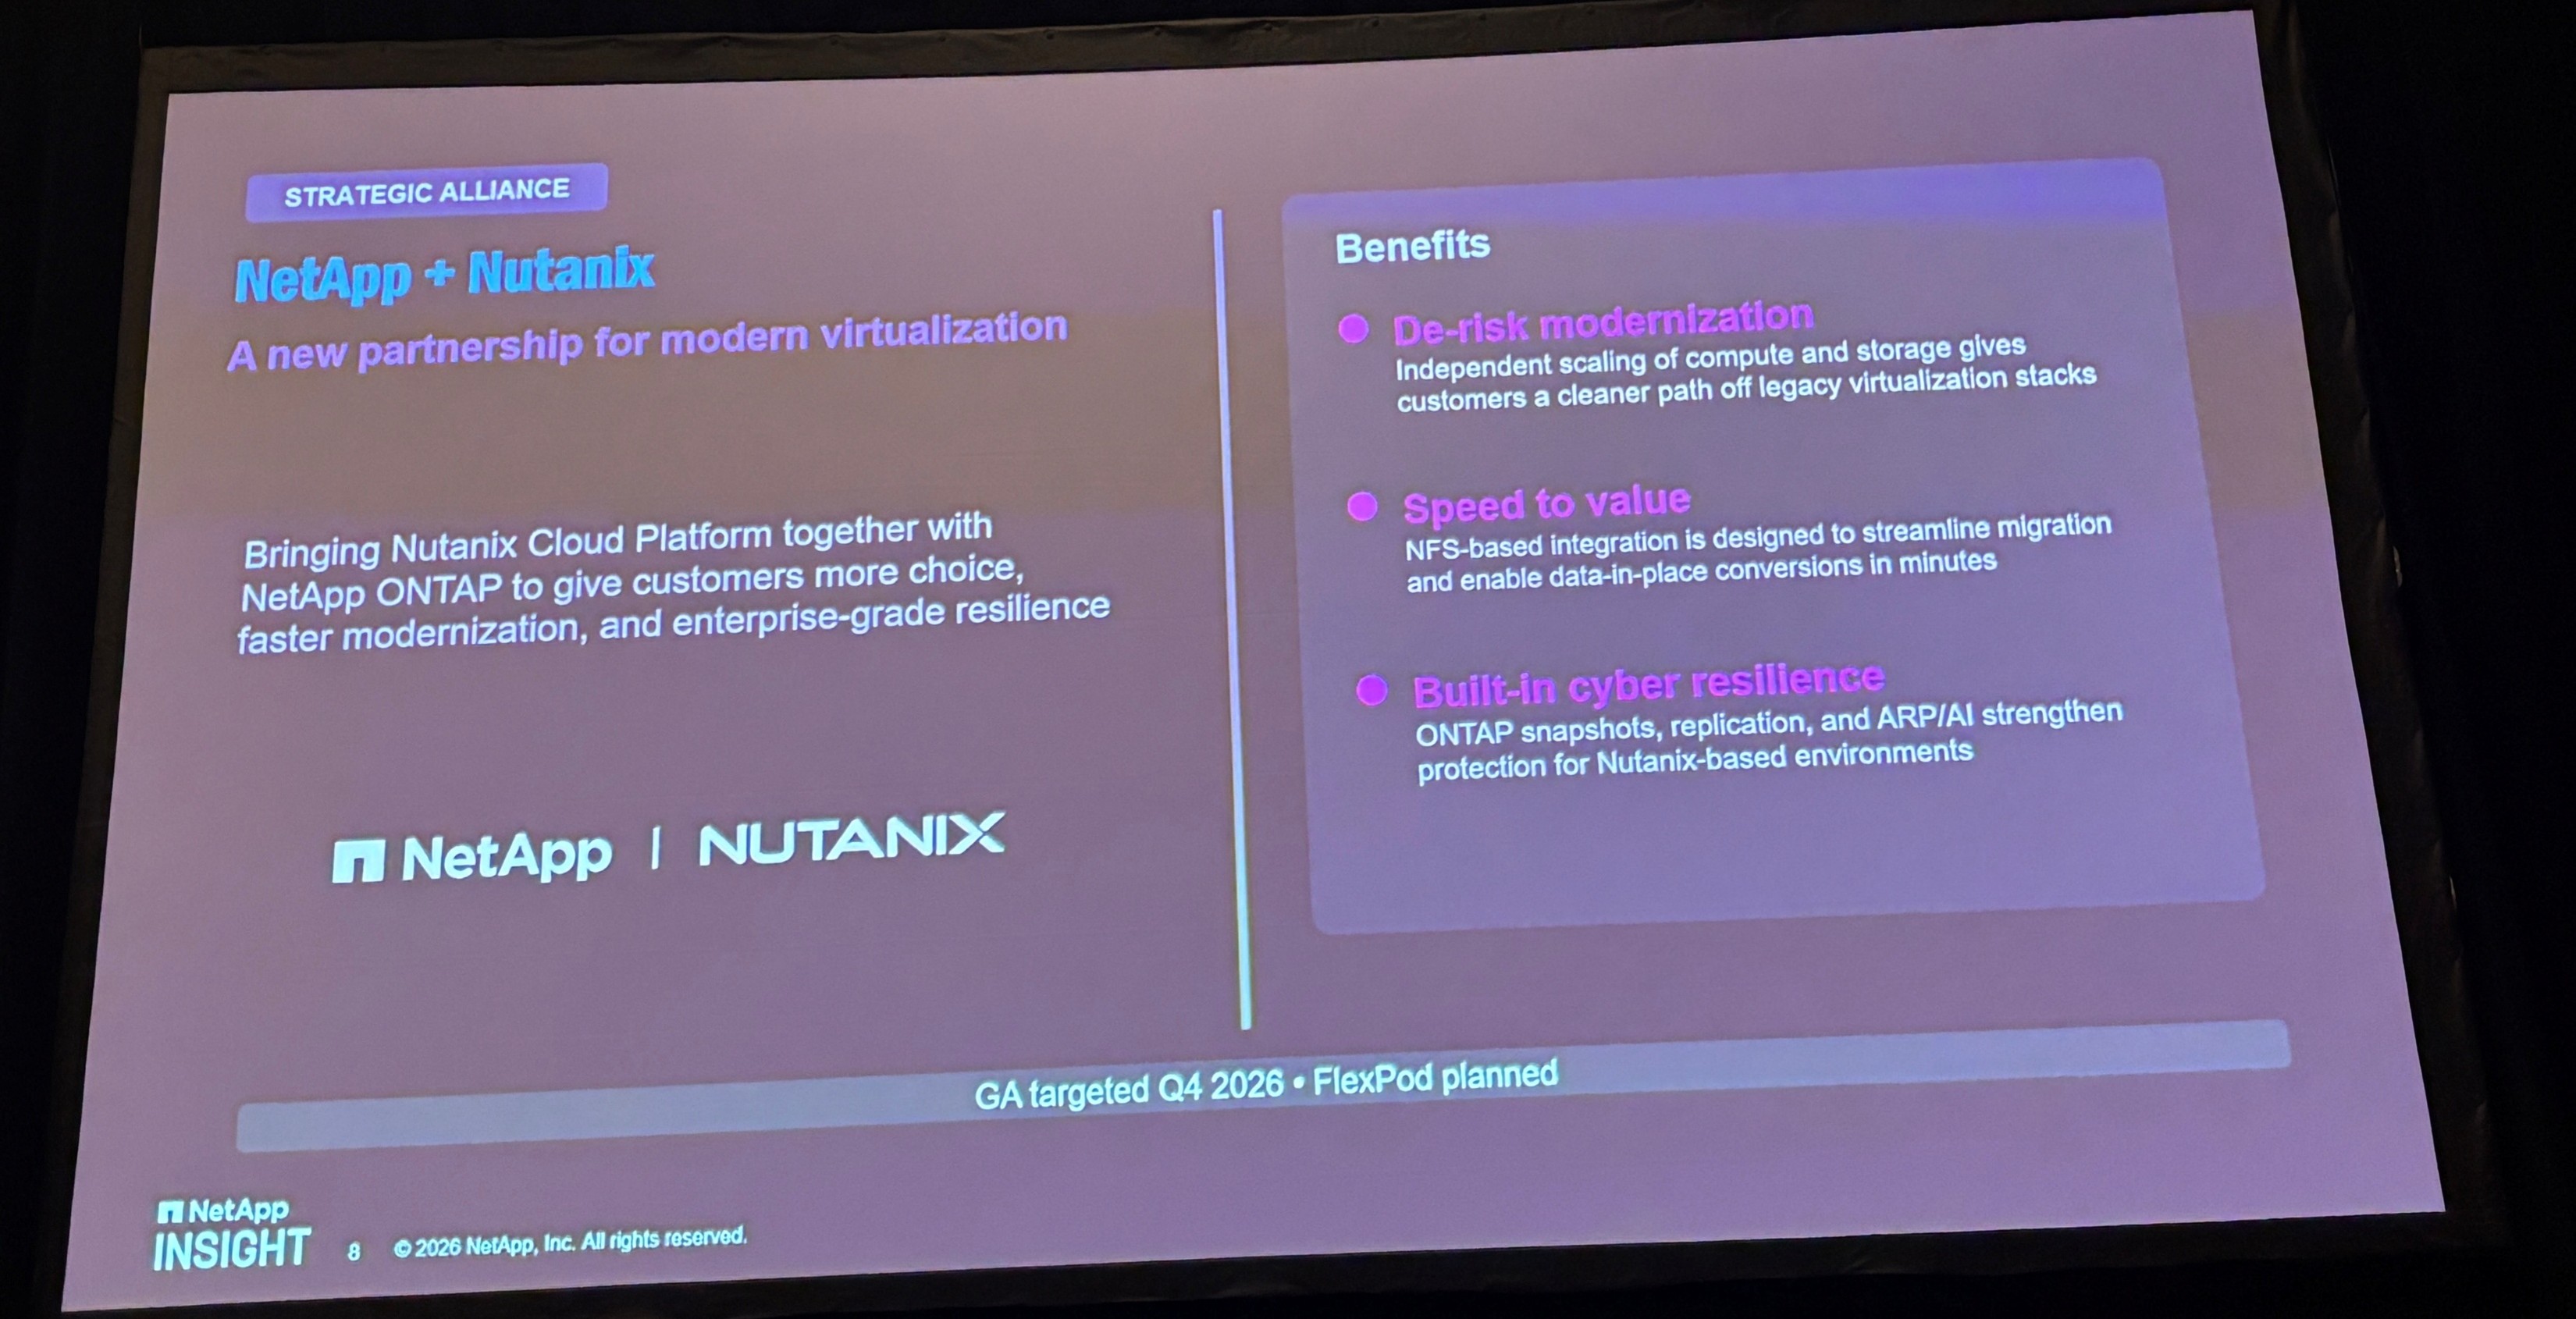
NetAppは、このNFSベースの連携により、既存の仮想化環境からの移行を簡素化し、コンピュートとストレージを分離した柔軟な仮想化基盤を提供すると説明しています。
VMwareからNutanix AHVへの移行
VMware環境からの移行については、NetApp Shift Toolkitの移行先としてNutanixがサポートされる予定であると紹介されました。
Shift Toolkitでは、NetApp NFSデータストア上に配置された仮想マシンを対象に、ストレージ側の機能を活用して仮想ディスクを短時間で変換します。
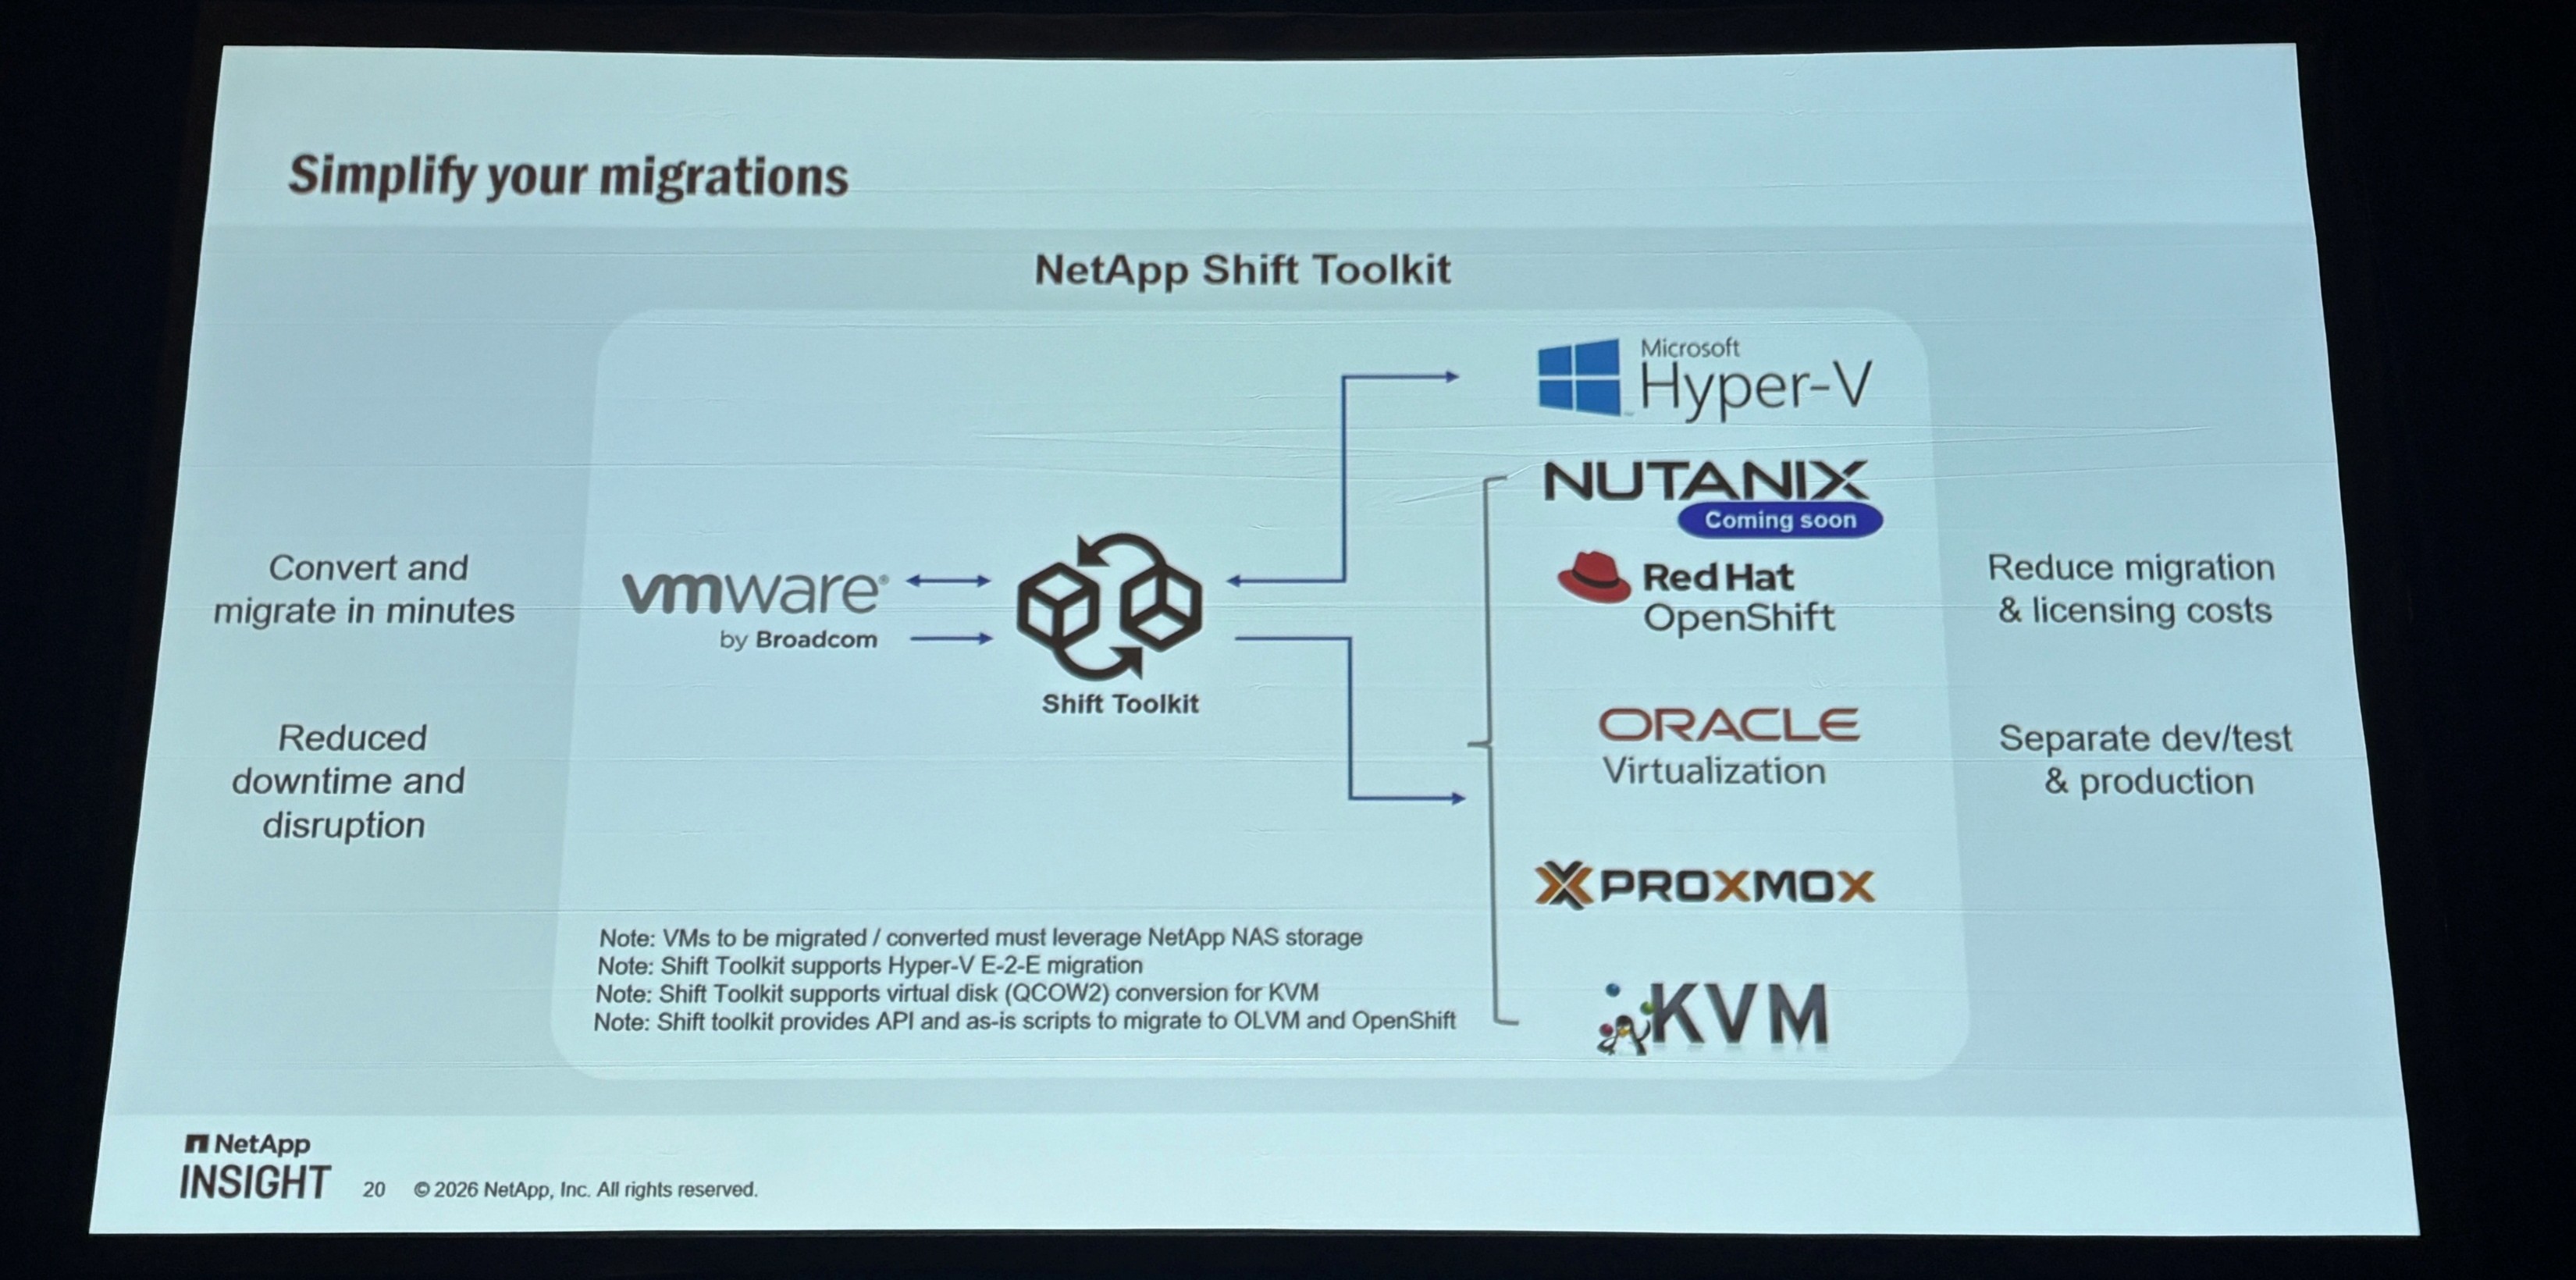
これにより、既存データを大きく移動せずにVMwareからNutanix AHVへ移行し、ダウンタイムや移行作業、ライセンスコストを抑えられる構成を目指していると考えられます。
NetApp Shift Toolkitについて詳細が知りたい方は以下のブログをご覧ください。
「脱VMwareの1つの選択肢!?NetApp Shift Toolkitを利用したエンドツーエンドの仮想マシン移行 ~紹介編~」
※本ソリューション全体のGAは今秋とされており、詳細な情報は入ってきていないため、リリースまでに記載の内容から変更がある可能性があります。
| まとめ |
NetApp INSIGHT 2026では、AIを動かすGPUだけでなく、そのGPUへ正しく、安全に、途切れることなくデータを届けるための基盤が大きなテーマとなりました。
George Kurian氏がDay1で語った「Memory」と「Context」というキーワードは、2日間を通して一貫しています。
- 企業が蓄積してきたデータをMemoryとして守る
- メタデータによってContextを付加する
- AIDEによって既存データをAIから利用できる状態へ変える
- NetApp Consoleによって環境全体を制御する
- Novusによって大規模なGPU環境へデータを供給する
今回の主な発表をまとめると、以下の通りです。
- AIDEを完全なソフトウェア定義型へ移行し、異種データソースへ対象を拡張
- NetApp Consoleを強化し、統合管理、オフサイト版、自然言語操作を提供
- Keystone Sovereignを発表し、データとサポートを同じ地域内で扱う仕組みを追加
- Commvaultとの連携を強化し、脅威の確認からクリーンな復旧までをつなぐ
- NetApp Novusを発表し、100TB/s、ゼタバイト規模、単一Namespaceを目指すAIファクトリー向けアーキテクチャを提示
特にNovusは、単に大きな性能値を掲げた製品ではないことが印象的でした。
私自身、今回の発表を聞くまでは、AI向けストレージではスループットが最も重要だと考えていましたが、実際には数万台のGPUが同時にアクセスする環境では、ファイルの場所や状態を管理するメタデータ処理、障害時の継続性、複数テナントの分離まで含めて設計する必要があることを知り、改めてストレージ選定の難しさと面白さを感じました。
NetAppは、ONTAPで培ってきた信頼性やデータ管理機能を維持しながら、AIファクトリーに必要な規模と並列性へ拡張しようとしています。
Novusが今後どのような形で提供され、実際のAI環境でどこまで性能と運用性を両立できるのか、注目したいと思います。
以上、ラスベガスで開催されたNetApp INSIGHT 2026の超速報レポートでした!

他のおすすめ記事はこちら
著者紹介

SB C&S株式会社
ICT事業本部 技術本部 第1技術統括部 第1技術部 2課
河村 龍 - Ryu Kawamura -